<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://danieltabach.github.io/feed.xml" rel="self" type="application/atom+xml" /><link href="https://danieltabach.github.io/" rel="alternate" type="text/html" /><updated>2026-05-21T23:49:24-04:00</updated><id>https://danieltabach.github.io/feed.xml</id><title type="html">Danny Tabach</title><subtitle>Data Scientist at Chase. I build optimization platforms, design experiments, and translate technical work into business impact.</subtitle><author><name>Danny Tabach</name></author><entry><title type="html">Does Slightly Mean Somewhat? Measuring Vague Intensity Words in LLM Numeric Actions</title><link href="https://danieltabach.github.io/research/does-slightly-mean-somewhat/" rel="alternate" type="text/html" title="Does Slightly Mean Somewhat? Measuring Vague Intensity Words in LLM Numeric Actions" /><published>2026-05-21T00:00:00-04:00</published><updated>2026-05-21T00:00:00-04:00</updated><id>https://danieltabach.github.io/research/does-slightly-mean-somewhat</id><content type="html" xml:base="https://danieltabach.github.io/research/does-slightly-mean-somewhat/"><![CDATA[<p><em>Do language models preserve the ordinal meaning of intensity words when those words must produce numeric actions?</em></p>

<hr />

<h2 id="paper">Paper</h2>

<p><strong><a href="https://arxiv.org/abs/2605.21827">Read the full paper on ArXiv</a></strong></p>

<p><em>Code and data available upon request.</em></p>

<hr />

<h2 id="summary">Summary</h2>

<p>This study asks what happens when vague human language must become a precise LLM action. I built a controlled resource-allocation environment where Claude Haiku receives a natural-language instruction containing an intensity word (e.g., “slightly increase,” “dramatically increase”), produces a numeric allocation via a structured tool call, and a deterministic backend converts that allocation into a measurable outcome. The only variable that changes between runs is the intensity word or the starting system state.</p>

<p>Across 6,620 runs at two temperature settings, three patterns emerge.</p>

<h3 id="compression-10-words-5-outputs">Compression: 10 Words, 5 Outputs</h3>

<p>The model compresses 10 intensity words into 5 distinct median outputs. Four lower-tier words (<em>slightly</em>, <em>marginally</em>, <em>somewhat</em>, <em>mildly</em>) all map to the same value (0.50), while stronger words break into higher regimes. Spearman $\rho = 0.845$ ($p &lt; 0.001$) confirms coarse ordinal structure, but several distinctions a user might expect to matter are collapsed into identical numeric output.</p>

<h3 id="context-dominates-word-choice">Context Dominates Word Choice</h3>

<p>When the current system state is supplied, separate Kruskal-Wallis tests show that grouping by starting allocation captures roughly 10 times more rank-based variance than grouping by word ($\varepsilon^2_{\text{baseline}} = 0.782$ vs. $\varepsilon^2_{\text{word}} = 0.079$). The same word means different things at different starting points. Word choice matters most when the system has headroom and becomes irrelevant as it approaches capacity.</p>

<h3 id="boundary-behavior-hedge-act-abstain">Boundary Behavior: Hedge, Act, Abstain</h3>

<p>At the 89% starting allocation, the model does not merely scale actions downward. It sometimes stops acting entirely. Lower-tier words always act with small adjustments. Several booster-class words (<em>considerably</em>, <em>substantially</em>, <em>significantly</em>) abstain in all 30 runs. The word <em>drastically</em> behaves differently: it pushes to the local ceiling. Near the boundary, the LLM makes a categorical decision about whether to act at all, and that decision depends on which word appeared in the prompt.</p>

<h3 id="what-i-built">What I Built</h3>

<ul>
  <li><strong>Experiment platform:</strong> Python harness with deep-copied session state, checkpoint/resume, deterministic solver backend, structured JSONL output</li>
  <li><strong>Measurement environment:</strong> Synthetic MILP resource-allocation optimizer (30 factories, 3 machine types, 4 task categories), used as a controlled instrument</li>
  <li><strong>Agent layer:</strong> Anthropic SDK tool-use agent with structured tool calls, provider-abstracted LLM client, session isolation (no memory between runs)</li>
  <li><strong>Analysis:</strong> Nonparametric statistics throughout (Kruskal-Wallis, Spearman, effect sizes), no distributional assumptions</li>
  <li><strong>Scale:</strong> 6,620 API calls across two temperature sweeps, 10 intensity words, 10 starting allocations, 30 runs per cell</li>
</ul>

<h3 id="robustness">Robustness</h3>

<p>The core patterns persist across temperature. Raising $T$ from 0.0 to 0.7 broadens distributions but does not restore ordinal distinctions between words. The 10:1 context-over-word variance ratio holds. Abstention patterns shift slightly but the three-mode structure remains.</p>

<hr />

<h2 id="references">References</h2>

<ol>
  <li>Cliff, N. (1959). Adverbs as multipliers. <em>Psychological Review</em>, 66(1), 27-44.</li>
  <li>Quirk, R., Greenbaum, S., Leech, G., &amp; Svartvik, J. (1985). <em>A Comprehensive Grammar of the English Language</em>. Longman.</li>
  <li>Mosteller, F., &amp; Youtz, C. (1990). Quantifying probabilistic expressions. <em>Statistical Science</em>, 5(1), 2-12.</li>
  <li>Ramotowska, S., Szarvas, F., &amp; Szymanik, J. (2024). Quantifier comprehension across languages. <em>Semantics and Pragmatics</em>.</li>
  <li>Zhang, R., et al. (2024). Calibrating LLM probability expressions. <em>arXiv preprint</em>.</li>
</ol>]]></content><author><name>Danny Tabach</name></author><category term="research" /><category term="python" /><category term="experimentation" /><category term="nlp" /><category term="llm-behavior" /><category term="tool-use" /><category term="controlled-experiment" /><summary type="html"><![CDATA[Do language models preserve the ordinal meaning of intensity words when those words must produce numeric actions?]]></summary></entry><entry><title type="html">Can Humans Detect AI? Mining Textual Signals of AI-Assisted Writing Under Varying Scrutiny Conditions</title><link href="https://danieltabach.github.io/research/ai-human-detection/" rel="alternate" type="text/html" title="Can Humans Detect AI? Mining Textual Signals of AI-Assisted Writing Under Varying Scrutiny Conditions" /><published>2026-04-24T00:00:00-04:00</published><updated>2026-04-24T00:00:00-04:00</updated><id>https://danieltabach.github.io/research/ai-human-detection</id><content type="html" xml:base="https://danieltabach.github.io/research/ai-human-detection/"><![CDATA[<p><em>Does the threat of being caught change the way people use AI to write? And if it does, can other people tell the difference?</em></p>

<hr />

<h2 id="paper">Paper</h2>

<p><strong><a href="https://arxiv.org/abs/2604.23471">Read the full paper on ArXiv</a></strong></p>

<p><em>Code and data available upon request.</em></p>

<hr />

<h2 id="summary">Summary</h2>

<p>This study asks whether the threat of AI detection changes how people write with AI, and whether other people can tell the difference. I built a two-phase controlled experiment where 21 participants wrote opinion pieces on remote work using an AI chatbot (Claude). Half were randomly warned that their submission would be scanned by an AI detection tool. The other half received no warning. Both groups had access to the same chatbot.</p>

<p>In Phase 2, 251 independent judges evaluated 1,999 paired comparisons, each time choosing which document in the pair was “written by a human.” Judges were not told that both writers had access to AI.</p>

<h3 id="key-findings">Key Findings</h3>

<p>Across all evaluations, judges selected the warned writer’s document as human <strong>54.13%</strong> of the time versus <strong>45.87%</strong> for the unwarned writer. A two-sided binomial test rejects chance guessing at <strong>p = 0.000243</strong>, and the result holds across both writing stances.</p>

<p>Yet on every measurable text feature I extracted, including AI overlap scores, lexical diversity, sentence structure, and pronoun usage, the two groups were indistinguishable. Four classifiers trained on 10 features could not beat chance. <strong>The judges are picking up on something that feature-based methods do not capture.</strong></p>

<h3 id="counter-intuitive-mechanism">Counter-Intuitive Mechanism</h3>

<p>The warning did not reduce AI use. It <strong>polarized</strong> behavior. Treatment participants took more turns, spent more time, and used more tokens. Several treatment participants abandoned the chatbot entirely and wrote everything themselves. No control participant did this. Yet the submitted text was nearly identical on every measurable feature.</p>

<h3 id="what-i-built">What I Built</h3>

<ul>
  <li><strong>Writer platform:</strong> Streamlit app with 9-stage session flow, Anthropic API (Claude Sonnet) chatbot, 3 column layout (chat, notepad, submission), counterbalanced assignment, soft timer</li>
  <li><strong>Judge platform:</strong> Streamlit app with paired comparison, forced 10 second reading delay, optional document expansion, position randomization</li>
  <li><strong>Backend:</strong> Supabase PostgreSQL with row level security, real time data writes</li>
  <li><strong>Testing:</strong> 29 automated tests (AppTest and pytest), bot dry runs for abuse scenarios (prompt injection, mass token usage)</li>
  <li><strong>Recruitment:</strong> Self funded. \$25 raffle for writers, \$50 raffle for judges. \$100 Reddit ad campaign (32K impressions). Multi platform outreach across Reddit, LinkedIn, WhatsApp, and Instagram.</li>
  <li><strong>Analysis:</strong> Custom AI overlap scoring (trigram overlap, longest common substring, sequence matching), 6 stylometric features, 4 classifiers with SMOTE and stratified CV</li>
</ul>

<h3 id="robustness">Robustness</h3>

<p>The effect strengthens under stricter filtering. Higher confidence judges lean further toward selecting the treatment document. Slower readers detect the signal more reliably. The result is distributed across the document pool, not driven by outliers. Removing the strongest outlier weakens but does not eliminate the effect.</p>

<hr />

<h2 id="references">References</h2>

<ol>
  <li>Callaway, B., &amp; Sant’Anna, P. H. (2021). Difference-in-Differences with multiple time periods. <em>Journal of Econometrics</em>, 225(2), 200-230.</li>
  <li>Sun, L., &amp; Abraham, S. (2021). Estimating dynamic treatment effects in event studies with heterogeneous treatment effects. <em>Journal of Econometrics</em>, 225(2), 175-199.</li>
  <li>Goodman-Bacon, A. (2021). Difference-in-differences with variation in treatment timing. <em>Journal of Econometrics</em>, 225(2), 254-277.</li>
  <li>Bargh, J. A., Chen, M., &amp; Burrows, L. (1996). Automaticity of social behavior. <em>Journal of Personality and Social Psychology</em>, 71(2), 230-244.</li>
  <li>Noy, S., &amp; Zhang, W. (2023). Experimental evidence on the productivity effects of generative AI. <em>Science</em>, 381(6654), 187-192.</li>
</ol>]]></content><author><name>Danny Tabach</name></author><category term="research" /><category term="python" /><category term="experimentation" /><category term="nlp" /><category term="ai-detection" /><category term="controlled-experiment" /><category term="streamlit" /><category term="supabase" /><summary type="html"><![CDATA[Does the threat of being caught change the way people use AI to write? And if it does, can other people tell the difference?]]></summary></entry><entry><title type="html">When Treatment Timing Is Messy: Event-Study Design for Staggered Rollouts</title><link href="https://danieltabach.github.io/applied/staggered-did-event-study/" rel="alternate" type="text/html" title="When Treatment Timing Is Messy: Event-Study Design for Staggered Rollouts" /><published>2026-03-05T00:00:00-05:00</published><updated>2026-03-05T00:00:00-05:00</updated><id>https://danieltabach.github.io/applied/staggered-did-event-study</id><content type="html" xml:base="https://danieltabach.github.io/applied/staggered-did-event-study/"><![CDATA[<p><em>You designed an experiment. Leadership signed off. The rollout took on a life of its own. Now what?</em></p>

<hr />

<h2 id="introduction">Introduction</h2>

<p><em>All data in this post is simulated for demonstrative purposes. No real or proprietary data was used.</em></p>

<p>You work at a company with hundreds of independently operating locations. The data science team designs an experiment: roll out new software to a subset of locations, keep the rest as a control group, and measure the impact on some efficiency metric. Everything is ready to go and the experiment looks sound.</p>

<p>In practice though, large-scale rollouts almost always end up staggered. The rollout was supposed to start in March across all treatment locations simultaneously. Instead, some locations start in March, some in June, and a few don’t start until September. By the end of the year, every treatment location adopted on its own timeline, and there’s no single “before” and “after” to compare.</p>

<p>This is the staggered adoption problem, one of the most common compliance challenges in field experiments. The good news: there’s a well-established framework for handling it.</p>

<p>This post walks through how standard Difference-in-Differences works, where the assumptions break under staggered adoption, and how an approach called “event-study design” fixes it. We’ll cover two scenarios: one where you have a clean holdout control group, and one where every location eventually gets treated. Full code is in the <a href="#appendix-full-code">Appendix</a> if you want to skip the wall of text.</p>

<hr />

<h2 id="what-is-difference-in-differences">What Is Difference-in-Differences?</h2>

<p><strong>Difference-in-Differences (DiD)</strong> compares the <em>change</em> in outcomes for a treatment group to the <em>change</em> for a control group. By subtracting the control group’s trend, you strip out background noise (seasonality, company-wide shifts) and isolate what’s attributable to the intervention. There are a number of great articles that cover the fundamentals well (<a href="https://medium.com/bukalapak-data/difference-in-differences-8c925e691fff">this one from Bukalapak</a> is a solid starting point). The core logic boils down to this:</p>

<table>
  <thead>
    <tr>
      <th> </th>
      <th>Pre-Period</th>
      <th>Post-Period</th>
      <th>Change</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><strong>Treatment</strong></td>
      <td>$Y_{T,pre}$</td>
      <td>$Y_{T,post}$</td>
      <td>$\Delta_T$</td>
    </tr>
    <tr>
      <td><strong>Control</strong></td>
      <td>$Y_{C,pre}$</td>
      <td>$Y_{C,post}$</td>
      <td>$\Delta_C$</td>
    </tr>
    <tr>
      <td><strong>DiD Estimate</strong></td>
      <td> </td>
      <td> </td>
      <td>$\Delta_T - \Delta_C$</td>
    </tr>
  </tbody>
</table>

<p>The key assumption: both groups need to have been trending in the same direction before treatment, the <strong>parallel trends assumption</strong>. If they weren’t, the whole framework falls apart.</p>

<p>DiD works cleanly when the rollout happens all at once. Everyone gets treated on the same day, there’s a clear “before” and “after,” and you can draw a single line between the two periods. In practice, that almost never happens, and that’s where this post picks up.</p>

<hr />

<h2 id="what-does-staggered-adoption-actually-look-like">What Does Staggered Adoption Actually Look Like?</h2>

<p>Let’s look at a case study with single-location examples. For each location, let’s say we have 3 trainees who each need 6 months of training on the new software. Each orange arrow below is one person’s training timeline (for this example, let’s assume in the data they either start/end on the first/last day of the month). There is no single month where treatment switches on. Every location defines its own adoption timeline.</p>

<p><img src="/assets/images/posts/staggered-did/skeleton_staggered.png" alt="Staggered Adoption Skeleton" />
<em>Each trainee is on a different timeline. Some managers start everyone together, others spread it out.</em></p>

<hr />

<h2 id="what-about-using-heuristics">What about using heuristics?</h2>

<p>The natural first instinct is to pick a single cutoff date. Maybe you use the median adoption month, or the month when “most” locations were done. Then you compare everything before that date to everything after.</p>

<p>The problem is: at any given calendar month, your treatment group becomes a <em>mix</em> of locations at completely different stages. Some have been fully operational on the new software for months. Some just finished training. Some haven’t started. When you average across all of them, you’re averaging together strong effects, weak effects, and zero effects. The result is a diluted number that underestimates the real impact.</p>

<p>This is <strong>composition bias</strong>. The mix of locations changes at every time point. At Month 8, your average might include some fully-adopted locations, some mid-training, and some that haven’t started. At Month 14, it’s a completely different mix. You’re not comparing the same metric to itself across time. The composition of your treatment group is shifting underneath you, and that shifting can even flip the directionality of your estimate.</p>

<p><img src="/assets/images/posts/staggered-did/naive-did-problem.png" alt="Naive DiD Problem" />
<em>Top: A naive single-cutoff DiD looks clean but averages across locations at different adoption stages. Bottom: The actual composition of your treatment group shifts over time. A single cutoff blurs all of this together.</em></p>

<hr />

<h2 id="the-fix-normalize-to-event-time">The Fix: Normalize to Event Time</h2>

<p>Instead of forcing a single cutoff, we let each location define its own timeline.</p>

<h3 id="defining-the-adoption-window">Defining the Adoption Window</h3>

<p>For each treatment location, we identify the <strong>adoption window</strong>: the period from when the <em>first</em> trainee completes training to when the <em>last</em> trainee completes training.</p>

<p><img src="/assets/images/posts/staggered-did/pre-zero-post-examples.png" alt="Pre-Period, Period 0, Post-Period Zones" />
<em>The same locations from above, now with the framework overlaid. Red = Pre-Period (baseline), gray = Period 0 (adoption window, blacked out), blue = Post-Period (where we measure the effect).</em></p>

<p>We assume that trends within this ‘period-0’ window are noisy. Some trainees have the new skills, others don’t. The location is in flux. My local Planet Fitness spent weeks renovating to install new machines, with much of the gym closed off. You wouldn’t survey visitors about the new equipment while half the floor is still behind caution tape.</p>

<h3 id="the-three-zones">The Three Zones</h3>

<p>We split each location’s timeline into three zones:</p>

<p><strong>Pre-Period (before the window):</strong> The location before any trainee completed training. This is the baseline. We measure metrics here and call these periods -1, -2, -3, and so on, counting backwards from the adoption window.</p>

<p><strong>Period 0 (the adoption window itself):</strong> We black this out. Don’t measure it or interpret it. Metrics here are a blend of old and new with no clean read.</p>

<p><strong>Post-Period (after the window):</strong> The location after <em>all</em> trainees finished training. This is where we look for the treatment effect. We call these periods +1, +2, +3, counting forward.</p>

<h3 id="the-shift">The Shift</h3>

<p>Every treatment location, regardless of when it actually ramped up, is now on the same relative timeline. Period -3 means “three months before the adoption window started” for every location. Period +2 means “two months after the last trainee finished” for every location.</p>

<p><img src="/assets/images/posts/staggered-did/event-time-normalization.png" alt="Event Time Normalization" />
<em>Top: three locations in calendar time with scattered adoption points. Middle rows: each location shown individually with its pre-period (red), adoption window (gray), and post-period (blue) zones highlighted. Each adoption window spans 6 calendar months. Bottom: after normalizing to event time, all three align at Period 0. Those 6 calendar months collapse to a single period, the same width for every location.</em></p>

<p>The star markers indicate when each location’s first trainee completed training. The middle rows make it clear that each location’s adoption window spans multiple calendar months, and that these windows land at different points in time. The bottom panel shows why this matters: after normalization, every location’s adoption window becomes one standardized period, making the comparison apples to apples.</p>

<hr />

<details>
  <summary><strong>Defining the Window: Why "Last Completion"?</strong></summary>

  <p>There are a few ways you could define the adoption window. It’s worth being explicit about the choice and why it matters.</p>

  <p><strong>Option A: First start to last start.</strong> The window covers when trainees <em>begin</em> training. This makes sense if you’re studying how training disruptions affect operations (trainees pulled from their regular duties, workload shifting to others).</p>

  <p><strong>Option B: First completion to last completion.</strong> This is what we use (with a slight heuristic). The window covers when trainees <em>finish</em> training and can actually contribute using the new software (trainee efficiency after ramp up, is the new software actually helping?). The post-period starts when everyone is fully trained.</p>

  <p><strong>Option C: First start to last completion.</strong> The widest possible window, covering the entire training lifecycle. Useful if you want maximum separation between “definitely no treatment” and “definitely full treatment,” but it has the potential to black out huge chunks of data, and you’ll have to consider normalizing for extended time periods vs. shorter ones.</p>

  <p>In this case example we are going to walk through Option B because the question we’re answering is: <em>does the new software improve the metric?</em> A trainee mid-course isn’t using the software yet. They can’t contribute to the outcome we’re measuring. The post-period should start when <em>everyone</em> can contribute, not when the first person started learning.</p>

  <p>There’s one more wrinkle. If we followed Option B exactly, every location would have a different length of Period 0 (based on how spread out their completions are). To keep things comparable, we set a limit: all completions must fall within a 6-month window from the <em>last</em> completion. This preserves sample size while keeping the period-0 boundary consistent across locations.</p>

  <p><img src="/assets/images/posts/staggered-did/method_options.png" alt="Method Options" />
<em>Options A through C define the adoption window differently. Our “Final Method” adjusts Option B: from the last completion, all other completions must fall within a 6-month window.</em></p>

  <p>If we wanted to measure the impact of disruption on the ecosystem for example, Option A might be more appropriate. The right choice depends on what you’re measuring.</p>

</details>

<hr />

<details>
  <summary><strong>Getting a Clean Sample</strong></summary>

  <p>Trimming the sample feels counterintuitive, but keeping every location regardless of data quality introduces more noise than it removes. We apply three filters, and each one has the same underlying logic: without it, the read is less trustworthy. In a real analysis, each filter should map to a clear business justification, not just a statistical one.</p>

  <h3 id="filter-1-bounded-adoption-window">Filter 1: Bounded Adoption Window</h3>

  <p>If a location’s adoption window stretches beyond 6 months, we set it aside for this analysis. If it took 14 months from first completion to last, the blackout window would eat almost the entire timeline. There wouldn’t be enough clean pre or post data left to measure anything meaningful. Conversely, some windows might be very short (say, all completions within 1 month). We still pad Period 0 to a minimum length so the blackout captures any immediate transition noise rather than letting it leak into the post-period.</p>

  <p>For our simulation, I purposely made the data fall within this window to make it easy. For this case, we assume training itself takes 6 months, and most managers either trained everyone together (adoption window = 0 months) or staggered within a few months. The locations with extremely long adoption windows were the exception.</p>

  <p>This filter has a downside worth noting. By blacking out the entire adoption window, we lose information about what happens during the transition itself. If some trainees are already creating impact while others are still in training, that partial effect gets thrown away. In cases where the transition period IS the thing you want to study (for example, measuring how quickly a team ramps up), a different framework would be more appropriate.</p>

  <p>There’s a potential upside too: novelty effects that inflate early results get absorbed by the blackout window and don’t contaminate the post-period read.</p>

  <h3 id="filter-2-minimum-pre-period-data">Filter 2: Minimum Pre-Period Data</h3>

  <p>In this example, we use at least 6 months of pre-period data for every location. We need to validate that treatment and control locations were trending similarly <em>before</em> adoption. If a location only has 2 months of pre-data, we can’t be certain whether its pre-trend was flat, rising, or falling. That makes the parallel trends test unreliable for that location.</p>

  <p>There’s a more technical reason too. If some locations contribute data at Period -6 and others don’t, the <em>set of locations</em> in your average changes across time periods. That’s composition bias again, the same problem that broke the single-cutoff approach. By requiring every location to have data across the full analysis window, we keep the composition constant. Period -6 and Period +6 contain the exact same set of locations. The comparison then remains apples to apples.</p>

  <h3 id="filter-3-minimum-post-period-data">Filter 3: Minimum Post-Period Data</h3>

  <p>Same logic in the other direction. We need enough post-adoption months to actually measure whether the treatment effect materializes, ramps up, or fades. If we only see one month of post-data, we can’t tell whether the lift is real or just noise from a good month.</p>

  <h3 id="the-tradeoff">The Tradeoff</h3>

  <p>Every filter costs sample size. We’re trading breadth for a cleaner read. The treatment effect we estimate applies to “locations that adopted within a reasonable timeframe and had enough data on both sides.” In DiD, reducing bias before looking at results is the whole point. We normalize as closely as we can before making any comparison.</p>

</details>

<hr />

<h2 id="scenario-a-clean-holdout-control">Scenario A: Clean Holdout Control</h2>

<h3 id="the-setup">The Setup</h3>

<p>This is the simpler case. You designed the experiment with a proper holdout: 120 locations get the new software (still staggered), and 80 locations that never adopt during the observation period. Those 80 locations are the control group for the entire analysis.</p>

<table>
  <thead>
    <tr>
      <th>Group</th>
      <th>Locations</th>
      <th>Role</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Treatment</td>
      <td>120 (staggered adoption)</td>
      <td>Receive software on varying timelines</td>
    </tr>
    <tr>
      <td>Control</td>
      <td>80 (never adopted)</td>
      <td>Our counterfactual: what would have happened without the software?</td>
    </tr>
  </tbody>
</table>

<p>The control group captures background trends at every point in time. For each treatment location at, say, Period +2 (which might land in May for one location and August for another), we compare that metric to the control group’s data at the same calendar month.</p>

<p>Here’s how the concurrent comparison works in practice. The table below shows three treatment locations whose adoption windows <em>close</em> at different months (meaning all trainees finished by that month). At any given calendar month, each location is at a different point in its own event timeline. “Post +2” means that location is 2 months past the end of its adoption window. The key insight: we compare each location to the control group at the <em>same calendar month</em>, not the same event-time period.</p>

<table>
  <thead>
    <tr>
      <th>Calendar Month</th>
      <th>Loc A (window closes M6)</th>
      <th>Loc B (window closes M10)</th>
      <th>Loc C (window closes M14)</th>
      <th>Control Avg</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>M3</td>
      <td>Pre-period</td>
      <td>Pre-period</td>
      <td>Pre-period</td>
      <td>~51</td>
    </tr>
    <tr>
      <td>M8</td>
      <td><strong>Post +2</strong> (compare to control →)</td>
      <td>Pre-period</td>
      <td>Pre-period</td>
      <td>~53</td>
    </tr>
    <tr>
      <td>M12</td>
      <td>Post +6</td>
      <td><strong>Post +2</strong> (compare to control →)</td>
      <td>Pre-period</td>
      <td>~54</td>
    </tr>
    <tr>
      <td>M16</td>
      <td>Post +10</td>
      <td>Post +6</td>
      <td><strong>Post +2</strong> (compare to control →)</td>
      <td>~55</td>
    </tr>
  </tbody>
</table>

<p>Read each row as a snapshot of one calendar month. At M8, Location A is already 2 months past its adoption window (Post +2), while B and C haven’t even started. All three are compared to the same control average at M8. By M16, all three are in their post-period, but at different distances from adoption. The regression sorts this out: location fixed effects absorb baseline differences, time fixed effects absorb calendar-month trends, and the treatment × period interactions isolate the effect at each distance from adoption.</p>

<p>The <strong>parallel trends assumption</strong> is the foundation. Before any treatment happened, were treatment and control locations moving in the same direction at the same rate? If yes, we can attribute the post-adoption divergence to the treatment. If not, the results become harder to interpret.</p>

<h3 id="validating-the-setup">Validating the Setup</h3>

<p>Before looking at the results, we validate that the framework is working.</p>

<p><img src="/assets/images/posts/staggered-did/parallel-trends.png" alt="Parallel Trends" />
<em>Average metric for treatment and control groups over calendar time. The two groups track closely in the pre-treatment period, then diverge after adoption begins.</em></p>

<p>The two groups moved together before treatment started. That’s not <em>proof</em> that the assumption holds in the post-period (it’s fundamentally untestable there), but it’s the best evidence we can get.</p>

<details>
  <summary><strong>Raw Metric Lift</strong></summary>

  <p>Before jumping to regression coefficients, it helps to see the actual metric values. This chart plots the average metric for treatment and control groups at each event-time period:</p>

  <p><img src="/assets/images/posts/staggered-did/scenario-a-raw-lift.png" alt="Scenario A Raw Metric Lift" />
<em>Average metric for treatment vs. control at each event-time period. The gap after Period 0 is the raw treatment effect. Both groups trend similarly in the pre-period, then diverge.</em></p>

  <p>The gap between the two lines after Period 0 is the treatment effect in raw metric units. You can see it building over time as locations become more comfortable with the new software.</p>

  <p>The raw lift shows the treatment effect in plain metric units, but it doesn’t control for location-level baseline differences or calendar-time trends. The event-study regression in the next section adds those controls, producing coefficients with confidence intervals that formally isolate the causal effect.</p>

</details>

<h3 id="event-study-coefficients">Event-Study Coefficients</h3>

<p>The raw lift chart is useful, but it doesn’t control for anything. The event-study regression (details in the <a href="#appendix-the-formal-model">Appendix</a>) formalizes this by running an OLS regression with location fixed effects (comparing each location to itself), time fixed effects (absorbing calendar-month shocks), and a set of treatment × period interaction terms. Each interaction term captures: “for treatment locations at this specific distance from adoption, how much higher is their metric than we’d expect given their own baseline and the calendar-month trend?”</p>

<p>The result is a <strong>regression coefficient</strong> at each relative period. A coefficient of +3.5 at Period +2 means: “two months after the adoption window closed, treatment locations’ metrics were 3.5 units higher than what we’d predict from their historical pattern and the control group’s concurrent trend.” If the model is well-specified, these coefficients isolate the causal effect of the treatment at each distance from adoption.</p>

<details>
  <summary><strong>Behind the Math: How the Regression Isolates the Treatment Effect</strong></summary>

  <h3 id="the-y--mx--b-version">The y = mx + b Version</h3>

  <p>The event-study regression is just <strong>y = mx + b</strong> with a more structured baseline. Here’s how each piece maps:</p>

  <table>
    <thead>
      <tr>
        <th>y = mx + b</th>
        <th>Event-Study</th>
        <th>Plain English</th>
      </tr>
    </thead>
    <tbody>
      <tr>
        <td><strong>y</strong></td>
        <td>$y_{it}$</td>
        <td>The metric you’re measuring for location <em>i</em> at time <em>t</em></td>
      </tr>
      <tr>
        <td><strong>b</strong> (intercept)</td>
        <td>$\alpha_i + \gamma_t$</td>
        <td>Predicted baseline <em>without</em> treatment. Two pieces: this location’s typical level ($\alpha_i$) + this month’s global trend ($\gamma_t$)</td>
      </tr>
      <tr>
        <td><strong>m</strong> (slope)</td>
        <td>$\beta_k$</td>
        <td>Treatment effect at period <em>k</em>: how many extra metric units does treatment add at this distance from adoption?</td>
      </tr>
      <tr>
        <td><strong>x</strong> (variable)</td>
        <td>$D_{ik}$</td>
        <td>A binary flag: “Is this location treated AND at relative period <em>k</em>?” (1 = yes, 0 = no)</td>
      </tr>
    </tbody>
  </table>

  <p>The one twist: instead of a single slope <strong>m</strong>, you get one per period. So the full equation is:</p>

\[y_{it} = \underbrace{\alpha_i + \gamma_t}_{\text{baseline (b)}} + \underbrace{\beta_{-6} D_{-6} + \beta_{-5} D_{-5} + \cdots + \beta_{+6} D_{+6}}_{\text{treatment effects (m} \cdot \text{x, one per period)}} + \varepsilon_{it}\]

  <p>Each $\beta_k$ is one dot on your event-study chart. Pre-period dots near zero mean the baseline prediction was accurate. Post-period dots climbing mean the treatment is working.</p>

  <h3 id="plug-in-example">Plug-In Example</h3>

  <p>Say Location 7 has a typical baseline of 50 ($\alpha_7 = 50$), it’s currently Month 14 which has a global trend of +3 across all locations ($\gamma_{14} = 3$), and the regression estimated that the treatment effect at Period +2 is +4.1 ($\beta_{+2} = 4.1$). Location 7 is treated and currently 2 periods past adoption, so $D_{+2} = 1$:</p>

\[y = \underbrace{50 + 3}_{\text{baseline}} + \underbrace{4.1 \times 1}_{\text{treatment at Period +2}} = 57.1\]

  <p>Without treatment, we’d predict 53 (just the baseline). The observed 57.1 means 4.1 units of lift attributable to the treatment at this point in the post-period. For an untreated location at the same time, all the $D$ flags are 0, so the treatment terms drop out and the prediction is just $50 + 3 = 53$.</p>

  <h3 id="what-each-component-does">What Each Component Does</h3>

  <p><strong>1. Location fixed effects ($\alpha_i$)</strong> — Each location has its own baseline level. Location A might average 60; Location B might average 45. The location fixed effect removes this “who you are” variation so we’re comparing each location to <em>itself</em> over time. Think of it like CUPED’s pre-period adjustment: instead of comparing raw levels across units, you’re looking at how much each location <em>changed</em> relative to its own history.</p>

  <p><strong>2. Time fixed effects ($\gamma_t$)</strong> — Each calendar month has its own average across all locations. Maybe December is always slow, or there’s a company-wide push in Q3 that lifts everyone. Time fixed effects absorb these calendar-driven patterns so they don’t get confused with treatment effects.</p>

  <p><strong>3. Treatment x period interactions ($\beta_k$)</strong> — After removing location baselines and calendar patterns, what’s left? For treated locations at each relative period $k$, the coefficient $\beta_k$ captures how much <em>extra</em> their metric moved beyond what the fixed effects alone would predict. This is the treatment effect at that specific distance from adoption.</p>

  <h3 id="the-code">The Code</h3>

  <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># Event-study regression setup
# y_it = α_i + γ_t + Σ β_k · D_ik + ε_it
</span>
<span class="kn">import</span> <span class="nn">pandas</span> <span class="k">as</span> <span class="n">pd</span>
<span class="kn">import</span> <span class="nn">statsmodels.api</span> <span class="k">as</span> <span class="n">sm</span>

<span class="c1"># Location fixed effects: compare each location to itself
</span><span class="n">loc_fe</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">get_dummies</span><span class="p">(</span><span class="n">df</span><span class="p">[</span><span class="s">'location_id'</span><span class="p">],</span> <span class="n">drop_first</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>

<span class="c1"># Time fixed effects: absorb calendar-month trends
</span><span class="n">time_fe</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">get_dummies</span><span class="p">(</span><span class="n">df</span><span class="p">[</span><span class="s">'calendar_month'</span><span class="p">],</span> <span class="n">drop_first</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>

<span class="c1"># Treatment × period indicators (one column per relative period)
# Only "on" for treated locations at that distance from adoption
</span><span class="n">treat_periods</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">get_dummies</span><span class="p">(</span>
    <span class="n">df</span><span class="p">[</span><span class="s">'rel_period'</span><span class="p">]</span>
<span class="p">).</span><span class="n">multiply</span><span class="p">(</span><span class="n">df</span><span class="p">[</span><span class="s">'treated'</span><span class="p">],</span> <span class="n">axis</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span>

<span class="n">X</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">concat</span><span class="p">([</span><span class="n">loc_fe</span><span class="p">,</span> <span class="n">time_fe</span><span class="p">,</span> <span class="n">treat_periods</span><span class="p">],</span> <span class="n">axis</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
<span class="n">model</span> <span class="o">=</span> <span class="n">sm</span><span class="p">.</span><span class="n">OLS</span><span class="p">(</span><span class="n">df</span><span class="p">[</span><span class="s">'metric'</span><span class="p">],</span> <span class="n">sm</span><span class="p">.</span><span class="n">add_constant</span><span class="p">(</span><span class="n">X</span><span class="p">)).</span><span class="n">fit</span><span class="p">()</span>

<span class="c1"># β_k = coefficients on the treat_period columns
# Each one answers: "At period k relative to adoption,
# how much higher is the treated group's metric than
# the fixed effects alone would predict?"
</span></code></pre></div>  </div>

  <p>The pre-period coefficients ($\beta_{-6}$ through $\beta_{-1}$) should land near zero. If they do, the model’s predicted baseline was accurate before treatment started. That’s what gives us confidence that the post-period coefficients are capturing a real treatment effect, not a pre-existing divergence.</p>

  <h3 id="what-negative-coefficients-tell-you">What Negative Coefficients Tell You</h3>

  <p>In our simulation, the post-period coefficients are positive because the treatment works. But the regression doesn’t assume that. If $\beta_{+3} = -2.0$, it means treated locations are performing 2 units <em>worse</em> than the baseline predicts at that point. The treatment hurt.</p>

  <p>The pre-period is where negative coefficients matter most. If you see $\beta_{-4} = -1.5$ (statistically significant), that’s a red flag: treatment locations were already diverging from control <em>before</em> adoption. Any post-period lift could be a continuation of that pre-existing trend rather than a real treatment effect. The whole framework depends on the pre-period being flat. If it isn’t, the estimate is suspect regardless of what the post-period shows.</p>

  <table>
    <thead>
      <tr>
        <th>Coefficient Pattern</th>
        <th>What It Means</th>
      </tr>
    </thead>
    <tbody>
      <tr>
        <td>Pre-period near zero, post-period positive</td>
        <td>Treatment works. Baseline was accurate, post-period lift is real.</td>
      </tr>
      <tr>
        <td>Pre-period near zero, post-period negative</td>
        <td>Treatment backfired. The intervention made things worse.</td>
      </tr>
      <tr>
        <td>Pre-period trending (positive or negative)</td>
        <td>Parallel trends violated. Can’t trust the post-period estimate either way.</td>
      </tr>
      <tr>
        <td>Pre-period near zero, post-period positive then fading</td>
        <td>Treatment effect wears off over time.</td>
      </tr>
    </tbody>
  </table>

</details>

<p><img src="/assets/images/posts/staggered-did/event-study-plot.png" alt="Event Study Plot" />
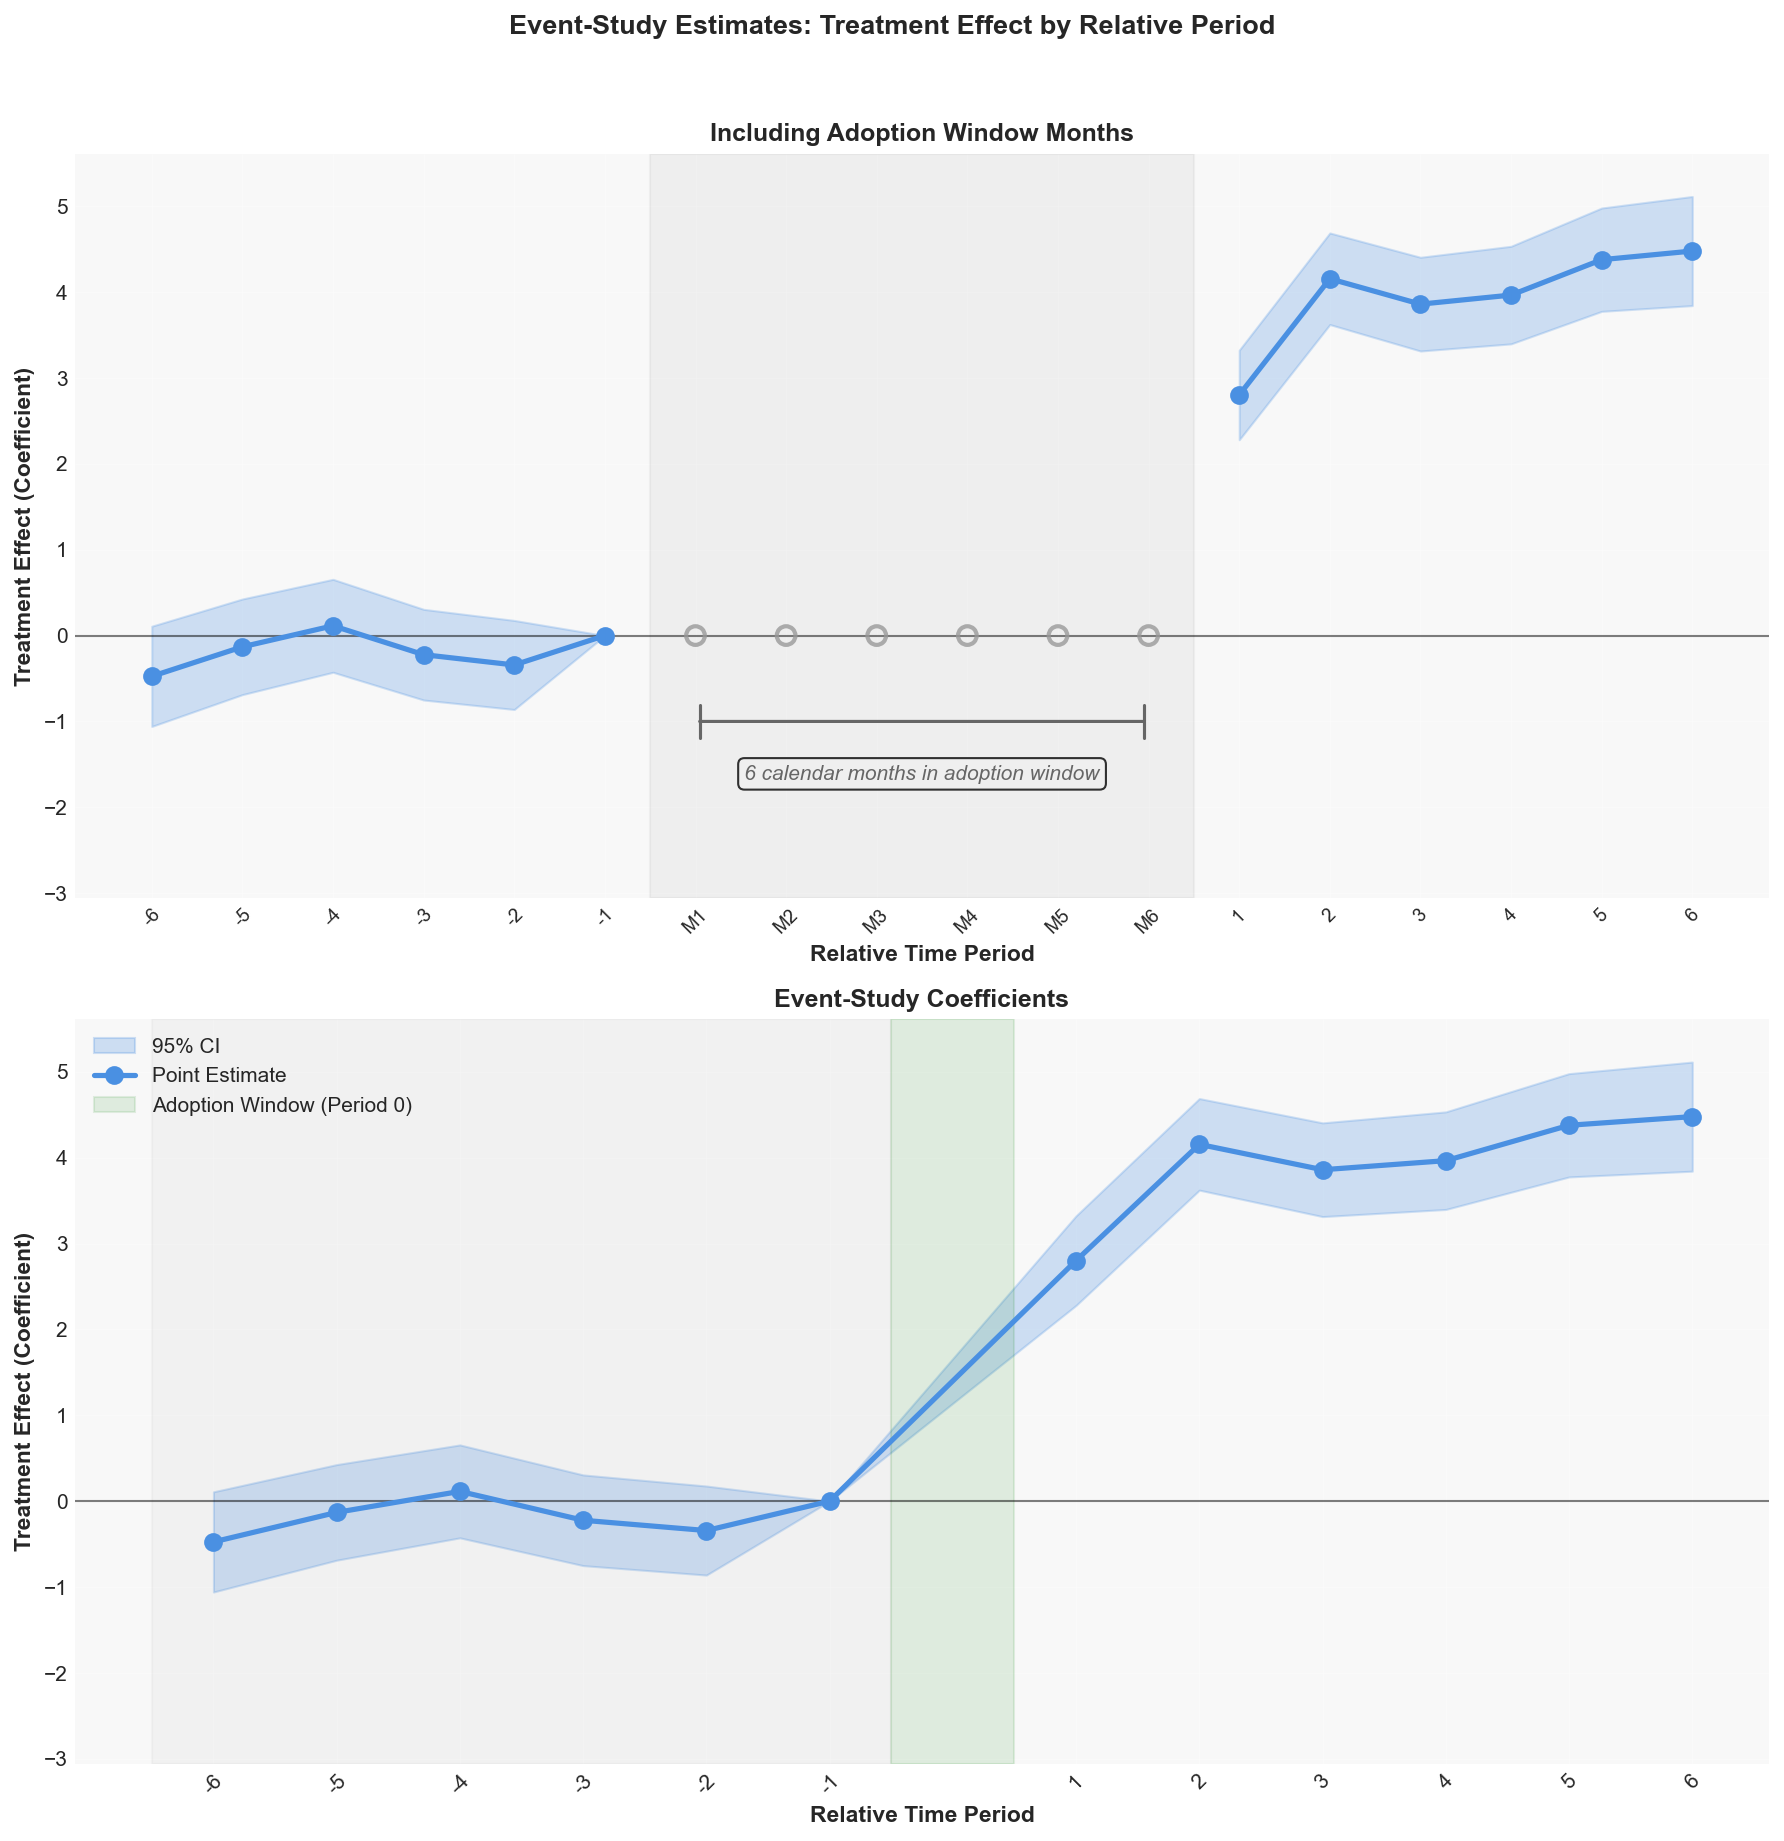
<em>Top: the 6 calendar months that make up Period 0 shown individually (grayed out), showing data that gets excluded. Bottom: the final event-study coefficients with Period 0 condensed to a single band. Pre-period coefficients near zero confirm parallel trends. Post-period coefficients show the treatment effect building over time.</em></p>

<p><strong>Pre-period (Periods -6 to -1):</strong> The coefficients hover near zero and their confidence intervals cross zero. This confirms treatment and control locations were trending the same way <em>before</em> adoption happened.</p>

<p><strong>Post-period (Periods +1 to +6):</strong> The effect starts at about +2.8 in Period +1 and ramps up to about +4.5 by Period +6. This ramp-up pattern makes sense. It takes time for people to get comfortable with a new system.</p>

<h3 id="results">Results</h3>

<table>
  <thead>
    <tr>
      <th>Group</th>
      <th>Pre-Period Avg</th>
      <th>Post-Period Avg</th>
      <th>Change</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Treatment</td>
      <td>53.67</td>
      <td>59.75</td>
      <td>+6.08</td>
    </tr>
    <tr>
      <td>Control</td>
      <td>53.44</td>
      <td>55.54</td>
      <td>+2.10</td>
    </tr>
    <tr>
      <td><strong>DiD Estimate</strong></td>
      <td> </td>
      <td> </td>
      <td><strong>+3.98</strong></td>
    </tr>
  </tbody>
</table>

<p>The treatment group’s metric went up by 6.08. The control group also went up by 2.10 (background trend). The difference-in-differences strips out that background trend: 6.08 - 2.10 = <strong>3.98 units attributable to the treatment</strong>.</p>

<p><img src="/assets/images/posts/staggered-did/treatment-vs-control-lift.png" alt="Treatment vs Control Lift" />
<em>Top: The naive calendar-time view, splitting at the median adoption month. This is misleading because it mixes locations at different adoption stages. Bottom: After normalizing to event time, the treatment effect becomes crisp. The gap after Period 0 builds cleanly as locations settle into the new software.</em></p>

<hr />

<h2 id="scenario-b-everyone-eventually-gets-treated">Scenario B: Everyone Eventually Gets Treated</h2>

<h3 id="the-setup-1">The Setup</h3>

<p>The same normalization framework from Scenario A applies here. Each location still gets its own adoption window, pre-period, and post-period zones. The event-time alignment, the period-0 blackout, the sample filters: all of that carries over. The difference is in how we define the control group.</p>

<p>In practice, your control group doesn’t stay clean forever. Many real rollouts don’t have a permanent holdout. Leadership wants everyone on the new software eventually. Some locations also just start sooner than others.</p>

<p>This is the more common scenario and the one that’s harder to analyze. Every location gets treated. The question becomes: who do you compare the early adopters to?</p>

<p>The answer: locations that haven’t started yet. For each cohort of locations completing adoption in the same month, we define temporary controls as locations that haven’t even begun training by the end of that cohort’s analysis window. They’re “not yet treated” for the entire comparison window, so they serve as clean controls for that specific cohort.</p>

<table>
  <thead>
    <tr>
      <th>Cohort (completing month X)</th>
      <th>Treatment</th>
      <th>Temporary Control</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Locations completing in Month 9</td>
      <td>Those locations</td>
      <td>Locations whose training hasn’t started by Month 15 (leaves 6 months of post-period in the control)</td>
    </tr>
    <tr>
      <td>Locations completing in Month 12</td>
      <td>Those locations</td>
      <td>Locations whose training hasn’t started by Month 18</td>
    </tr>
    <tr>
      <td>Locations completing in Month 15</td>
      <td>Those locations</td>
      <td>Locations whose training hasn’t started by Month 21</td>
    </tr>
  </tbody>
</table>

<p>As more locations adopt, the pool of available control units shrinks. Early cohorts have plenty of not-yet-treated locations to compare against. Late cohorts have fewer. This is a fundamental constraint, not a flaw.</p>

<p><img src="/assets/images/posts/staggered-did/shrinking-controls.png" alt="Shrinking Controls" />
<em>For each cohort month: blue = current treatment locations, red = locations about to start treatment next month (being “shaved off” from the control pool), gray = remaining available controls. The control pool visibly shrinks as adoption progresses.</em></p>

<details>
  <summary><strong>Deep Dive: Why Two-Way Fixed Effects (TWFE) Fails Here</strong></summary>

  <p><strong>Two-Way Fixed Effects (TWFE)</strong> is the standard regression approach for panel data. The idea is simple: include a fixed effect for each location (absorbing permanent differences between units) and one for each time period (absorbing shocks that hit everyone). Then add a single binary treatment indicator, run OLS, and read off its coefficient. For a primer on panel data methods, <a href="https://www.princeton.edu/~otorres/Panel101.pdf">Torres (2007)</a> is a solid starting point.</p>

  <p>When everyone gets treated at the same time, TWFE works great. There’s one clean “before” and one clean “after.” The untreated locations serve as a straightforward comparison group the entire time.</p>

  <p>The problem shows up when adoption is staggered. Consider two locations:</p>

  <ul>
    <li><strong>Location A</strong> adopted in Month 6. By Month 14, it’s been on the new software for 8 months and its metric is elevated.</li>
    <li><strong>Location B</strong> adopted in Month 12. By Month 14, it’s only 2 months in.</li>
  </ul>

  <p>TWFE compares Location B’s post-treatment metric against all other units at that time, including Location A. But Location A’s metric is <em>already inflated</em> by 8 months of treatment. TWFE treats it as a valid comparison anyway. This pulls Location B’s estimated effect downward.</p>

  <p>If the treatment effect is constant over time, this contamination is minor. But if the effect ramps up (as it does in most real rollouts, where people gradually get more comfortable with a new system), the bias grows. Early adopters in their late post-period have large accumulated effects. When TWFE implicitly uses them as “controls” for late adopters, it subtracts those large effects, shrinking or even flipping the estimated coefficient.</p>

  <p><a href="https://doi.org/10.1016/j.jeconom.2020.12.001">Callaway and Sant’Anna (2021)</a> and <a href="https://doi.org/10.1016/j.jeconom.2020.09.006">Sun and Abraham (2021)</a> formalized this problem and showed just how misleading those estimates can be when treatment effects evolve over time.</p>

  <p>Beyond the statistical issues, event-study designs have a practical advantage: they produce period-by-period estimates that are easy to explain to business stakeholders. Showing a chart where the effect ramps up over time tells a story that a single TWFE coefficient can’t. This is what we want to build upon: estimate treatment effects cohort by cohort, using only not-yet-treated units as our control group.</p>

</details>

<h3 id="results-1">Results</h3>

<p>Using the cohort-based approach on simulated data where all 200 locations eventually get treated:</p>

<table>
  <thead>
    <tr>
      <th>Group</th>
      <th>Pre-Period Avg</th>
      <th>Post-Period Avg</th>
      <th>Change</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Treatment (cohort)</td>
      <td>53.02</td>
      <td>59.27</td>
      <td>+6.24</td>
    </tr>
    <tr>
      <td>Control (not-yet-treated)</td>
      <td>52.49</td>
      <td>54.57</td>
      <td>+2.08</td>
    </tr>
    <tr>
      <td><strong>DiD Estimate</strong></td>
      <td> </td>
      <td> </td>
      <td><strong>+4.16</strong></td>
    </tr>
  </tbody>
</table>

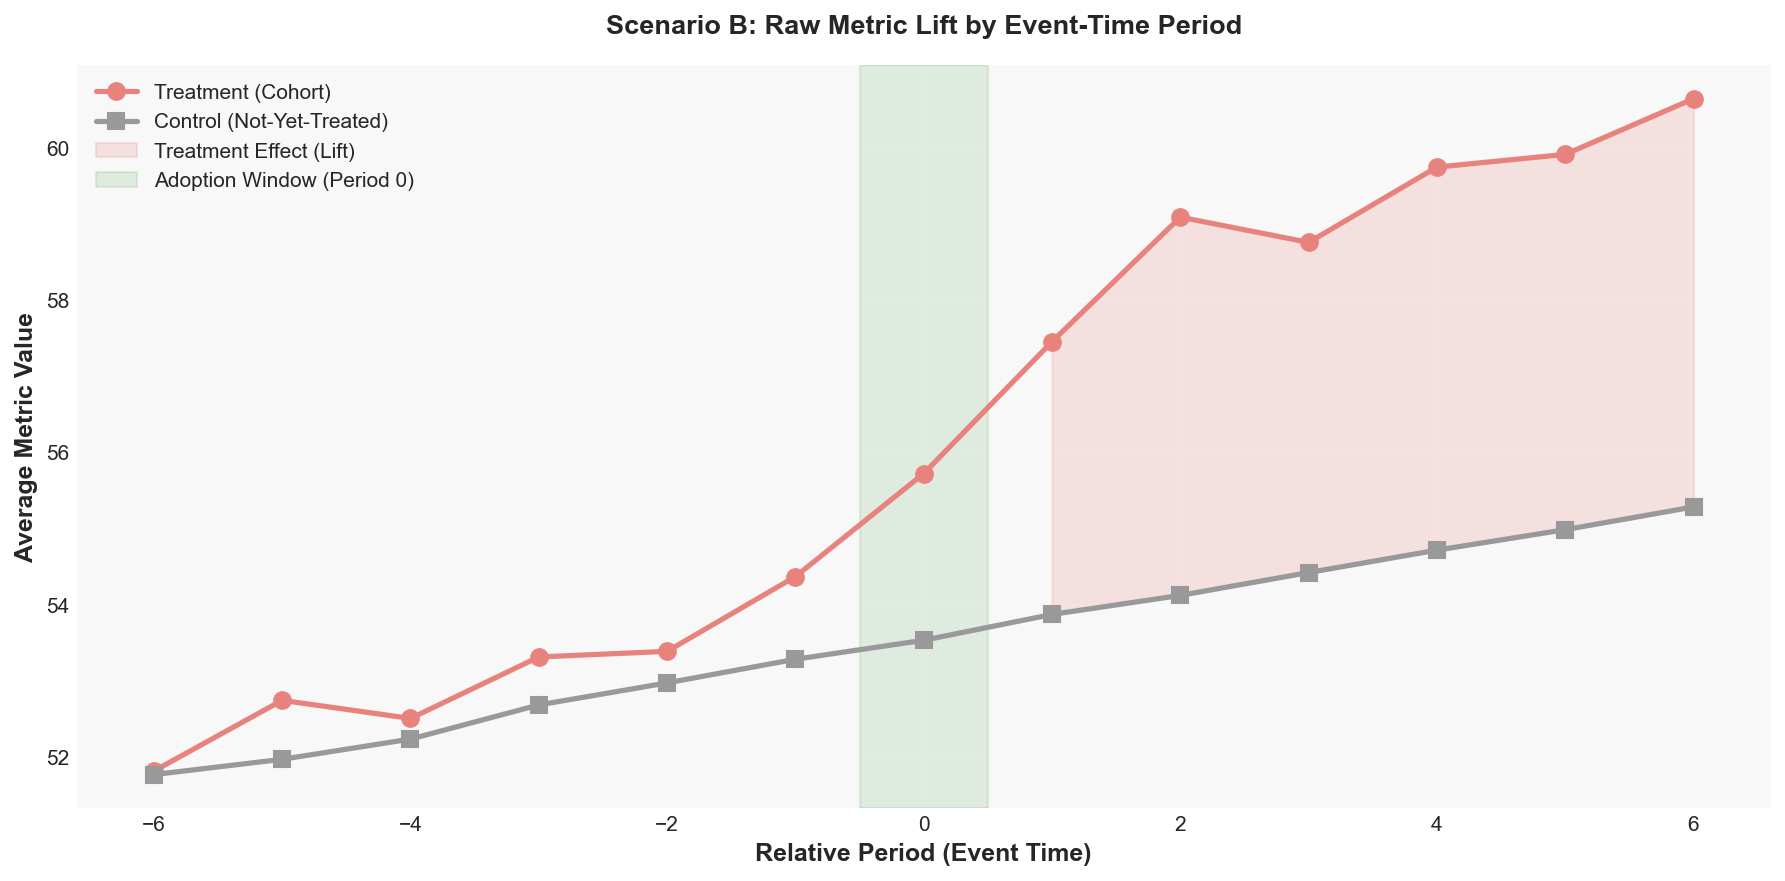
<p><img src="/assets/images/posts/staggered-did/scenario-b-raw-lift.png" alt="Scenario B Raw Metric Lift" />
<em>Average metric for cohort-defined treatment vs. temporary controls at each event-time period. The gap after Period 0 is the raw treatment effect, measured against locations that haven’t started training yet.</em></p>

<p>The raw lift is visible but noisier than Scenario A. The regression coefficients below add location, time, and cohort fixed effects for a cleaner read.</p>

<details>
  <summary><strong>Behind the Math: How Cohort-Based Regression Differs</strong></summary>

  <p>The regression structure is the same as Scenario A, with one addition: <strong>cohort fixed effects</strong>. Each adoption cohort (locations completing in the same month) gets its own intercept. This helps us compare <em>within</em> cohorts: early adopters against their own temporary controls, late adopters against theirs.</p>

  <p>The practical effect: instead of one big regression pooling all locations together, the cohort fixed effects effectively run separate comparisons for each adoption wave and average across them. This prevents early adopters’ elevated metrics from contaminating late adopters’ estimates, the exact problem that TWFE has.</p>

</details>

<p><img src="/assets/images/posts/staggered-did/scenario-b-event-study.png" alt="Scenario B Event Study" />
<em>Event-study coefficients for Scenario B using cohort-defined temporary controls. The pattern is similar to Scenario A: flat pre-period, positive post-period ramp-up. Confidence intervals are wider because the effective control group is smaller.</em></p>

<p><img src="/assets/images/posts/staggered-did/scenario-b-treatment-vs-control.png" alt="Scenario B Treatment vs Control" />
<em>Treatment vs. temporary controls in event time. The gap after Period 0 shows the treatment effect, measured against locations that haven’t started training yet.</em></p>

<p>The estimate recovers the signal, but with wider confidence intervals than Scenario A. That’s expected, and it’s worth understanding why.</p>

<details>
  <summary><strong>Why the Confidence Intervals Are Wider</strong></summary>

  <p>A <strong>confidence interval</strong> tells you the range of values that are plausible given your data. A 95% CI means: if you repeated this experiment many times with new random samples, about 95% of the intervals you’d compute would contain the true effect. Narrower intervals mean more precision. Wider intervals mean more uncertainty.</p>

  <p>In Scenario A, the control group is fixed: the same 80 locations serve as the comparison for every treatment location across the entire timeline. That’s a lot of data anchoring the control group average, which keeps variance low and intervals tight.</p>

  <p>In Scenario B, each cohort defines its <em>own</em> temporary control group. A cohort completing in Month 9 might have 40 controls (locations that haven’t started by Month 15). A cohort completing in Month 15 might only have 15 controls (most locations have started by then). Fewer control units means more variance in the control group average for that cohort, which translates to wider intervals on that cohort’s estimate. The final estimate pools across all cohorts, but it inherits the noise from the noisier ones. The precision you lose is the cost of not having a permanent holdout, and it’s a real tradeoff.</p>

</details>

<h3 id="comparing-the-two-scenarios">Comparing the Two Scenarios</h3>

<p><img src="/assets/images/posts/staggered-did/scenario-comparison.png" alt="Scenario Comparison" />
<em>Side by side: Scenario A (clean holdout, blue) vs Scenario B (cohort controls, red). The dashed line marks the true effect built into the simulation (4.5). Both recover the signal. Scenario A has tighter confidence intervals because the control group is larger and permanent.</em></p>

<hr />

<h2 id="why-some-methods-fall-short">Why some methods fall short</h2>

<p>This is why framework matters. We ran the same simulated data through three different estimation approaches to see how much the choice of method affects the result. Since this is synthetic data, we know the true treatment effect built into the simulation (4.5 units at full ramp-up), so we can measure how far off each approach lands.</p>

<h3 id="approach-a-naive-calendar-cutoff">Approach A: Naive Calendar Cutoff</h3>

<p>Pick the median adoption month, split everything into “before” and “after,” compare treatment to control. This is the simplest possible approach and what most people try first. It systematically underestimates because at any given calendar month, your treatment group includes locations at completely different stages. You’re averaging together real effects with zeros.</p>

<h3 id="approach-b-standard-twfe">Approach B: Standard TWFE</h3>

<p>Run a single regression with location fixed effects, time fixed effects, and one treatment indicator. Unlike the naive approach, this uses each location’s actual adoption date to define “post-treatment.” That’s better than forcing a single cutoff. But it still pools into one average effect, and under staggered timing, already-treated locations implicitly serve as comparisons for late adopters.</p>

<h3 id="approach-c-event-study-design">Approach C: Event-Study Design</h3>

<p>The approach we’ve been building throughout this post. By normalizing each location to its own event time and estimating period-by-period effects, we avoid the composition bias that plagues the other two methods.</p>

<h3 id="the-comparison">The Comparison</h3>

<p><img src="/assets/images/posts/staggered-did/method-comparison.png" alt="Method Comparison" />
<em>The naive calendar cutoff underestimates by about 27%. Standard TWFE closes to about 16% off. The event-study design lands closest, within 12% of the known average treatment effect across all post-periods.</em></p>

<p><img src="/assets/images/posts/staggered-did/method-lift-comparison.png" alt="Method Lift Comparison" />
<em>Same data, three approaches. Panel A uses a single calendar cutoff. Panel B splits treatment into early and late adopters, showing the heterogeneity that TWFE pools into one number. Panel C normalizes to event time, where the treatment effect snaps into focus.</em></p>

<p>The takeaway: the choice of analytical framework isn’t just an academic exercise. On this data, the naive approach underestimated the average treatment effect by about 27%. If you presented that to leadership, you’d be telling them the intervention was significantly less effective than it actually was. The event-study design recovers most of the signal.</p>

<hr />

<h2 id="try-it-yourself">Try It Yourself</h2>

<p>Adjust the parameters below and hit “Run Simulation” to see how staggered adoption affects each estimation method. The simulation generates synthetic data with your chosen settings and compares three approaches: naive calendar cutoff, TWFE, and event-study design.</p>

<div id="did-interactive"></div>

<script src="https://cdn.plot.ly/plotly-2.35.2.min.js" charset="utf-8"></script>

<script src="/assets/js/did-interactive.js"></script>

<p>Try setting the stagger range to 1 month (everyone adopts at roughly the same time) and watch all three methods converge. Then crank it up to 15 months and see the naive estimate fall behind.</p>

<hr />

<h2 id="limitations">Limitations</h2>

<p>No approach covers everything. Here’s what to watch for.</p>

<h3 id="pre-period-contamination">Pre-Period Contamination</h3>

<p>Some trainees are already <em>in</em> training during the pre-period months. If training itself disrupts operations (trainee pulled away for classes, other staff covering, workload shifting), then the pre-period metrics might be slightly depressed compared to a truly untouched baseline. This actually biases your estimate <em>downward</em>: the pre-period looks worse than it would without any training disruption, so the measured lift is smaller than the real lift. If you find a positive effect despite this, the true effect is probably larger.</p>

<h3 id="selection-bias-from-filtering">Selection Bias from Filtering</h3>

<p>By filtering to locations with clean adoption windows and sufficient data, we’re studying a specific subset. Locations that adopted within the expected timeframe might have had smoother operations or stronger management support. The treatment effect for those locations could be higher than what you’d see for locations that had a harder time with adoption. The result speaks to locations that implemented properly, which is still a very useful answer in a lot of business contexts, just not a universal one.</p>

<h3 id="parallel-trends">Parallel Trends</h3>

<p>This is the core assumption behind the whole framework. Treatment and control locations need to have been following the same trajectory before adoption. If they weren’t, any post-adoption divergence could be driven by something other than the treatment. We can check this in the pre-period by looking at whether the two groups were trending together. We can’t prove it holds in the post-period, but if the pre-trends align closely, that’s strong supporting evidence.</p>

<h3 id="scenario-b-shrinking-controls">Scenario B: Shrinking Controls</h3>

<p>In Scenario B, the pool of available controls shrinks as more locations adopt. Late cohorts have fewer not-yet-treated locations to compare against, which means wider confidence intervals and less statistical power. If adoption is fast enough that almost everyone is treated within a few months, there may not be enough clean controls for any cohort.</p>

<h3 id="when-to-use-something-else">When to Use Something Else</h3>

<p>This approach works well when you have treatment timing that varies, you can define a bounded adoption window, you have enough pre and post periods, and the parallel trends assumption is plausible. Consider alternatives when you don’t have a control group (synthetic control methods), when treatment is continuous rather than binary (dose-response models), when adoption timing is endogenous (instrumental variables), or when you have very few treated units.</p>

<hr />

<h2 id="summary">Summary</h2>

<p>When treatment timing varies, standard DiD breaks. Forcing a single cutoff creates composition bias that can dilute or reverse your results.</p>

<p>The fix: normalize to event time. Let each unit define its own adoption window, black out the transition, and measure outcomes relative to each unit’s timeline. The event-study regression gives you period-by-period effects with built-in validation through the flat pre-period test.</p>

<p>Two scenarios, same framework. Clean holdout (Scenario A) gives tighter estimates. Everyone-gets-treated (Scenario B) uses cohort-based temporary controls and is more common in practice. The adoption window threshold is a judgment call, filtering trades sample size for cleaner reads, and parallel trends is the assumption that matters most.</p>

<hr />

<h2 id="references">References</h2>

<ul>
  <li>Callaway, B., &amp; Sant’Anna, P. H. (2021). Difference-in-Differences with multiple time periods. <em>Journal of Econometrics</em>, 225(2), 200-230. <a href="https://doi.org/10.1016/j.jeconom.2020.12.001">Link</a></li>
  <li>Sun, L., &amp; Abraham, S. (2021). Estimating dynamic treatment effects in event studies with heterogeneous treatment effects. <em>Journal of Econometrics</em>, 225(2), 175-199. <a href="https://doi.org/10.1016/j.jeconom.2020.09.006">Link</a></li>
  <li>Goodman-Bacon, A. (2021). Difference-in-differences with variation in treatment timing. <em>Journal of Econometrics</em>, 225(2), 254-277. <a href="https://doi.org/10.1016/j.jeconom.2021.03.014">Link</a></li>
</ul>

<hr />

<h2 id="appendix-the-formal-model">Appendix: The Formal Model</h2>

<details>
  <summary><strong>Event-Study Regression Specification</strong></summary>

  <p>The event-study regression formalizes the period-by-period DiD comparison. The model:</p>

\[Y_{it} = \alpha_i + \gamma_t + \sum_{k \neq -1} \beta_k \cdot D_{it}^{k} + \epsilon_{it}\]

  <p>Here is what each piece means in plain language.</p>

  <p><strong>$Y_{it}$</strong> is the efficiency metric for location $i$ in month $t$.</p>

  <p><strong>$\alpha_i$</strong> is a <strong>location fixed effect</strong>. Each location is compared to itself. Location 101 might naturally run at a higher efficiency than Location 205. The fixed effect absorbs that difference. We’re not comparing Location 101 to Location 205. We’re comparing Location 101 <em>before adoption</em> to Location 101 <em>after adoption</em>.</p>

  <p><strong>$\gamma_t$</strong> is a <strong>time fixed effect</strong>. This absorbs anything that affected <em>all</em> locations in a given month. Maybe December is always slower because of holidays. Maybe there was a system outage in Month 14 that hit everyone. Time fixed effects soak that up.</p>

  <p><strong>$D_{it}^{k}$</strong> is a dummy variable equal to 1 if location $i$ is a treatment location and is in relative period $k$. This is how we isolate the treatment effect at each specific distance from adoption.</p>

  <p><strong>$\beta_k$</strong> is what we care about. These are the <strong>treatment effect coefficients</strong>. $\beta_{+3}$ tells us: “three months after the adoption window closed, how much higher (or lower) was the metric for treatment locations compared to what we’d expect?”</p>

  <p>We omit Period -1 as the reference category. All other $\beta_k$ values are measured relative to the period right before adoption started completing. This gives us a built-in sanity check: the pre-period betas should be near zero.</p>

  <p>For Scenario B, the model adds cohort fixed effects ($\delta_c$) to account for systematic differences across adoption cohorts, and uses cohort-specific treatment/control definitions rather than a permanent control group.</p>

</details>

<hr />

<h2 id="appendix-full-code">Appendix: Full Code</h2>

<p>The complete simulation is below. It generates synthetic panel data for both scenarios, normalizes to event time, runs the event-study regression, and benchmarks against naive and TWFE approaches. You can also <a href="/assets/data/staggered_did_simulation.py">download the script</a> which includes all plotting functions.</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>pip <span class="nb">install </span>numpy pandas matplotlib statsmodels seaborn
python staggered_did_simulation.py
</code></pre></div></div>

<details>
  <summary><strong>1. Generate Synthetic Panel Data (Scenario A)</strong></summary>

  <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">import</span> <span class="nn">pandas</span> <span class="k">as</span> <span class="n">pd</span>
<span class="kn">import</span> <span class="nn">statsmodels.api</span> <span class="k">as</span> <span class="n">sm</span>

<span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">seed</span><span class="p">(</span><span class="mi">42</span><span class="p">)</span>

<span class="k">def</span> <span class="nf">generate_synthetic_data</span><span class="p">():</span>
    <span class="s">"""
    Create a panel dataset of 200 locations over 24 months.
    120 treatment locations adopt new software on staggered
    timelines. 80 control locations never adopt.

    Treatment effect: ramps up over 3 months post-adoption,
    peaking at 4.5 units (3 months * 1.5 per month).
    """</span>
    <span class="n">records</span> <span class="o">=</span> <span class="p">[]</span>

    <span class="c1"># --- Treatment locations (IDs 1 through 120) ---
</span>    <span class="k">for</span> <span class="n">loc_id</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">121</span><span class="p">):</span>
        <span class="c1"># Each location starts adoption in a random month
</span>        <span class="n">adoption_start</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">randint</span><span class="p">(</span><span class="mi">3</span><span class="p">,</span> <span class="mi">16</span><span class="p">)</span>

        <span class="c1"># 1-5 employees per location
</span>        <span class="n">n_employees</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">randint</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">6</span><span class="p">)</span>

        <span class="c1"># 40% train everyone together, 60% stagger
</span>        <span class="k">if</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">random</span><span class="p">()</span> <span class="o">&lt;</span> <span class="mf">0.4</span><span class="p">:</span>
            <span class="n">starts</span> <span class="o">=</span> <span class="p">[</span><span class="n">adoption_start</span><span class="p">]</span> <span class="o">*</span> <span class="n">n_employees</span>
        <span class="k">else</span><span class="p">:</span>
            <span class="n">spread</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">randint</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">4</span><span class="p">)</span>
            <span class="n">starts</span> <span class="o">=</span> <span class="p">[</span>
                <span class="n">adoption_start</span> <span class="o">+</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">randint</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="n">spread</span><span class="p">)</span>
                <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">n_employees</span><span class="p">)</span>
            <span class="p">]</span>

        <span class="c1"># Training takes 6 months per person
</span>        <span class="n">completions</span> <span class="o">=</span> <span class="p">[</span><span class="n">s</span> <span class="o">+</span> <span class="mi">6</span> <span class="k">for</span> <span class="n">s</span> <span class="ow">in</span> <span class="n">starts</span><span class="p">]</span>
        <span class="n">first_completion</span> <span class="o">=</span> <span class="nb">min</span><span class="p">(</span><span class="n">completions</span><span class="p">)</span>
        <span class="n">last_completion</span> <span class="o">=</span> <span class="nb">max</span><span class="p">(</span><span class="n">completions</span><span class="p">)</span>
        <span class="n">window</span> <span class="o">=</span> <span class="n">last_completion</span> <span class="o">-</span> <span class="n">first_completion</span>

        <span class="c1"># Skip locations with adoption windows &gt; 6 months
</span>        <span class="k">if</span> <span class="n">window</span> <span class="o">&gt;</span> <span class="mi">6</span><span class="p">:</span>
            <span class="k">continue</span>

        <span class="k">for</span> <span class="n">month</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">25</span><span class="p">):</span>
            <span class="c1"># Baseline metric with trend and noise
</span>            <span class="n">baseline</span> <span class="o">=</span> <span class="mi">50</span> <span class="o">+</span> <span class="mf">0.3</span> <span class="o">*</span> <span class="n">month</span>
            <span class="n">noise</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">normal</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>

            <span class="c1"># Treatment effect ramps up after first completion
</span>            <span class="n">effect</span> <span class="o">=</span> <span class="mi">0</span>
            <span class="k">if</span> <span class="n">month</span> <span class="o">&gt;=</span> <span class="n">first_completion</span><span class="p">:</span>
                <span class="n">months_post</span> <span class="o">=</span> <span class="nb">min</span><span class="p">(</span>
                    <span class="n">month</span> <span class="o">-</span> <span class="n">first_completion</span> <span class="o">+</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">3</span>
                <span class="p">)</span>
                <span class="n">effect</span> <span class="o">=</span> <span class="n">months_post</span> <span class="o">*</span> <span class="mf">1.5</span>

            <span class="n">records</span><span class="p">.</span><span class="n">append</span><span class="p">({</span>
                <span class="s">'location_id'</span><span class="p">:</span> <span class="n">loc_id</span><span class="p">,</span>
                <span class="s">'month'</span><span class="p">:</span> <span class="n">month</span><span class="p">,</span>
                <span class="s">'metric'</span><span class="p">:</span> <span class="n">baseline</span> <span class="o">+</span> <span class="n">effect</span> <span class="o">+</span> <span class="n">noise</span><span class="p">,</span>
                <span class="s">'treatment'</span><span class="p">:</span> <span class="mi">1</span><span class="p">,</span>
                <span class="s">'first_completion'</span><span class="p">:</span> <span class="n">first_completion</span><span class="p">,</span>
                <span class="s">'last_completion'</span><span class="p">:</span> <span class="n">last_completion</span><span class="p">,</span>
                <span class="s">'adoption_window'</span><span class="p">:</span> <span class="n">window</span><span class="p">,</span>
            <span class="p">})</span>

    <span class="c1"># --- Control locations (IDs 121 through 200) ---
</span>    <span class="k">for</span> <span class="n">loc_id</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="mi">121</span><span class="p">,</span> <span class="mi">201</span><span class="p">):</span>
        <span class="k">for</span> <span class="n">month</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">25</span><span class="p">):</span>
            <span class="n">baseline</span> <span class="o">=</span> <span class="mi">50</span> <span class="o">+</span> <span class="mf">0.3</span> <span class="o">*</span> <span class="n">month</span>
            <span class="n">noise</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">normal</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>

            <span class="n">records</span><span class="p">.</span><span class="n">append</span><span class="p">({</span>
                <span class="s">'location_id'</span><span class="p">:</span> <span class="n">loc_id</span><span class="p">,</span>
                <span class="s">'month'</span><span class="p">:</span> <span class="n">month</span><span class="p">,</span>
                <span class="s">'metric'</span><span class="p">:</span> <span class="n">baseline</span> <span class="o">+</span> <span class="n">noise</span><span class="p">,</span>
                <span class="s">'treatment'</span><span class="p">:</span> <span class="mi">0</span><span class="p">,</span>
                <span class="s">'first_completion'</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">nan</span><span class="p">,</span>
                <span class="s">'last_completion'</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">nan</span><span class="p">,</span>
                <span class="s">'adoption_window'</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">nan</span><span class="p">,</span>
            <span class="p">})</span>

    <span class="k">return</span> <span class="n">pd</span><span class="p">.</span><span class="n">DataFrame</span><span class="p">(</span><span class="n">records</span><span class="p">)</span>
</code></pre></div>  </div>

</details>

<details>
  <summary><strong>2. Normalize to Event Time</strong></summary>

  <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">normalize_to_event_time</span><span class="p">(</span><span class="n">data</span><span class="p">):</span>
    <span class="s">"""
    Convert calendar time to relative event time.

    Treatment locations: event_time = month - first_completion
      Period -3 = three months before first trainee finished
      Period  0 = month of first completion (adoption window)
      Period +2 = two months after last trainee finished

    Control locations: aligned to median treatment timing
    for visualization purposes. The regression uses time
    fixed effects for the actual comparison.
    """</span>
    <span class="n">median_adoption</span> <span class="o">=</span> <span class="n">data</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span>
        <span class="n">data</span><span class="p">[</span><span class="s">'treatment'</span><span class="p">]</span> <span class="o">==</span> <span class="mi">1</span><span class="p">,</span> <span class="s">'first_completion'</span>
    <span class="p">].</span><span class="n">median</span><span class="p">()</span>

    <span class="n">data</span><span class="p">[</span><span class="s">'event_time'</span><span class="p">]</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">nan</span>
    <span class="n">data</span><span class="p">[</span><span class="s">'period'</span><span class="p">]</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">nan</span>

    <span class="c1"># Treatment: relative to their own first_completion
</span>    <span class="n">treat</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span><span class="s">'treatment'</span><span class="p">]</span> <span class="o">==</span> <span class="mi">1</span>
    <span class="n">data</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="n">treat</span><span class="p">,</span> <span class="s">'event_time'</span><span class="p">]</span> <span class="o">=</span> <span class="p">(</span>
        <span class="n">data</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="n">treat</span><span class="p">,</span> <span class="s">'month'</span><span class="p">]</span>
        <span class="o">-</span> <span class="n">data</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="n">treat</span><span class="p">,</span> <span class="s">'first_completion'</span><span class="p">]</span>
    <span class="p">)</span>

    <span class="c1"># Control: relative to median adoption time
</span>    <span class="n">ctrl</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span><span class="s">'treatment'</span><span class="p">]</span> <span class="o">==</span> <span class="mi">0</span>
    <span class="n">data</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="n">ctrl</span><span class="p">,</span> <span class="s">'event_time'</span><span class="p">]</span> <span class="o">=</span> <span class="p">(</span>
        <span class="n">data</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="n">ctrl</span><span class="p">,</span> <span class="s">'month'</span><span class="p">]</span> <span class="o">-</span> <span class="n">median_adoption</span>
    <span class="p">)</span>

    <span class="c1"># Bin into periods -6 through +6
</span>    <span class="n">in_window</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span><span class="s">'event_time'</span><span class="p">].</span><span class="n">between</span><span class="p">(</span><span class="o">-</span><span class="mi">6</span><span class="p">,</span> <span class="mi">6</span><span class="p">)</span>
    <span class="n">data</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="n">in_window</span><span class="p">,</span> <span class="s">'period'</span><span class="p">]</span> <span class="o">=</span> <span class="p">(</span>
        <span class="n">data</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="n">in_window</span><span class="p">,</span> <span class="s">'event_time'</span><span class="p">].</span><span class="n">astype</span><span class="p">(</span><span class="nb">int</span><span class="p">)</span>
    <span class="p">)</span>

    <span class="k">return</span> <span class="n">data</span>
</code></pre></div>  </div>

</details>

<details>
  <summary><strong>3. Event-Study Regression</strong></summary>

  <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">run_event_study_regression</span><span class="p">(</span><span class="n">data</span><span class="p">):</span>
    <span class="s">"""
    Estimate treatment effects at each relative period.

    Model: Y_it = alpha_i + gamma_t + sum(beta_k * D_it^k)

    D_it^k = 1 if location i is treated AND in period k.
    Period -1 is the omitted reference category.
    Pre-period betas near zero = parallel trends confirmed.
    Post-period betas = treatment effect at each distance.
    """</span>
    <span class="n">reg_data</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span>
        <span class="n">data</span><span class="p">[</span><span class="s">'period'</span><span class="p">].</span><span class="n">notna</span><span class="p">()</span>
        <span class="o">&amp;</span> <span class="p">(</span><span class="n">data</span><span class="p">[</span><span class="s">'period'</span><span class="p">]</span> <span class="o">&gt;=</span> <span class="o">-</span><span class="mi">6</span><span class="p">)</span>
        <span class="o">&amp;</span> <span class="p">(</span><span class="n">data</span><span class="p">[</span><span class="s">'period'</span><span class="p">]</span> <span class="o">&lt;=</span> <span class="mi">6</span><span class="p">)</span>
    <span class="p">].</span><span class="n">copy</span><span class="p">()</span>

    <span class="c1"># Treatment x period interaction dummies
</span>    <span class="c1"># Each one isolates the treatment effect at period k
</span>    <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="o">-</span><span class="mi">6</span><span class="p">,</span> <span class="mi">7</span><span class="p">):</span>
        <span class="n">reg_data</span><span class="p">[</span><span class="sa">f</span><span class="s">'period_</span><span class="si">{</span><span class="n">k</span><span class="si">}</span><span class="s">'</span><span class="p">]</span> <span class="o">=</span> <span class="p">(</span>
            <span class="p">(</span><span class="n">reg_data</span><span class="p">[</span><span class="s">'period'</span><span class="p">]</span> <span class="o">==</span> <span class="n">k</span><span class="p">)</span>
            <span class="o">&amp;</span> <span class="p">(</span><span class="n">reg_data</span><span class="p">[</span><span class="s">'treatment'</span><span class="p">]</span> <span class="o">==</span> <span class="mi">1</span><span class="p">)</span>
        <span class="p">).</span><span class="n">astype</span><span class="p">(</span><span class="nb">int</span><span class="p">)</span>

    <span class="c1"># Drop period -1 (reference category)
</span>    <span class="n">reg_data</span> <span class="o">=</span> <span class="n">reg_data</span><span class="p">.</span><span class="n">drop</span><span class="p">(</span><span class="n">columns</span><span class="o">=</span><span class="p">[</span><span class="s">'period_-1'</span><span class="p">])</span>

    <span class="c1"># Fixed effects
</span>    <span class="n">loc_fe</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">get_dummies</span><span class="p">(</span>
        <span class="n">reg_data</span><span class="p">[</span><span class="s">'location_id'</span><span class="p">],</span>
        <span class="n">prefix</span><span class="o">=</span><span class="s">'loc'</span><span class="p">,</span> <span class="n">drop_first</span><span class="o">=</span><span class="bp">True</span>
    <span class="p">)</span>
    <span class="n">time_fe</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">get_dummies</span><span class="p">(</span>
        <span class="n">reg_data</span><span class="p">[</span><span class="s">'month'</span><span class="p">],</span>
        <span class="n">prefix</span><span class="o">=</span><span class="s">'month'</span><span class="p">,</span> <span class="n">drop_first</span><span class="o">=</span><span class="bp">True</span>
    <span class="p">)</span>

    <span class="c1"># Build regression matrix
</span>    <span class="n">period_cols</span> <span class="o">=</span> <span class="p">[</span>
        <span class="sa">f</span><span class="s">'period_</span><span class="si">{</span><span class="n">k</span><span class="si">}</span><span class="s">'</span> <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="o">-</span><span class="mi">6</span><span class="p">,</span> <span class="mi">7</span><span class="p">)</span> <span class="k">if</span> <span class="n">k</span> <span class="o">!=</span> <span class="o">-</span><span class="mi">1</span>
    <span class="p">]</span>
    <span class="n">X</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">concat</span><span class="p">(</span>
        <span class="p">[</span><span class="n">reg_data</span><span class="p">[</span><span class="n">period_cols</span><span class="p">],</span> <span class="n">loc_fe</span><span class="p">,</span> <span class="n">time_fe</span><span class="p">],</span> <span class="n">axis</span><span class="o">=</span><span class="mi">1</span>
    <span class="p">).</span><span class="n">astype</span><span class="p">(</span><span class="nb">float</span><span class="p">)</span>
    <span class="n">X</span> <span class="o">=</span> <span class="n">sm</span><span class="p">.</span><span class="n">add_constant</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">has_constant</span><span class="o">=</span><span class="s">'add'</span><span class="p">)</span>
    <span class="n">Y</span> <span class="o">=</span> <span class="n">reg_data</span><span class="p">[</span><span class="s">'metric'</span><span class="p">].</span><span class="n">astype</span><span class="p">(</span><span class="nb">float</span><span class="p">)</span>

    <span class="n">results</span> <span class="o">=</span> <span class="n">sm</span><span class="p">.</span><span class="n">OLS</span><span class="p">(</span><span class="n">Y</span><span class="p">,</span> <span class="n">X</span><span class="p">).</span><span class="n">fit</span><span class="p">()</span>

    <span class="c1"># Extract coefficients for each period
</span>    <span class="n">coefs</span><span class="p">,</span> <span class="n">ci_lo</span><span class="p">,</span> <span class="n">ci_hi</span> <span class="o">=</span> <span class="p">{},</span> <span class="p">{},</span> <span class="p">{}</span>
    <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="o">-</span><span class="mi">6</span><span class="p">,</span> <span class="mi">7</span><span class="p">):</span>
        <span class="k">if</span> <span class="n">k</span> <span class="o">==</span> <span class="o">-</span><span class="mi">1</span><span class="p">:</span>
            <span class="n">coefs</span><span class="p">[</span><span class="n">k</span><span class="p">],</span> <span class="n">ci_lo</span><span class="p">[</span><span class="n">k</span><span class="p">],</span> <span class="n">ci_hi</span><span class="p">[</span><span class="n">k</span><span class="p">]</span> <span class="o">=</span> <span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">,</span> <span class="mi">0</span>
            <span class="k">continue</span>
        <span class="n">col</span> <span class="o">=</span> <span class="sa">f</span><span class="s">'period_</span><span class="si">{</span><span class="n">k</span><span class="si">}</span><span class="s">'</span>
        <span class="n">coefs</span><span class="p">[</span><span class="n">k</span><span class="p">]</span> <span class="o">=</span> <span class="n">results</span><span class="p">.</span><span class="n">params</span><span class="p">[</span><span class="n">col</span><span class="p">]</span>
        <span class="n">ci</span> <span class="o">=</span> <span class="n">results</span><span class="p">.</span><span class="n">conf_int</span><span class="p">().</span><span class="n">loc</span><span class="p">[</span><span class="n">col</span><span class="p">]</span>
        <span class="n">ci_lo</span><span class="p">[</span><span class="n">k</span><span class="p">],</span> <span class="n">ci_hi</span><span class="p">[</span><span class="n">k</span><span class="p">]</span> <span class="o">=</span> <span class="n">ci</span><span class="p">[</span><span class="mi">0</span><span class="p">],</span> <span class="n">ci</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span>

    <span class="k">return</span> <span class="n">results</span><span class="p">,</span> <span class="n">coefs</span><span class="p">,</span> <span class="n">ci_lo</span><span class="p">,</span> <span class="n">ci_hi</span>
</code></pre></div>  </div>

</details>

<details>
  <summary><strong>4. Scenario B: Cohort-Based Controls</strong></summary>

  <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">generate_scenario_b_data</span><span class="p">(</span><span class="n">n_locations</span><span class="o">=</span><span class="mi">200</span><span class="p">,</span> <span class="n">n_months</span><span class="o">=</span><span class="mi">30</span><span class="p">):</span>
    <span class="s">"""
    All locations eventually get treated. No permanent control.
    Adoption starts staggered across months 3-24.
    Longer timeline (30 months) for late adopters.
    """</span>
    <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">seed</span><span class="p">(</span><span class="mi">42</span><span class="p">)</span>
    <span class="n">records</span> <span class="o">=</span> <span class="p">[]</span>

    <span class="k">for</span> <span class="n">loc_id</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">n_locations</span> <span class="o">+</span> <span class="mi">1</span><span class="p">):</span>
        <span class="n">adoption_start</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">randint</span><span class="p">(</span><span class="mi">3</span><span class="p">,</span> <span class="mi">25</span><span class="p">)</span>
        <span class="n">n_employees</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">randint</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">6</span><span class="p">)</span>

        <span class="k">if</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">random</span><span class="p">()</span> <span class="o">&lt;</span> <span class="mf">0.4</span><span class="p">:</span>
            <span class="n">starts</span> <span class="o">=</span> <span class="p">[</span><span class="n">adoption_start</span><span class="p">]</span> <span class="o">*</span> <span class="n">n_employees</span>
        <span class="k">else</span><span class="p">:</span>
            <span class="n">spread</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">randint</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">4</span><span class="p">)</span>
            <span class="n">starts</span> <span class="o">=</span> <span class="p">[</span>
                <span class="n">adoption_start</span> <span class="o">+</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">randint</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="n">spread</span><span class="p">)</span>
                <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">n_employees</span><span class="p">)</span>
            <span class="p">]</span>

        <span class="n">completions</span> <span class="o">=</span> <span class="p">[</span><span class="n">s</span> <span class="o">+</span> <span class="mi">6</span> <span class="k">for</span> <span class="n">s</span> <span class="ow">in</span> <span class="n">starts</span><span class="p">]</span>
        <span class="n">first_completion</span> <span class="o">=</span> <span class="nb">min</span><span class="p">(</span><span class="n">completions</span><span class="p">)</span>
        <span class="n">last_completion</span> <span class="o">=</span> <span class="nb">max</span><span class="p">(</span><span class="n">completions</span><span class="p">)</span>
        <span class="n">window</span> <span class="o">=</span> <span class="n">last_completion</span> <span class="o">-</span> <span class="n">first_completion</span>

        <span class="k">if</span> <span class="n">window</span> <span class="o">&gt;</span> <span class="mi">6</span><span class="p">:</span>
            <span class="k">continue</span>

        <span class="k">for</span> <span class="n">month</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">n_months</span> <span class="o">+</span> <span class="mi">1</span><span class="p">):</span>
            <span class="n">baseline</span> <span class="o">=</span> <span class="mi">50</span> <span class="o">+</span> <span class="mf">0.3</span> <span class="o">*</span> <span class="n">month</span>
            <span class="n">noise</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">normal</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>
            <span class="n">effect</span> <span class="o">=</span> <span class="mi">0</span>
            <span class="k">if</span> <span class="n">month</span> <span class="o">&gt;=</span> <span class="n">first_completion</span><span class="p">:</span>
                <span class="n">months_post</span> <span class="o">=</span> <span class="nb">min</span><span class="p">(</span>
                    <span class="n">month</span> <span class="o">-</span> <span class="n">first_completion</span> <span class="o">+</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">3</span>
                <span class="p">)</span>
                <span class="n">effect</span> <span class="o">=</span> <span class="n">months_post</span> <span class="o">*</span> <span class="mf">1.5</span>

            <span class="n">records</span><span class="p">.</span><span class="n">append</span><span class="p">({</span>
                <span class="s">'location_id'</span><span class="p">:</span> <span class="n">loc_id</span><span class="p">,</span>
                <span class="s">'month'</span><span class="p">:</span> <span class="n">month</span><span class="p">,</span>
                <span class="s">'metric'</span><span class="p">:</span> <span class="n">baseline</span> <span class="o">+</span> <span class="n">effect</span> <span class="o">+</span> <span class="n">noise</span><span class="p">,</span>
                <span class="s">'first_completion'</span><span class="p">:</span> <span class="n">first_completion</span><span class="p">,</span>
                <span class="s">'adoption_start'</span><span class="p">:</span> <span class="n">adoption_start</span><span class="p">,</span>
            <span class="p">})</span>

    <span class="k">return</span> <span class="n">pd</span><span class="p">.</span><span class="n">DataFrame</span><span class="p">(</span><span class="n">records</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">define_cohort_controls</span><span class="p">(</span><span class="n">data</span><span class="p">,</span> <span class="n">pre_periods</span><span class="o">=</span><span class="mi">6</span><span class="p">,</span>
                           <span class="n">post_periods</span><span class="o">=</span><span class="mi">6</span><span class="p">):</span>
    <span class="s">"""
    For each cohort (locations completing in the same month),
    define temporary controls: locations that haven't started
    treatment by the end of this cohort's analysis window.
    """</span>
    <span class="n">all_cohort_data</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="n">cohort_months</span> <span class="o">=</span> <span class="nb">sorted</span><span class="p">(</span>
        <span class="n">data</span><span class="p">[</span><span class="s">'first_completion'</span><span class="p">].</span><span class="n">dropna</span><span class="p">().</span><span class="n">unique</span><span class="p">()</span>
    <span class="p">)</span>

    <span class="k">for</span> <span class="n">cm</span> <span class="ow">in</span> <span class="n">cohort_months</span><span class="p">:</span>
        <span class="n">cm</span> <span class="o">=</span> <span class="nb">int</span><span class="p">(</span><span class="n">cm</span><span class="p">)</span>
        <span class="n">cohort_ids</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span>
            <span class="n">data</span><span class="p">[</span><span class="s">'first_completion'</span><span class="p">]</span> <span class="o">==</span> <span class="n">cm</span>
        <span class="p">][</span><span class="s">'location_id'</span><span class="p">].</span><span class="n">unique</span><span class="p">()</span>

        <span class="n">window_end</span> <span class="o">=</span> <span class="n">cm</span> <span class="o">+</span> <span class="n">post_periods</span>
        <span class="n">control_ids</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span>
            <span class="n">data</span><span class="p">[</span><span class="s">'adoption_start'</span><span class="p">]</span> <span class="o">&gt;</span> <span class="n">window_end</span>
        <span class="p">][</span><span class="s">'location_id'</span><span class="p">].</span><span class="n">unique</span><span class="p">()</span>

        <span class="k">if</span> <span class="nb">len</span><span class="p">(</span><span class="n">control_ids</span><span class="p">)</span> <span class="o">&lt;</span> <span class="mi">3</span><span class="p">:</span>
            <span class="k">continue</span>

        <span class="n">window_start</span> <span class="o">=</span> <span class="n">cm</span> <span class="o">-</span> <span class="n">pre_periods</span>
        <span class="k">for</span> <span class="n">loc_id</span> <span class="ow">in</span> <span class="n">cohort_ids</span><span class="p">:</span>
            <span class="n">ld</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span>
                <span class="p">(</span><span class="n">data</span><span class="p">[</span><span class="s">'location_id'</span><span class="p">]</span> <span class="o">==</span> <span class="n">loc_id</span><span class="p">)</span>
                <span class="o">&amp;</span> <span class="p">(</span><span class="n">data</span><span class="p">[</span><span class="s">'month'</span><span class="p">].</span><span class="n">between</span><span class="p">(</span><span class="n">window_start</span><span class="p">,</span>
                                         <span class="n">window_end</span><span class="p">))</span>
            <span class="p">].</span><span class="n">copy</span><span class="p">()</span>
            <span class="n">ld</span><span class="p">[</span><span class="s">'cohort'</span><span class="p">]</span> <span class="o">=</span> <span class="n">cm</span>
            <span class="n">ld</span><span class="p">[</span><span class="s">'cohort_treatment'</span><span class="p">]</span> <span class="o">=</span> <span class="mi">1</span>
            <span class="n">fc</span> <span class="o">=</span> <span class="n">ld</span><span class="p">[</span><span class="s">'first_completion'</span><span class="p">].</span><span class="n">iloc</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
            <span class="n">ld</span><span class="p">[</span><span class="s">'event_time'</span><span class="p">]</span> <span class="o">=</span> <span class="n">ld</span><span class="p">[</span><span class="s">'month'</span><span class="p">]</span> <span class="o">-</span> <span class="n">fc</span>
            <span class="n">ld</span><span class="p">[</span><span class="s">'period'</span><span class="p">]</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">where</span><span class="p">(</span>
                <span class="n">ld</span><span class="p">[</span><span class="s">'event_time'</span><span class="p">].</span><span class="n">between</span><span class="p">(</span><span class="o">-</span><span class="n">pre_periods</span><span class="p">,</span>
                                         <span class="n">post_periods</span><span class="p">),</span>
                <span class="n">ld</span><span class="p">[</span><span class="s">'event_time'</span><span class="p">].</span><span class="n">astype</span><span class="p">(</span><span class="nb">int</span><span class="p">),</span> <span class="n">np</span><span class="p">.</span><span class="n">nan</span>
            <span class="p">)</span>
            <span class="n">all_cohort_data</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">ld</span><span class="p">)</span>

        <span class="k">for</span> <span class="n">loc_id</span> <span class="ow">in</span> <span class="n">control_ids</span><span class="p">:</span>
            <span class="n">ld</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span>
                <span class="p">(</span><span class="n">data</span><span class="p">[</span><span class="s">'location_id'</span><span class="p">]</span> <span class="o">==</span> <span class="n">loc_id</span><span class="p">)</span>
                <span class="o">&amp;</span> <span class="p">(</span><span class="n">data</span><span class="p">[</span><span class="s">'month'</span><span class="p">].</span><span class="n">between</span><span class="p">(</span><span class="n">window_start</span><span class="p">,</span>
                                         <span class="n">window_end</span><span class="p">))</span>
            <span class="p">].</span><span class="n">copy</span><span class="p">()</span>
            <span class="n">ld</span><span class="p">[</span><span class="s">'cohort'</span><span class="p">]</span> <span class="o">=</span> <span class="n">cm</span>
            <span class="n">ld</span><span class="p">[</span><span class="s">'cohort_treatment'</span><span class="p">]</span> <span class="o">=</span> <span class="mi">0</span>
            <span class="n">ld</span><span class="p">[</span><span class="s">'event_time'</span><span class="p">]</span> <span class="o">=</span> <span class="n">ld</span><span class="p">[</span><span class="s">'month'</span><span class="p">]</span> <span class="o">-</span> <span class="n">cm</span>
            <span class="n">ld</span><span class="p">[</span><span class="s">'period'</span><span class="p">]</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">where</span><span class="p">(</span>
                <span class="n">ld</span><span class="p">[</span><span class="s">'event_time'</span><span class="p">].</span><span class="n">between</span><span class="p">(</span><span class="o">-</span><span class="n">pre_periods</span><span class="p">,</span>
                                         <span class="n">post_periods</span><span class="p">),</span>
                <span class="n">ld</span><span class="p">[</span><span class="s">'event_time'</span><span class="p">].</span><span class="n">astype</span><span class="p">(</span><span class="nb">int</span><span class="p">),</span> <span class="n">np</span><span class="p">.</span><span class="n">nan</span>
            <span class="p">)</span>
            <span class="n">all_cohort_data</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">ld</span><span class="p">)</span>

    <span class="k">return</span> <span class="n">pd</span><span class="p">.</span><span class="n">concat</span><span class="p">(</span><span class="n">all_cohort_data</span><span class="p">,</span> <span class="n">ignore_index</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
</code></pre></div>  </div>

</details>

<details>
  <summary><strong>5. DiD Summary and Benchmarking</strong></summary>

  <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">compute_did_summary</span><span class="p">(</span><span class="n">data</span><span class="p">):</span>
    <span class="s">"""
    Simple DiD table: pre/post averages for treatment
    and control. Pre = periods -6 to -1, post = +1 to +6.
    """</span>
    <span class="n">analysis</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span>
        <span class="n">data</span><span class="p">[</span><span class="s">'period'</span><span class="p">].</span><span class="n">notna</span><span class="p">()</span> <span class="o">&amp;</span> <span class="p">(</span><span class="n">data</span><span class="p">[</span><span class="s">'period'</span><span class="p">]</span> <span class="o">!=</span> <span class="mi">0</span><span class="p">)</span>
    <span class="p">].</span><span class="n">copy</span><span class="p">()</span>
    <span class="n">analysis</span><span class="p">[</span><span class="s">'post'</span><span class="p">]</span> <span class="o">=</span> <span class="p">(</span><span class="n">analysis</span><span class="p">[</span><span class="s">'period'</span><span class="p">]</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="p">).</span><span class="n">astype</span><span class="p">(</span><span class="nb">int</span><span class="p">)</span>

    <span class="n">summary</span> <span class="o">=</span> <span class="n">analysis</span><span class="p">.</span><span class="n">groupby</span><span class="p">(</span>
        <span class="p">[</span><span class="s">'treatment'</span><span class="p">,</span> <span class="s">'post'</span><span class="p">]</span>
    <span class="p">)[</span><span class="s">'metric'</span><span class="p">].</span><span class="n">mean</span><span class="p">().</span><span class="n">unstack</span><span class="p">()</span>
    <span class="n">summary</span><span class="p">.</span><span class="n">columns</span> <span class="o">=</span> <span class="p">[</span><span class="s">'Pre Avg'</span><span class="p">,</span> <span class="s">'Post Avg'</span><span class="p">]</span>
    <span class="n">summary</span><span class="p">[</span><span class="s">'Change'</span><span class="p">]</span> <span class="o">=</span> <span class="n">summary</span><span class="p">[</span><span class="s">'Post Avg'</span><span class="p">]</span> <span class="o">-</span> <span class="n">summary</span><span class="p">[</span><span class="s">'Pre Avg'</span><span class="p">]</span>
    <span class="n">summary</span><span class="p">.</span><span class="n">index</span> <span class="o">=</span> <span class="p">[</span><span class="s">'Control'</span><span class="p">,</span> <span class="s">'Treatment'</span><span class="p">]</span>

    <span class="n">did</span> <span class="o">=</span> <span class="p">(</span>
        <span class="n">summary</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="s">'Treatment'</span><span class="p">,</span> <span class="s">'Change'</span><span class="p">]</span>
        <span class="o">-</span> <span class="n">summary</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="s">'Control'</span><span class="p">,</span> <span class="s">'Change'</span><span class="p">]</span>
    <span class="p">)</span>
    <span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">"DiD Estimate: </span><span class="si">{</span><span class="n">did</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="s">"</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">summary</span><span class="p">,</span> <span class="n">did</span>


<span class="k">def</span> <span class="nf">run_naive_cutoff</span><span class="p">(</span><span class="n">data</span><span class="p">):</span>
    <span class="s">"""
    Naive approach: single calendar cutoff at the median
    adoption month. Splits all data into before/after.
    Underestimates because of composition bias.
    """</span>
    <span class="n">cutoff</span> <span class="o">=</span> <span class="nb">int</span><span class="p">(</span>
        <span class="n">data</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="n">data</span><span class="p">[</span><span class="s">'treatment'</span><span class="p">]</span> <span class="o">==</span> <span class="mi">1</span><span class="p">,</span> <span class="s">'first_completion'</span><span class="p">]</span>
        <span class="p">.</span><span class="n">median</span><span class="p">()</span>
    <span class="p">)</span>
    <span class="n">pre</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span><span class="n">data</span><span class="p">[</span><span class="s">'month'</span><span class="p">]</span> <span class="o">&lt;</span> <span class="n">cutoff</span><span class="p">]</span>
    <span class="n">post</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span><span class="n">data</span><span class="p">[</span><span class="s">'month'</span><span class="p">]</span> <span class="o">&gt;=</span> <span class="n">cutoff</span><span class="p">]</span>

    <span class="n">treat_change</span> <span class="o">=</span> <span class="p">(</span>
        <span class="n">post</span><span class="p">[</span><span class="n">post</span><span class="p">[</span><span class="s">'treatment'</span><span class="p">]</span> <span class="o">==</span> <span class="mi">1</span><span class="p">][</span><span class="s">'metric'</span><span class="p">].</span><span class="n">mean</span><span class="p">()</span>
        <span class="o">-</span> <span class="n">pre</span><span class="p">[</span><span class="n">pre</span><span class="p">[</span><span class="s">'treatment'</span><span class="p">]</span> <span class="o">==</span> <span class="mi">1</span><span class="p">][</span><span class="s">'metric'</span><span class="p">].</span><span class="n">mean</span><span class="p">()</span>
    <span class="p">)</span>
    <span class="n">ctrl_change</span> <span class="o">=</span> <span class="p">(</span>
        <span class="n">post</span><span class="p">[</span><span class="n">post</span><span class="p">[</span><span class="s">'treatment'</span><span class="p">]</span> <span class="o">==</span> <span class="mi">0</span><span class="p">][</span><span class="s">'metric'</span><span class="p">].</span><span class="n">mean</span><span class="p">()</span>
        <span class="o">-</span> <span class="n">pre</span><span class="p">[</span><span class="n">pre</span><span class="p">[</span><span class="s">'treatment'</span><span class="p">]</span> <span class="o">==</span> <span class="mi">0</span><span class="p">][</span><span class="s">'metric'</span><span class="p">].</span><span class="n">mean</span><span class="p">()</span>
    <span class="p">)</span>
    <span class="k">return</span> <span class="n">treat_change</span> <span class="o">-</span> <span class="n">ctrl_change</span>


<span class="k">def</span> <span class="nf">run_twfe</span><span class="p">(</span><span class="n">data</span><span class="p">):</span>
    <span class="s">"""
    Two-way fixed effects: single treatment coefficient.
    Uses each location's actual adoption date (better than
    naive), but still pools into one average effect.
    Under staggered timing, already-treated locations
    implicitly serve as comparisons for late adopters.
    """</span>
    <span class="n">cutoff</span> <span class="o">=</span> <span class="nb">int</span><span class="p">(</span>
        <span class="n">data</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="n">data</span><span class="p">[</span><span class="s">'treatment'</span><span class="p">]</span> <span class="o">==</span> <span class="mi">1</span><span class="p">,</span> <span class="s">'first_completion'</span><span class="p">]</span>
        <span class="p">.</span><span class="n">median</span><span class="p">()</span>
    <span class="p">)</span>
    <span class="n">reg</span> <span class="o">=</span> <span class="n">data</span><span class="p">.</span><span class="n">copy</span><span class="p">()</span>

    <span class="c1"># Treatment locations: post = after THEIR adoption
</span>    <span class="n">treat</span> <span class="o">=</span> <span class="n">reg</span><span class="p">[</span><span class="s">'treatment'</span><span class="p">]</span> <span class="o">==</span> <span class="mi">1</span>
    <span class="n">reg</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="n">treat</span><span class="p">,</span> <span class="s">'post'</span><span class="p">]</span> <span class="o">=</span> <span class="p">(</span>
        <span class="n">reg</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="n">treat</span><span class="p">,</span> <span class="s">'month'</span><span class="p">]</span>
        <span class="o">&gt;=</span> <span class="n">reg</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="n">treat</span><span class="p">,</span> <span class="s">'first_completion'</span><span class="p">]</span>
    <span class="p">).</span><span class="n">astype</span><span class="p">(</span><span class="nb">int</span><span class="p">)</span>

    <span class="c1"># Control locations: post = after median cutoff
</span>    <span class="n">ctrl</span> <span class="o">=</span> <span class="n">reg</span><span class="p">[</span><span class="s">'treatment'</span><span class="p">]</span> <span class="o">==</span> <span class="mi">0</span>
    <span class="n">reg</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="n">ctrl</span><span class="p">,</span> <span class="s">'post'</span><span class="p">]</span> <span class="o">=</span> <span class="p">(</span>
        <span class="n">reg</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="n">ctrl</span><span class="p">,</span> <span class="s">'month'</span><span class="p">]</span> <span class="o">&gt;=</span> <span class="n">cutoff</span>
    <span class="p">).</span><span class="n">astype</span><span class="p">(</span><span class="nb">int</span><span class="p">)</span>

    <span class="n">reg</span><span class="p">[</span><span class="s">'treat_x_post'</span><span class="p">]</span> <span class="o">=</span> <span class="n">reg</span><span class="p">[</span><span class="s">'treatment'</span><span class="p">]</span> <span class="o">*</span> <span class="n">reg</span><span class="p">[</span><span class="s">'post'</span><span class="p">]</span>

    <span class="c1"># Fixed effects
</span>    <span class="n">loc_fe</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">get_dummies</span><span class="p">(</span>
        <span class="n">reg</span><span class="p">[</span><span class="s">'location_id'</span><span class="p">],</span> <span class="n">prefix</span><span class="o">=</span><span class="s">'loc'</span><span class="p">,</span> <span class="n">drop_first</span><span class="o">=</span><span class="bp">True</span>
    <span class="p">)</span>
    <span class="n">time_fe</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">get_dummies</span><span class="p">(</span>
        <span class="n">reg</span><span class="p">[</span><span class="s">'month'</span><span class="p">],</span> <span class="n">prefix</span><span class="o">=</span><span class="s">'month'</span><span class="p">,</span> <span class="n">drop_first</span><span class="o">=</span><span class="bp">True</span>
    <span class="p">)</span>

    <span class="n">X</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">concat</span><span class="p">(</span>
        <span class="p">[</span><span class="n">reg</span><span class="p">[[</span><span class="s">'treat_x_post'</span><span class="p">]],</span> <span class="n">loc_fe</span><span class="p">,</span> <span class="n">time_fe</span><span class="p">],</span> <span class="n">axis</span><span class="o">=</span><span class="mi">1</span>
    <span class="p">).</span><span class="n">astype</span><span class="p">(</span><span class="nb">float</span><span class="p">)</span>
    <span class="n">X</span> <span class="o">=</span> <span class="n">sm</span><span class="p">.</span><span class="n">add_constant</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">has_constant</span><span class="o">=</span><span class="s">'add'</span><span class="p">)</span>
    <span class="n">Y</span> <span class="o">=</span> <span class="n">reg</span><span class="p">[</span><span class="s">'metric'</span><span class="p">].</span><span class="n">astype</span><span class="p">(</span><span class="nb">float</span><span class="p">)</span>

    <span class="n">model</span> <span class="o">=</span> <span class="n">sm</span><span class="p">.</span><span class="n">OLS</span><span class="p">(</span><span class="n">Y</span><span class="p">,</span> <span class="n">X</span><span class="p">).</span><span class="n">fit</span><span class="p">()</span>
    <span class="k">return</span> <span class="n">model</span><span class="p">.</span><span class="n">params</span><span class="p">[</span><span class="s">'treat_x_post'</span><span class="p">]</span>


<span class="c1"># --- Run everything ---
</span><span class="n">data</span> <span class="o">=</span> <span class="n">generate_synthetic_data</span><span class="p">()</span>
<span class="n">data</span> <span class="o">=</span> <span class="n">normalize_to_event_time</span><span class="p">(</span><span class="n">data</span><span class="p">)</span>

<span class="n">results</span><span class="p">,</span> <span class="n">coefs</span><span class="p">,</span> <span class="n">ci_lo</span><span class="p">,</span> <span class="n">ci_hi</span> <span class="o">=</span> <span class="n">run_event_study_regression</span><span class="p">(</span><span class="n">data</span><span class="p">)</span>
<span class="n">summary</span><span class="p">,</span> <span class="n">did</span> <span class="o">=</span> <span class="n">compute_did_summary</span><span class="p">(</span><span class="n">data</span><span class="p">)</span>

<span class="n">naive</span> <span class="o">=</span> <span class="n">run_naive_cutoff</span><span class="p">(</span><span class="n">data</span><span class="p">)</span>
<span class="n">twfe</span> <span class="o">=</span> <span class="n">run_twfe</span><span class="p">(</span><span class="n">data</span><span class="p">)</span>
<span class="n">event_study_avg</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">mean</span><span class="p">([</span><span class="n">coefs</span><span class="p">[</span><span class="n">k</span><span class="p">]</span> <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="n">coefs</span> <span class="k">if</span> <span class="n">k</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="p">])</span>
<span class="n">true_effect</span> <span class="o">=</span> <span class="mf">4.5</span>  <span class="c1"># Built into the simulation
</span>
<span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">"</span><span class="se">\n</span><span class="s">Naive:       </span><span class="si">{</span><span class="n">naive</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="s"> (</span><span class="si">{</span><span class="p">((</span><span class="n">naive</span><span class="o">-</span><span class="n">true_effect</span><span class="p">)</span><span class="o">/</span><span class="n">true_effect</span><span class="p">)</span><span class="o">*</span><span class="mi">100</span><span class="si">:</span><span class="o">+</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s">% bias)"</span><span class="p">)</span>
<span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">"TWFE:        </span><span class="si">{</span><span class="n">twfe</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="s"> (</span><span class="si">{</span><span class="p">((</span><span class="n">twfe</span><span class="o">-</span><span class="n">true_effect</span><span class="p">)</span><span class="o">/</span><span class="n">true_effect</span><span class="p">)</span><span class="o">*</span><span class="mi">100</span><span class="si">:</span><span class="o">+</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s">% bias)"</span><span class="p">)</span>
<span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">"Event-Study: </span><span class="si">{</span><span class="n">event_study_avg</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="s"> (</span><span class="si">{</span><span class="p">((</span><span class="n">event_study_avg</span><span class="o">-</span><span class="n">true_effect</span><span class="p">)</span><span class="o">/</span><span class="n">true_effect</span><span class="p">)</span><span class="o">*</span><span class="mi">100</span><span class="si">:</span><span class="o">+</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s">% bias)"</span><span class="p">)</span>
<span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">"True Effect: </span><span class="si">{</span><span class="n">true_effect</span><span class="si">}</span><span class="s">"</span><span class="p">)</span>
</code></pre></div>  </div>

  <p>Uses <code class="language-plaintext highlighter-rouge">np.random.seed(42)</code> for reproducibility. The <a href="/assets/data/staggered_did_simulation.py">full script</a> includes all plotting functions and the Scenario B simulation.</p>

</details>]]></content><author><name>Danny Tabach</name></author><category term="applied" /><category term="python" /><category term="causal-inference" /><category term="difference-in-differences" /><category term="event-study" /><category term="econometrics" /><summary type="html"><![CDATA[You designed an experiment. Leadership signed off. The rollout took on a life of its own. Now what? Introduction All data in this post is simulated for demonstrative purposes. No real or proprietary data was used. You work at a company with hundreds of independently operating locations. The data science team designs an experiment: roll out new software to a subset of locations, keep the rest as a control group, and measure the impact on some efficiency metric. Everything is ready to go and the experiment looks sound. In practice though, large-scale rollouts almost always end up staggered. The rollout was supposed to start in March across all treatment locations simultaneously. Instead, some locations start in March, some in June, and a few don’t start until September. By the end of the year, every treatment location adopted on its own timeline, and there’s no single “before” and “after” to compare. This is the staggered adoption problem, one of the most common compliance challenges in field experiments. The good news: there’s a well-established framework for handling it. This post walks through how standard Difference-in-Differences works, where the assumptions break under staggered adoption, and how an approach called “event-study design” fixes it. We’ll cover two scenarios: one where you have a clean holdout control group, and one where every location eventually gets treated. Full code is in the Appendix if you want to skip the wall of text. What Is Difference-in-Differences? Difference-in-Differences (DiD) compares the change in outcomes for a treatment group to the change for a control group. By subtracting the control group’s trend, you strip out background noise (seasonality, company-wide shifts) and isolate what’s attributable to the intervention. There are a number of great articles that cover the fundamentals well (this one from Bukalapak is a solid starting point). The core logic boils down to this:   Pre-Period Post-Period Change Treatment $Y_{T,pre}$ $Y_{T,post}$ $\Delta_T$ Control $Y_{C,pre}$ $Y_{C,post}$ $\Delta_C$ DiD Estimate     $\Delta_T - \Delta_C$ The key assumption: both groups need to have been trending in the same direction before treatment, the parallel trends assumption. If they weren’t, the whole framework falls apart. DiD works cleanly when the rollout happens all at once. Everyone gets treated on the same day, there’s a clear “before” and “after,” and you can draw a single line between the two periods. In practice, that almost never happens, and that’s where this post picks up. What Does Staggered Adoption Actually Look Like? Let’s look at a case study with single-location examples. For each location, let’s say we have 3 trainees who each need 6 months of training on the new software. Each orange arrow below is one person’s training timeline (for this example, let’s assume in the data they either start/end on the first/last day of the month). There is no single month where treatment switches on. Every location defines its own adoption timeline. Each trainee is on a different timeline. Some managers start everyone together, others spread it out. What about using heuristics? The natural first instinct is to pick a single cutoff date. Maybe you use the median adoption month, or the month when “most” locations were done. Then you compare everything before that date to everything after. The problem is: at any given calendar month, your treatment group becomes a mix of locations at completely different stages. Some have been fully operational on the new software for months. Some just finished training. Some haven’t started. When you average across all of them, you’re averaging together strong effects, weak effects, and zero effects. The result is a diluted number that underestimates the real impact. This is composition bias. The mix of locations changes at every time point. At Month 8, your average might include some fully-adopted locations, some mid-training, and some that haven’t started. At Month 14, it’s a completely different mix. You’re not comparing the same metric to itself across time. The composition of your treatment group is shifting underneath you, and that shifting can even flip the directionality of your estimate. Top: A naive single-cutoff DiD looks clean but averages across locations at different adoption stages. Bottom: The actual composition of your treatment group shifts over time. A single cutoff blurs all of this together. The Fix: Normalize to Event Time Instead of forcing a single cutoff, we let each location define its own timeline. Defining the Adoption Window For each treatment location, we identify the adoption window: the period from when the first trainee completes training to when the last trainee completes training. The same locations from above, now with the framework overlaid. Red = Pre-Period (baseline), gray = Period 0 (adoption window, blacked out), blue = Post-Period (where we measure the effect). We assume that trends within this ‘period-0’ window are noisy. Some trainees have the new skills, others don’t. The location is in flux. My local Planet Fitness spent weeks renovating to install new machines, with much of the gym closed off. You wouldn’t survey visitors about the new equipment while half the floor is still behind caution tape. The Three Zones We split each location’s timeline into three zones: Pre-Period (before the window): The location before any trainee completed training. This is the baseline. We measure metrics here and call these periods -1, -2, -3, and so on, counting backwards from the adoption window. Period 0 (the adoption window itself): We black this out. Don’t measure it or interpret it. Metrics here are a blend of old and new with no clean read. Post-Period (after the window): The location after all trainees finished training. This is where we look for the treatment effect. We call these periods +1, +2, +3, counting forward. The Shift Every treatment location, regardless of when it actually ramped up, is now on the same relative timeline. Period -3 means “three months before the adoption window started” for every location. Period +2 means “two months after the last trainee finished” for every location. Top: three locations in calendar time with scattered adoption points. Middle rows: each location shown individually with its pre-period (red), adoption window (gray), and post-period (blue) zones highlighted. Each adoption window spans 6 calendar months. Bottom: after normalizing to event time, all three align at Period 0. Those 6 calendar months collapse to a single period, the same width for every location. The star markers indicate when each location’s first trainee completed training. The middle rows make it clear that each location’s adoption window spans multiple calendar months, and that these windows land at different points in time. The bottom panel shows why this matters: after normalization, every location’s adoption window becomes one standardized period, making the comparison apples to apples. Defining the Window: Why "Last Completion"? There are a few ways you could define the adoption window. It’s worth being explicit about the choice and why it matters. Option A: First start to last start. The window covers when trainees begin training. This makes sense if you’re studying how training disruptions affect operations (trainees pulled from their regular duties, workload shifting to others). Option B: First completion to last completion. This is what we use (with a slight heuristic). The window covers when trainees finish training and can actually contribute using the new software (trainee efficiency after ramp up, is the new software actually helping?). The post-period starts when everyone is fully trained. Option C: First start to last completion. The widest possible window, covering the entire training lifecycle. Useful if you want maximum separation between “definitely no treatment” and “definitely full treatment,” but it has the potential to black out huge chunks of data, and you’ll have to consider normalizing for extended time periods vs. shorter ones. In this case example we are going to walk through Option B because the question we’re answering is: does the new software improve the metric? A trainee mid-course isn’t using the software yet. They can’t contribute to the outcome we’re measuring. The post-period should start when everyone can contribute, not when the first person started learning. There’s one more wrinkle. If we followed Option B exactly, every location would have a different length of Period 0 (based on how spread out their completions are). To keep things comparable, we set a limit: all completions must fall within a 6-month window from the last completion. This preserves sample size while keeping the period-0 boundary consistent across locations. Options A through C define the adoption window differently. Our “Final Method” adjusts Option B: from the last completion, all other completions must fall within a 6-month window. If we wanted to measure the impact of disruption on the ecosystem for example, Option A might be more appropriate. The right choice depends on what you’re measuring. Getting a Clean Sample Trimming the sample feels counterintuitive, but keeping every location regardless of data quality introduces more noise than it removes. We apply three filters, and each one has the same underlying logic: without it, the read is less trustworthy. In a real analysis, each filter should map to a clear business justification, not just a statistical one. Filter 1: Bounded Adoption Window If a location’s adoption window stretches beyond 6 months, we set it aside for this analysis. If it took 14 months from first completion to last, the blackout window would eat almost the entire timeline. There wouldn’t be enough clean pre or post data left to measure anything meaningful. Conversely, some windows might be very short (say, all completions within 1 month). We still pad Period 0 to a minimum length so the blackout captures any immediate transition noise rather than letting it leak into the post-period. For our simulation, I purposely made the data fall within this window to make it easy. For this case, we assume training itself takes 6 months, and most managers either trained everyone together (adoption window = 0 months) or staggered within a few months. The locations with extremely long adoption windows were the exception. This filter has a downside worth noting. By blacking out the entire adoption window, we lose information about what happens during the transition itself. If some trainees are already creating impact while others are still in training, that partial effect gets thrown away. In cases where the transition period IS the thing you want to study (for example, measuring how quickly a team ramps up), a different framework would be more appropriate. There’s a potential upside too: novelty effects that inflate early results get absorbed by the blackout window and don’t contaminate the post-period read. Filter 2: Minimum Pre-Period Data In this example, we use at least 6 months of pre-period data for every location. We need to validate that treatment and control locations were trending similarly before adoption. If a location only has 2 months of pre-data, we can’t be certain whether its pre-trend was flat, rising, or falling. That makes the parallel trends test unreliable for that location. There’s a more technical reason too. If some locations contribute data at Period -6 and others don’t, the set of locations in your average changes across time periods. That’s composition bias again, the same problem that broke the single-cutoff approach. By requiring every location to have data across the full analysis window, we keep the composition constant. Period -6 and Period +6 contain the exact same set of locations. The comparison then remains apples to apples. Filter 3: Minimum Post-Period Data Same logic in the other direction. We need enough post-adoption months to actually measure whether the treatment effect materializes, ramps up, or fades. If we only see one month of post-data, we can’t tell whether the lift is real or just noise from a good month. The Tradeoff Every filter costs sample size. We’re trading breadth for a cleaner read. The treatment effect we estimate applies to “locations that adopted within a reasonable timeframe and had enough data on both sides.” In DiD, reducing bias before looking at results is the whole point. We normalize as closely as we can before making any comparison. Scenario A: Clean Holdout Control The Setup This is the simpler case. You designed the experiment with a proper holdout: 120 locations get the new software (still staggered), and 80 locations that never adopt during the observation period. Those 80 locations are the control group for the entire analysis. Group Locations Role Treatment 120 (staggered adoption) Receive software on varying timelines Control 80 (never adopted) Our counterfactual: what would have happened without the software? The control group captures background trends at every point in time. For each treatment location at, say, Period +2 (which might land in May for one location and August for another), we compare that metric to the control group’s data at the same calendar month. Here’s how the concurrent comparison works in practice. The table below shows three treatment locations whose adoption windows close at different months (meaning all trainees finished by that month). At any given calendar month, each location is at a different point in its own event timeline. “Post +2” means that location is 2 months past the end of its adoption window. The key insight: we compare each location to the control group at the same calendar month, not the same event-time period. Calendar Month Loc A (window closes M6) Loc B (window closes M10) Loc C (window closes M14) Control Avg M3 Pre-period Pre-period Pre-period ~51 M8 Post +2 (compare to control →) Pre-period Pre-period ~53 M12 Post +6 Post +2 (compare to control →) Pre-period ~54 M16 Post +10 Post +6 Post +2 (compare to control →) ~55 Read each row as a snapshot of one calendar month. At M8, Location A is already 2 months past its adoption window (Post +2), while B and C haven’t even started. All three are compared to the same control average at M8. By M16, all three are in their post-period, but at different distances from adoption. The regression sorts this out: location fixed effects absorb baseline differences, time fixed effects absorb calendar-month trends, and the treatment × period interactions isolate the effect at each distance from adoption. The parallel trends assumption is the foundation. Before any treatment happened, were treatment and control locations moving in the same direction at the same rate? If yes, we can attribute the post-adoption divergence to the treatment. If not, the results become harder to interpret. Validating the Setup Before looking at the results, we validate that the framework is working. Average metric for treatment and control groups over calendar time. The two groups track closely in the pre-treatment period, then diverge after adoption begins. The two groups moved together before treatment started. That’s not proof that the assumption holds in the post-period (it’s fundamentally untestable there), but it’s the best evidence we can get. Raw Metric Lift Before jumping to regression coefficients, it helps to see the actual metric values. This chart plots the average metric for treatment and control groups at each event-time period: Average metric for treatment vs. control at each event-time period. The gap after Period 0 is the raw treatment effect. Both groups trend similarly in the pre-period, then diverge. The gap between the two lines after Period 0 is the treatment effect in raw metric units. You can see it building over time as locations become more comfortable with the new software. The raw lift shows the treatment effect in plain metric units, but it doesn’t control for location-level baseline differences or calendar-time trends. The event-study regression in the next section adds those controls, producing coefficients with confidence intervals that formally isolate the causal effect. Event-Study Coefficients The raw lift chart is useful, but it doesn’t control for anything. The event-study regression (details in the Appendix) formalizes this by running an OLS regression with location fixed effects (comparing each location to itself), time fixed effects (absorbing calendar-month shocks), and a set of treatment × period interaction terms. Each interaction term captures: “for treatment locations at this specific distance from adoption, how much higher is their metric than we’d expect given their own baseline and the calendar-month trend?” The result is a regression coefficient at each relative period. A coefficient of +3.5 at Period +2 means: “two months after the adoption window closed, treatment locations’ metrics were 3.5 units higher than what we’d predict from their historical pattern and the control group’s concurrent trend.” If the model is well-specified, these coefficients isolate the causal effect of the treatment at each distance from adoption. Behind the Math: How the Regression Isolates the Treatment Effect The y = mx + b Version The event-study regression is just y = mx + b with a more structured baseline. Here’s how each piece maps: y = mx + b Event-Study Plain English y $y_{it}$ The metric you’re measuring for location i at time t b (intercept) $\alpha_i + \gamma_t$ Predicted baseline without treatment. Two pieces: this location’s typical level ($\alpha_i$) + this month’s global trend ($\gamma_t$) m (slope) $\beta_k$ Treatment effect at period k: how many extra metric units does treatment add at this distance from adoption? x (variable) $D_{ik}$ A binary flag: “Is this location treated AND at relative period k?” (1 = yes, 0 = no) The one twist: instead of a single slope m, you get one per period. So the full equation is: \[y_{it} = \underbrace{\alpha_i + \gamma_t}_{\text{baseline (b)}} + \underbrace{\beta_{-6} D_{-6} + \beta_{-5} D_{-5} + \cdots + \beta_{+6} D_{+6}}_{\text{treatment effects (m} \cdot \text{x, one per period)}} + \varepsilon_{it}\] Each $\beta_k$ is one dot on your event-study chart. Pre-period dots near zero mean the baseline prediction was accurate. Post-period dots climbing mean the treatment is working. Plug-In Example Say Location 7 has a typical baseline of 50 ($\alpha_7 = 50$), it’s currently Month 14 which has a global trend of +3 across all locations ($\gamma_{14} = 3$), and the regression estimated that the treatment effect at Period +2 is +4.1 ($\beta_{+2} = 4.1$). Location 7 is treated and currently 2 periods past adoption, so $D_{+2} = 1$: \[y = \underbrace{50 + 3}_{\text{baseline}} + \underbrace{4.1 \times 1}_{\text{treatment at Period +2}} = 57.1\] Without treatment, we’d predict 53 (just the baseline). The observed 57.1 means 4.1 units of lift attributable to the treatment at this point in the post-period. For an untreated location at the same time, all the $D$ flags are 0, so the treatment terms drop out and the prediction is just $50 + 3 = 53$. What Each Component Does 1. Location fixed effects ($\alpha_i$) — Each location has its own baseline level. Location A might average 60; Location B might average 45. The location fixed effect removes this “who you are” variation so we’re comparing each location to itself over time. Think of it like CUPED’s pre-period adjustment: instead of comparing raw levels across units, you’re looking at how much each location changed relative to its own history. 2. Time fixed effects ($\gamma_t$) — Each calendar month has its own average across all locations. Maybe December is always slow, or there’s a company-wide push in Q3 that lifts everyone. Time fixed effects absorb these calendar-driven patterns so they don’t get confused with treatment effects. 3. Treatment x period interactions ($\beta_k$) — After removing location baselines and calendar patterns, what’s left? For treated locations at each relative period $k$, the coefficient $\beta_k$ captures how much extra their metric moved beyond what the fixed effects alone would predict. This is the treatment effect at that specific distance from adoption. The Code # Event-study regression setup # y_it = α_i + γ_t + Σ β_k · D_ik + ε_it import pandas as pd import statsmodels.api as sm # Location fixed effects: compare each location to itself loc_fe = pd.get_dummies(df['location_id'], drop_first=True) # Time fixed effects: absorb calendar-month trends time_fe = pd.get_dummies(df['calendar_month'], drop_first=True) # Treatment × period indicators (one column per relative period) # Only "on" for treated locations at that distance from adoption treat_periods = pd.get_dummies( df['rel_period'] ).multiply(df['treated'], axis=0) X = pd.concat([loc_fe, time_fe, treat_periods], axis=1) model = sm.OLS(df['metric'], sm.add_constant(X)).fit() # β_k = coefficients on the treat_period columns # Each one answers: "At period k relative to adoption, # how much higher is the treated group's metric than # the fixed effects alone would predict?" The pre-period coefficients ($\beta_{-6}$ through $\beta_{-1}$) should land near zero. If they do, the model’s predicted baseline was accurate before treatment started. That’s what gives us confidence that the post-period coefficients are capturing a real treatment effect, not a pre-existing divergence. What Negative Coefficients Tell You In our simulation, the post-period coefficients are positive because the treatment works. But the regression doesn’t assume that. If $\beta_{+3} = -2.0$, it means treated locations are performing 2 units worse than the baseline predicts at that point. The treatment hurt. The pre-period is where negative coefficients matter most. If you see $\beta_{-4} = -1.5$ (statistically significant), that’s a red flag: treatment locations were already diverging from control before adoption. Any post-period lift could be a continuation of that pre-existing trend rather than a real treatment effect. The whole framework depends on the pre-period being flat. If it isn’t, the estimate is suspect regardless of what the post-period shows. Coefficient Pattern What It Means Pre-period near zero, post-period positive Treatment works. Baseline was accurate, post-period lift is real. Pre-period near zero, post-period negative Treatment backfired. The intervention made things worse. Pre-period trending (positive or negative) Parallel trends violated. Can’t trust the post-period estimate either way. Pre-period near zero, post-period positive then fading Treatment effect wears off over time. Top: the 6 calendar months that make up Period 0 shown individually (grayed out), showing data that gets excluded. Bottom: the final event-study coefficients with Period 0 condensed to a single band. Pre-period coefficients near zero confirm parallel trends. Post-period coefficients show the treatment effect building over time. Pre-period (Periods -6 to -1): The coefficients hover near zero and their confidence intervals cross zero. This confirms treatment and control locations were trending the same way before adoption happened. Post-period (Periods +1 to +6): The effect starts at about +2.8 in Period +1 and ramps up to about +4.5 by Period +6. This ramp-up pattern makes sense. It takes time for people to get comfortable with a new system. Results Group Pre-Period Avg Post-Period Avg Change Treatment 53.67 59.75 +6.08 Control 53.44 55.54 +2.10 DiD Estimate     +3.98 The treatment group’s metric went up by 6.08. The control group also went up by 2.10 (background trend). The difference-in-differences strips out that background trend: 6.08 - 2.10 = 3.98 units attributable to the treatment. Top: The naive calendar-time view, splitting at the median adoption month. This is misleading because it mixes locations at different adoption stages. Bottom: After normalizing to event time, the treatment effect becomes crisp. The gap after Period 0 builds cleanly as locations settle into the new software. Scenario B: Everyone Eventually Gets Treated The Setup The same normalization framework from Scenario A applies here. Each location still gets its own adoption window, pre-period, and post-period zones. The event-time alignment, the period-0 blackout, the sample filters: all of that carries over. The difference is in how we define the control group. In practice, your control group doesn’t stay clean forever. Many real rollouts don’t have a permanent holdout. Leadership wants everyone on the new software eventually. Some locations also just start sooner than others. This is the more common scenario and the one that’s harder to analyze. Every location gets treated. The question becomes: who do you compare the early adopters to? The answer: locations that haven’t started yet. For each cohort of locations completing adoption in the same month, we define temporary controls as locations that haven’t even begun training by the end of that cohort’s analysis window. They’re “not yet treated” for the entire comparison window, so they serve as clean controls for that specific cohort. Cohort (completing month X) Treatment Temporary Control Locations completing in Month 9 Those locations Locations whose training hasn’t started by Month 15 (leaves 6 months of post-period in the control) Locations completing in Month 12 Those locations Locations whose training hasn’t started by Month 18 Locations completing in Month 15 Those locations Locations whose training hasn’t started by Month 21 As more locations adopt, the pool of available control units shrinks. Early cohorts have plenty of not-yet-treated locations to compare against. Late cohorts have fewer. This is a fundamental constraint, not a flaw. For each cohort month: blue = current treatment locations, red = locations about to start treatment next month (being “shaved off” from the control pool), gray = remaining available controls. The control pool visibly shrinks as adoption progresses. Deep Dive: Why Two-Way Fixed Effects (TWFE) Fails Here Two-Way Fixed Effects (TWFE) is the standard regression approach for panel data. The idea is simple: include a fixed effect for each location (absorbing permanent differences between units) and one for each time period (absorbing shocks that hit everyone). Then add a single binary treatment indicator, run OLS, and read off its coefficient. For a primer on panel data methods, Torres (2007) is a solid starting point. When everyone gets treated at the same time, TWFE works great. There’s one clean “before” and one clean “after.” The untreated locations serve as a straightforward comparison group the entire time. The problem shows up when adoption is staggered. Consider two locations: Location A adopted in Month 6. By Month 14, it’s been on the new software for 8 months and its metric is elevated. Location B adopted in Month 12. By Month 14, it’s only 2 months in. TWFE compares Location B’s post-treatment metric against all other units at that time, including Location A. But Location A’s metric is already inflated by 8 months of treatment. TWFE treats it as a valid comparison anyway. This pulls Location B’s estimated effect downward. If the treatment effect is constant over time, this contamination is minor. But if the effect ramps up (as it does in most real rollouts, where people gradually get more comfortable with a new system), the bias grows. Early adopters in their late post-period have large accumulated effects. When TWFE implicitly uses them as “controls” for late adopters, it subtracts those large effects, shrinking or even flipping the estimated coefficient. Callaway and Sant’Anna (2021) and Sun and Abraham (2021) formalized this problem and showed just how misleading those estimates can be when treatment effects evolve over time. Beyond the statistical issues, event-study designs have a practical advantage: they produce period-by-period estimates that are easy to explain to business stakeholders. Showing a chart where the effect ramps up over time tells a story that a single TWFE coefficient can’t. This is what we want to build upon: estimate treatment effects cohort by cohort, using only not-yet-treated units as our control group. Results Using the cohort-based approach on simulated data where all 200 locations eventually get treated: Group Pre-Period Avg Post-Period Avg Change Treatment (cohort) 53.02 59.27 +6.24 Control (not-yet-treated) 52.49 54.57 +2.08 DiD Estimate     +4.16 Average metric for cohort-defined treatment vs. temporary controls at each event-time period. The gap after Period 0 is the raw treatment effect, measured against locations that haven’t started training yet. The raw lift is visible but noisier than Scenario A. The regression coefficients below add location, time, and cohort fixed effects for a cleaner read. Behind the Math: How Cohort-Based Regression Differs The regression structure is the same as Scenario A, with one addition: cohort fixed effects. Each adoption cohort (locations completing in the same month) gets its own intercept. This helps us compare within cohorts: early adopters against their own temporary controls, late adopters against theirs. The practical effect: instead of one big regression pooling all locations together, the cohort fixed effects effectively run separate comparisons for each adoption wave and average across them. This prevents early adopters’ elevated metrics from contaminating late adopters’ estimates, the exact problem that TWFE has. Event-study coefficients for Scenario B using cohort-defined temporary controls. The pattern is similar to Scenario A: flat pre-period, positive post-period ramp-up. Confidence intervals are wider because the effective control group is smaller. Treatment vs. temporary controls in event time. The gap after Period 0 shows the treatment effect, measured against locations that haven’t started training yet. The estimate recovers the signal, but with wider confidence intervals than Scenario A. That’s expected, and it’s worth understanding why. Why the Confidence Intervals Are Wider A confidence interval tells you the range of values that are plausible given your data. A 95% CI means: if you repeated this experiment many times with new random samples, about 95% of the intervals you’d compute would contain the true effect. Narrower intervals mean more precision. Wider intervals mean more uncertainty. In Scenario A, the control group is fixed: the same 80 locations serve as the comparison for every treatment location across the entire timeline. That’s a lot of data anchoring the control group average, which keeps variance low and intervals tight. In Scenario B, each cohort defines its own temporary control group. A cohort completing in Month 9 might have 40 controls (locations that haven’t started by Month 15). A cohort completing in Month 15 might only have 15 controls (most locations have started by then). Fewer control units means more variance in the control group average for that cohort, which translates to wider intervals on that cohort’s estimate. The final estimate pools across all cohorts, but it inherits the noise from the noisier ones. The precision you lose is the cost of not having a permanent holdout, and it’s a real tradeoff. Comparing the Two Scenarios Side by side: Scenario A (clean holdout, blue) vs Scenario B (cohort controls, red). The dashed line marks the true effect built into the simulation (4.5). Both recover the signal. Scenario A has tighter confidence intervals because the control group is larger and permanent. Why some methods fall short This is why framework matters. We ran the same simulated data through three different estimation approaches to see how much the choice of method affects the result. Since this is synthetic data, we know the true treatment effect built into the simulation (4.5 units at full ramp-up), so we can measure how far off each approach lands. Approach A: Naive Calendar Cutoff Pick the median adoption month, split everything into “before” and “after,” compare treatment to control. This is the simplest possible approach and what most people try first. It systematically underestimates because at any given calendar month, your treatment group includes locations at completely different stages. You’re averaging together real effects with zeros. Approach B: Standard TWFE Run a single regression with location fixed effects, time fixed effects, and one treatment indicator. Unlike the naive approach, this uses each location’s actual adoption date to define “post-treatment.” That’s better than forcing a single cutoff. But it still pools into one average effect, and under staggered timing, already-treated locations implicitly serve as comparisons for late adopters. Approach C: Event-Study Design The approach we’ve been building throughout this post. By normalizing each location to its own event time and estimating period-by-period effects, we avoid the composition bias that plagues the other two methods. The Comparison The naive calendar cutoff underestimates by about 27%. Standard TWFE closes to about 16% off. The event-study design lands closest, within 12% of the known average treatment effect across all post-periods. Same data, three approaches. Panel A uses a single calendar cutoff. Panel B splits treatment into early and late adopters, showing the heterogeneity that TWFE pools into one number. Panel C normalizes to event time, where the treatment effect snaps into focus. The takeaway: the choice of analytical framework isn’t just an academic exercise. On this data, the naive approach underestimated the average treatment effect by about 27%. If you presented that to leadership, you’d be telling them the intervention was significantly less effective than it actually was. The event-study design recovers most of the signal. Try It Yourself Adjust the parameters below and hit “Run Simulation” to see how staggered adoption affects each estimation method. The simulation generates synthetic data with your chosen settings and compares three approaches: naive calendar cutoff, TWFE, and event-study design. Try setting the stagger range to 1 month (everyone adopts at roughly the same time) and watch all three methods converge. Then crank it up to 15 months and see the naive estimate fall behind. Limitations No approach covers everything. Here’s what to watch for. Pre-Period Contamination Some trainees are already in training during the pre-period months. If training itself disrupts operations (trainee pulled away for classes, other staff covering, workload shifting), then the pre-period metrics might be slightly depressed compared to a truly untouched baseline. This actually biases your estimate downward: the pre-period looks worse than it would without any training disruption, so the measured lift is smaller than the real lift. If you find a positive effect despite this, the true effect is probably larger. Selection Bias from Filtering By filtering to locations with clean adoption windows and sufficient data, we’re studying a specific subset. Locations that adopted within the expected timeframe might have had smoother operations or stronger management support. The treatment effect for those locations could be higher than what you’d see for locations that had a harder time with adoption. The result speaks to locations that implemented properly, which is still a very useful answer in a lot of business contexts, just not a universal one. Parallel Trends This is the core assumption behind the whole framework. Treatment and control locations need to have been following the same trajectory before adoption. If they weren’t, any post-adoption divergence could be driven by something other than the treatment. We can check this in the pre-period by looking at whether the two groups were trending together. We can’t prove it holds in the post-period, but if the pre-trends align closely, that’s strong supporting evidence. Scenario B: Shrinking Controls In Scenario B, the pool of available controls shrinks as more locations adopt. Late cohorts have fewer not-yet-treated locations to compare against, which means wider confidence intervals and less statistical power. If adoption is fast enough that almost everyone is treated within a few months, there may not be enough clean controls for any cohort. When to Use Something Else This approach works well when you have treatment timing that varies, you can define a bounded adoption window, you have enough pre and post periods, and the parallel trends assumption is plausible. Consider alternatives when you don’t have a control group (synthetic control methods), when treatment is continuous rather than binary (dose-response models), when adoption timing is endogenous (instrumental variables), or when you have very few treated units. Summary When treatment timing varies, standard DiD breaks. Forcing a single cutoff creates composition bias that can dilute or reverse your results. The fix: normalize to event time. Let each unit define its own adoption window, black out the transition, and measure outcomes relative to each unit’s timeline. The event-study regression gives you period-by-period effects with built-in validation through the flat pre-period test. Two scenarios, same framework. Clean holdout (Scenario A) gives tighter estimates. Everyone-gets-treated (Scenario B) uses cohort-based temporary controls and is more common in practice. The adoption window threshold is a judgment call, filtering trades sample size for cleaner reads, and parallel trends is the assumption that matters most. References Callaway, B., &amp; Sant’Anna, P. H. (2021). Difference-in-Differences with multiple time periods. Journal of Econometrics, 225(2), 200-230. Link Sun, L., &amp; Abraham, S. (2021). Estimating dynamic treatment effects in event studies with heterogeneous treatment effects. Journal of Econometrics, 225(2), 175-199. Link Goodman-Bacon, A. (2021). Difference-in-differences with variation in treatment timing. Journal of Econometrics, 225(2), 254-277. Link Appendix: The Formal Model Event-Study Regression Specification The event-study regression formalizes the period-by-period DiD comparison. The model: \[Y_{it} = \alpha_i + \gamma_t + \sum_{k \neq -1} \beta_k \cdot D_{it}^{k} + \epsilon_{it}\] Here is what each piece means in plain language. $Y_{it}$ is the efficiency metric for location $i$ in month $t$. $\alpha_i$ is a location fixed effect. Each location is compared to itself. Location 101 might naturally run at a higher efficiency than Location 205. The fixed effect absorbs that difference. We’re not comparing Location 101 to Location 205. We’re comparing Location 101 before adoption to Location 101 after adoption. $\gamma_t$ is a time fixed effect. This absorbs anything that affected all locations in a given month. Maybe December is always slower because of holidays. Maybe there was a system outage in Month 14 that hit everyone. Time fixed effects soak that up. $D_{it}^{k}$ is a dummy variable equal to 1 if location $i$ is a treatment location and is in relative period $k$. This is how we isolate the treatment effect at each specific distance from adoption. $\beta_k$ is what we care about. These are the treatment effect coefficients. $\beta_{+3}$ tells us: “three months after the adoption window closed, how much higher (or lower) was the metric for treatment locations compared to what we’d expect?” We omit Period -1 as the reference category. All other $\beta_k$ values are measured relative to the period right before adoption started completing. This gives us a built-in sanity check: the pre-period betas should be near zero. For Scenario B, the model adds cohort fixed effects ($\delta_c$) to account for systematic differences across adoption cohorts, and uses cohort-specific treatment/control definitions rather than a permanent control group. Appendix: Full Code The complete simulation is below. It generates synthetic panel data for both scenarios, normalizes to event time, runs the event-study regression, and benchmarks against naive and TWFE approaches. You can also download the script which includes all plotting functions. pip install numpy pandas matplotlib statsmodels seaborn python staggered_did_simulation.py 1. Generate Synthetic Panel Data (Scenario A) import numpy as np import pandas as pd import statsmodels.api as sm np.random.seed(42) def generate_synthetic_data(): """ Create a panel dataset of 200 locations over 24 months. 120 treatment locations adopt new software on staggered timelines. 80 control locations never adopt. Treatment effect: ramps up over 3 months post-adoption, peaking at 4.5 units (3 months * 1.5 per month). """ records = [] # --- Treatment locations (IDs 1 through 120) --- for loc_id in range(1, 121): # Each location starts adoption in a random month adoption_start = np.random.randint(3, 16) # 1-5 employees per location n_employees = np.random.randint(1, 6) # 40% train everyone together, 60% stagger if np.random.random() &lt; 0.4: starts = [adoption_start] * n_employees else: spread = np.random.randint(1, 4) starts = [ adoption_start + np.random.randint(0, spread) for _ in range(n_employees) ] # Training takes 6 months per person completions = [s + 6 for s in starts] first_completion = min(completions) last_completion = max(completions) window = last_completion - first_completion # Skip locations with adoption windows &gt; 6 months if window &gt; 6: continue for month in range(1, 25): # Baseline metric with trend and noise baseline = 50 + 0.3 * month noise = np.random.normal(0, 2) # Treatment effect ramps up after first completion effect = 0 if month &gt;= first_completion: months_post = min( month - first_completion + 1, 3 ) effect = months_post * 1.5 records.append({ 'location_id': loc_id, 'month': month, 'metric': baseline + effect + noise, 'treatment': 1, 'first_completion': first_completion, 'last_completion': last_completion, 'adoption_window': window, }) # --- Control locations (IDs 121 through 200) --- for loc_id in range(121, 201): for month in range(1, 25): baseline = 50 + 0.3 * month noise = np.random.normal(0, 2) records.append({ 'location_id': loc_id, 'month': month, 'metric': baseline + noise, 'treatment': 0, 'first_completion': np.nan, 'last_completion': np.nan, 'adoption_window': np.nan, }) return pd.DataFrame(records) 2. Normalize to Event Time def normalize_to_event_time(data): """ Convert calendar time to relative event time. Treatment locations: event_time = month - first_completion Period -3 = three months before first trainee finished Period 0 = month of first completion (adoption window) Period +2 = two months after last trainee finished Control locations: aligned to median treatment timing for visualization purposes. The regression uses time fixed effects for the actual comparison. """ median_adoption = data.loc[ data['treatment'] == 1, 'first_completion' ].median() data['event_time'] = np.nan data['period'] = np.nan # Treatment: relative to their own first_completion treat = data['treatment'] == 1 data.loc[treat, 'event_time'] = ( data.loc[treat, 'month'] - data.loc[treat, 'first_completion'] ) # Control: relative to median adoption time ctrl = data['treatment'] == 0 data.loc[ctrl, 'event_time'] = ( data.loc[ctrl, 'month'] - median_adoption ) # Bin into periods -6 through +6 in_window = data['event_time'].between(-6, 6) data.loc[in_window, 'period'] = ( data.loc[in_window, 'event_time'].astype(int) ) return data 3. Event-Study Regression def run_event_study_regression(data): """ Estimate treatment effects at each relative period. Model: Y_it = alpha_i + gamma_t + sum(beta_k * D_it^k) D_it^k = 1 if location i is treated AND in period k. Period -1 is the omitted reference category. Pre-period betas near zero = parallel trends confirmed. Post-period betas = treatment effect at each distance. """ reg_data = data[ data['period'].notna() &amp; (data['period'] &gt;= -6) &amp; (data['period'] &lt;= 6) ].copy() # Treatment x period interaction dummies # Each one isolates the treatment effect at period k for k in range(-6, 7): reg_data[f'period_{k}'] = ( (reg_data['period'] == k) &amp; (reg_data['treatment'] == 1) ).astype(int) # Drop period -1 (reference category) reg_data = reg_data.drop(columns=['period_-1']) # Fixed effects loc_fe = pd.get_dummies( reg_data['location_id'], prefix='loc', drop_first=True ) time_fe = pd.get_dummies( reg_data['month'], prefix='month', drop_first=True ) # Build regression matrix period_cols = [ f'period_{k}' for k in range(-6, 7) if k != -1 ] X = pd.concat( [reg_data[period_cols], loc_fe, time_fe], axis=1 ).astype(float) X = sm.add_constant(X, has_constant='add') Y = reg_data['metric'].astype(float) results = sm.OLS(Y, X).fit() # Extract coefficients for each period coefs, ci_lo, ci_hi = {}, {}, {} for k in range(-6, 7): if k == -1: coefs[k], ci_lo[k], ci_hi[k] = 0, 0, 0 continue col = f'period_{k}' coefs[k] = results.params[col] ci = results.conf_int().loc[col] ci_lo[k], ci_hi[k] = ci[0], ci[1] return results, coefs, ci_lo, ci_hi 4. Scenario B: Cohort-Based Controls def generate_scenario_b_data(n_locations=200, n_months=30): """ All locations eventually get treated. No permanent control. Adoption starts staggered across months 3-24. Longer timeline (30 months) for late adopters. """ np.random.seed(42) records = [] for loc_id in range(1, n_locations + 1): adoption_start = np.random.randint(3, 25) n_employees = np.random.randint(1, 6) if np.random.random() &lt; 0.4: starts = [adoption_start] * n_employees else: spread = np.random.randint(1, 4) starts = [ adoption_start + np.random.randint(0, spread) for _ in range(n_employees) ] completions = [s + 6 for s in starts] first_completion = min(completions) last_completion = max(completions) window = last_completion - first_completion if window &gt; 6: continue for month in range(1, n_months + 1): baseline = 50 + 0.3 * month noise = np.random.normal(0, 2) effect = 0 if month &gt;= first_completion: months_post = min( month - first_completion + 1, 3 ) effect = months_post * 1.5 records.append({ 'location_id': loc_id, 'month': month, 'metric': baseline + effect + noise, 'first_completion': first_completion, 'adoption_start': adoption_start, }) return pd.DataFrame(records) def define_cohort_controls(data, pre_periods=6, post_periods=6): """ For each cohort (locations completing in the same month), define temporary controls: locations that haven't started treatment by the end of this cohort's analysis window. """ all_cohort_data = [] cohort_months = sorted( data['first_completion'].dropna().unique() ) for cm in cohort_months: cm = int(cm) cohort_ids = data[ data['first_completion'] == cm ]['location_id'].unique() window_end = cm + post_periods control_ids = data[ data['adoption_start'] &gt; window_end ]['location_id'].unique() if len(control_ids) &lt; 3: continue window_start = cm - pre_periods for loc_id in cohort_ids: ld = data[ (data['location_id'] == loc_id) &amp; (data['month'].between(window_start, window_end)) ].copy() ld['cohort'] = cm ld['cohort_treatment'] = 1 fc = ld['first_completion'].iloc[0] ld['event_time'] = ld['month'] - fc ld['period'] = np.where( ld['event_time'].between(-pre_periods, post_periods), ld['event_time'].astype(int), np.nan ) all_cohort_data.append(ld) for loc_id in control_ids: ld = data[ (data['location_id'] == loc_id) &amp; (data['month'].between(window_start, window_end)) ].copy() ld['cohort'] = cm ld['cohort_treatment'] = 0 ld['event_time'] = ld['month'] - cm ld['period'] = np.where( ld['event_time'].between(-pre_periods, post_periods), ld['event_time'].astype(int), np.nan ) all_cohort_data.append(ld) return pd.concat(all_cohort_data, ignore_index=True) 5. DiD Summary and Benchmarking def compute_did_summary(data): """ Simple DiD table: pre/post averages for treatment and control. Pre = periods -6 to -1, post = +1 to +6. """ analysis = data[ data['period'].notna() &amp; (data['period'] != 0) ].copy() analysis['post'] = (analysis['period'] &gt; 0).astype(int) summary = analysis.groupby( ['treatment', 'post'] )['metric'].mean().unstack() summary.columns = ['Pre Avg', 'Post Avg'] summary['Change'] = summary['Post Avg'] - summary['Pre Avg'] summary.index = ['Control', 'Treatment'] did = ( summary.loc['Treatment', 'Change'] - summary.loc['Control', 'Change'] ) print(f"DiD Estimate: {did:.2f}") return summary, did def run_naive_cutoff(data): """ Naive approach: single calendar cutoff at the median adoption month. Splits all data into before/after. Underestimates because of composition bias. """ cutoff = int( data.loc[data['treatment'] == 1, 'first_completion'] .median() ) pre = data[data['month'] &lt; cutoff] post = data[data['month'] &gt;= cutoff] treat_change = ( post[post['treatment'] == 1]['metric'].mean() - pre[pre['treatment'] == 1]['metric'].mean() ) ctrl_change = ( post[post['treatment'] == 0]['metric'].mean() - pre[pre['treatment'] == 0]['metric'].mean() ) return treat_change - ctrl_change def run_twfe(data): """ Two-way fixed effects: single treatment coefficient. Uses each location's actual adoption date (better than naive), but still pools into one average effect. Under staggered timing, already-treated locations implicitly serve as comparisons for late adopters. """ cutoff = int( data.loc[data['treatment'] == 1, 'first_completion'] .median() ) reg = data.copy() # Treatment locations: post = after THEIR adoption treat = reg['treatment'] == 1 reg.loc[treat, 'post'] = ( reg.loc[treat, 'month'] &gt;= reg.loc[treat, 'first_completion'] ).astype(int) # Control locations: post = after median cutoff ctrl = reg['treatment'] == 0 reg.loc[ctrl, 'post'] = ( reg.loc[ctrl, 'month'] &gt;= cutoff ).astype(int) reg['treat_x_post'] = reg['treatment'] * reg['post'] # Fixed effects loc_fe = pd.get_dummies( reg['location_id'], prefix='loc', drop_first=True ) time_fe = pd.get_dummies( reg['month'], prefix='month', drop_first=True ) X = pd.concat( [reg[['treat_x_post']], loc_fe, time_fe], axis=1 ).astype(float) X = sm.add_constant(X, has_constant='add') Y = reg['metric'].astype(float) model = sm.OLS(Y, X).fit() return model.params['treat_x_post'] # --- Run everything --- data = generate_synthetic_data() data = normalize_to_event_time(data) results, coefs, ci_lo, ci_hi = run_event_study_regression(data) summary, did = compute_did_summary(data) naive = run_naive_cutoff(data) twfe = run_twfe(data) event_study_avg = np.mean([coefs[k] for k in coefs if k &gt; 0]) true_effect = 4.5 # Built into the simulation print(f"\nNaive: {naive:.2f} ({((naive-true_effect)/true_effect)*100:+.0f}% bias)") print(f"TWFE: {twfe:.2f} ({((twfe-true_effect)/true_effect)*100:+.0f}% bias)") print(f"Event-Study: {event_study_avg:.2f} ({((event_study_avg-true_effect)/true_effect)*100:+.0f}% bias)") print(f"True Effect: {true_effect}") Uses np.random.seed(42) for reproducibility. The full script includes all plotting functions and the Scenario B simulation.]]></summary></entry><entry><title type="html">Classification Algorithms From Scratch</title><link href="https://danieltabach.github.io/from-scratch/classification-from-scratch/" rel="alternate" type="text/html" title="Classification Algorithms From Scratch" /><published>2025-01-17T00:00:00-05:00</published><updated>2025-01-17T00:00:00-05:00</updated><id>https://danieltabach.github.io/from-scratch/classification-from-scratch</id><content type="html" xml:base="https://danieltabach.github.io/from-scratch/classification-from-scratch/"><![CDATA[<p><em>Given a data point, which class does it belong to? We build three different classifiers and see when each one shines.</em></p>
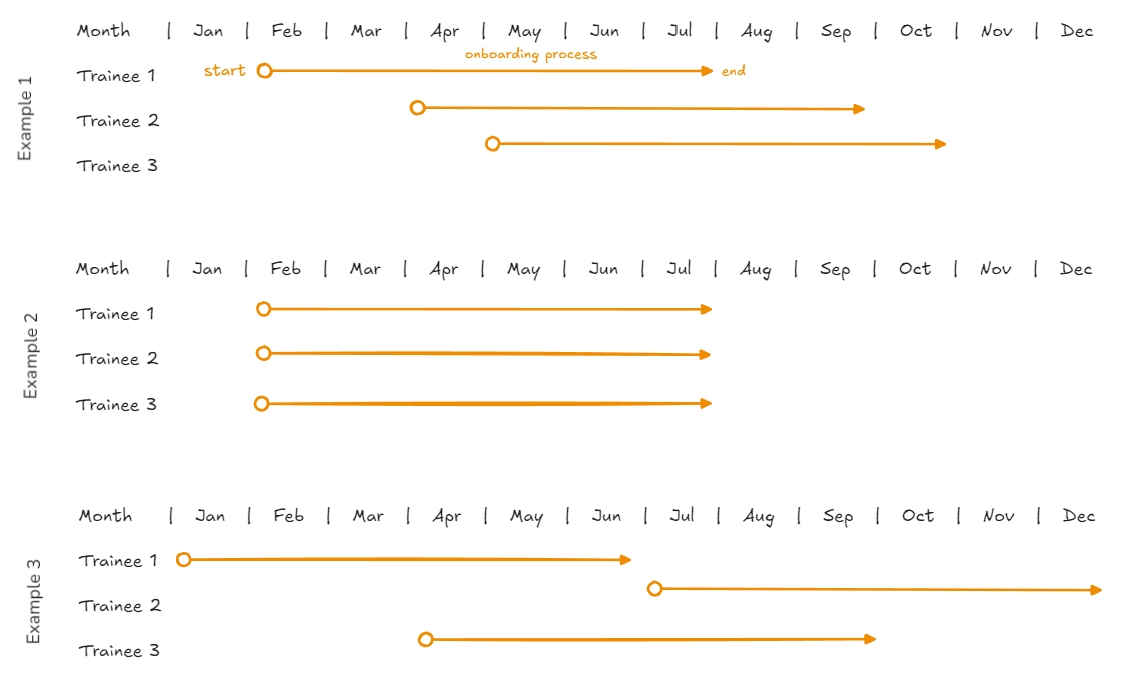
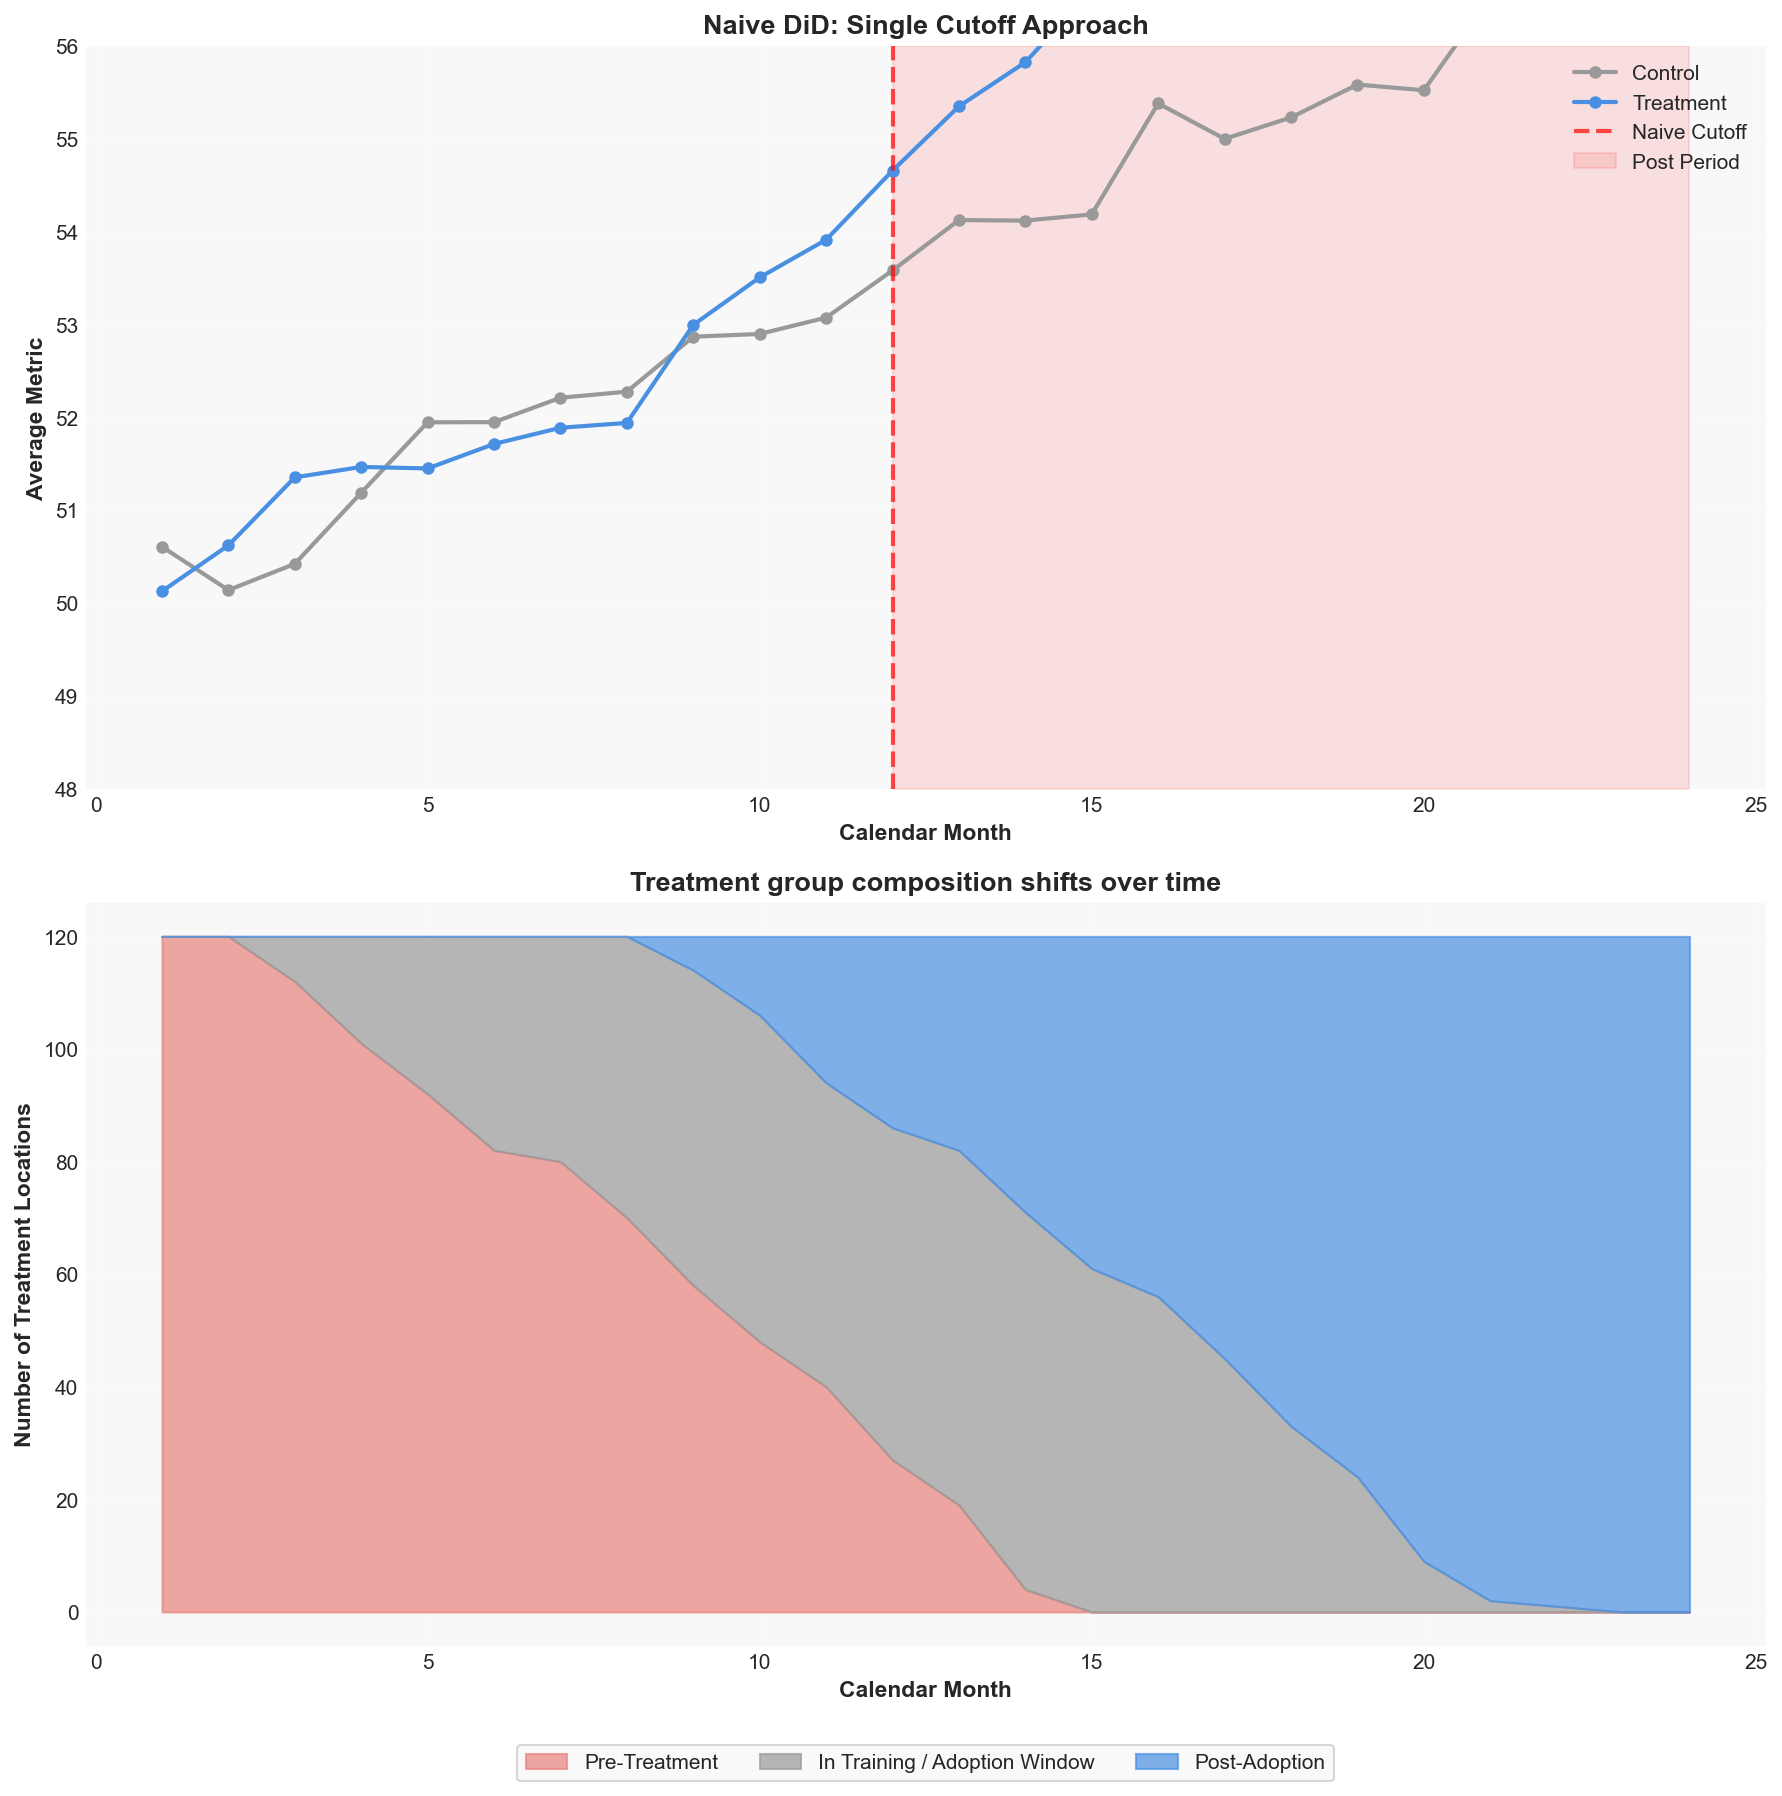
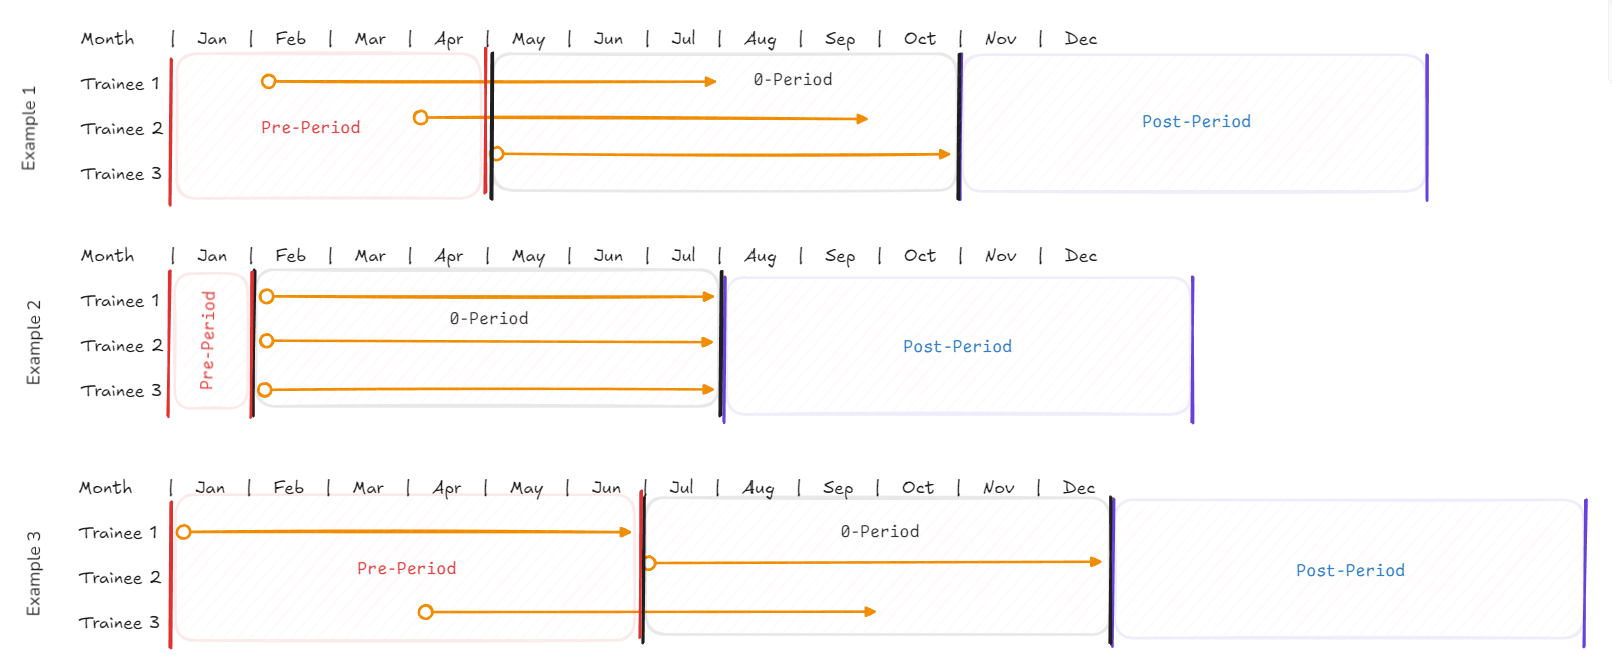
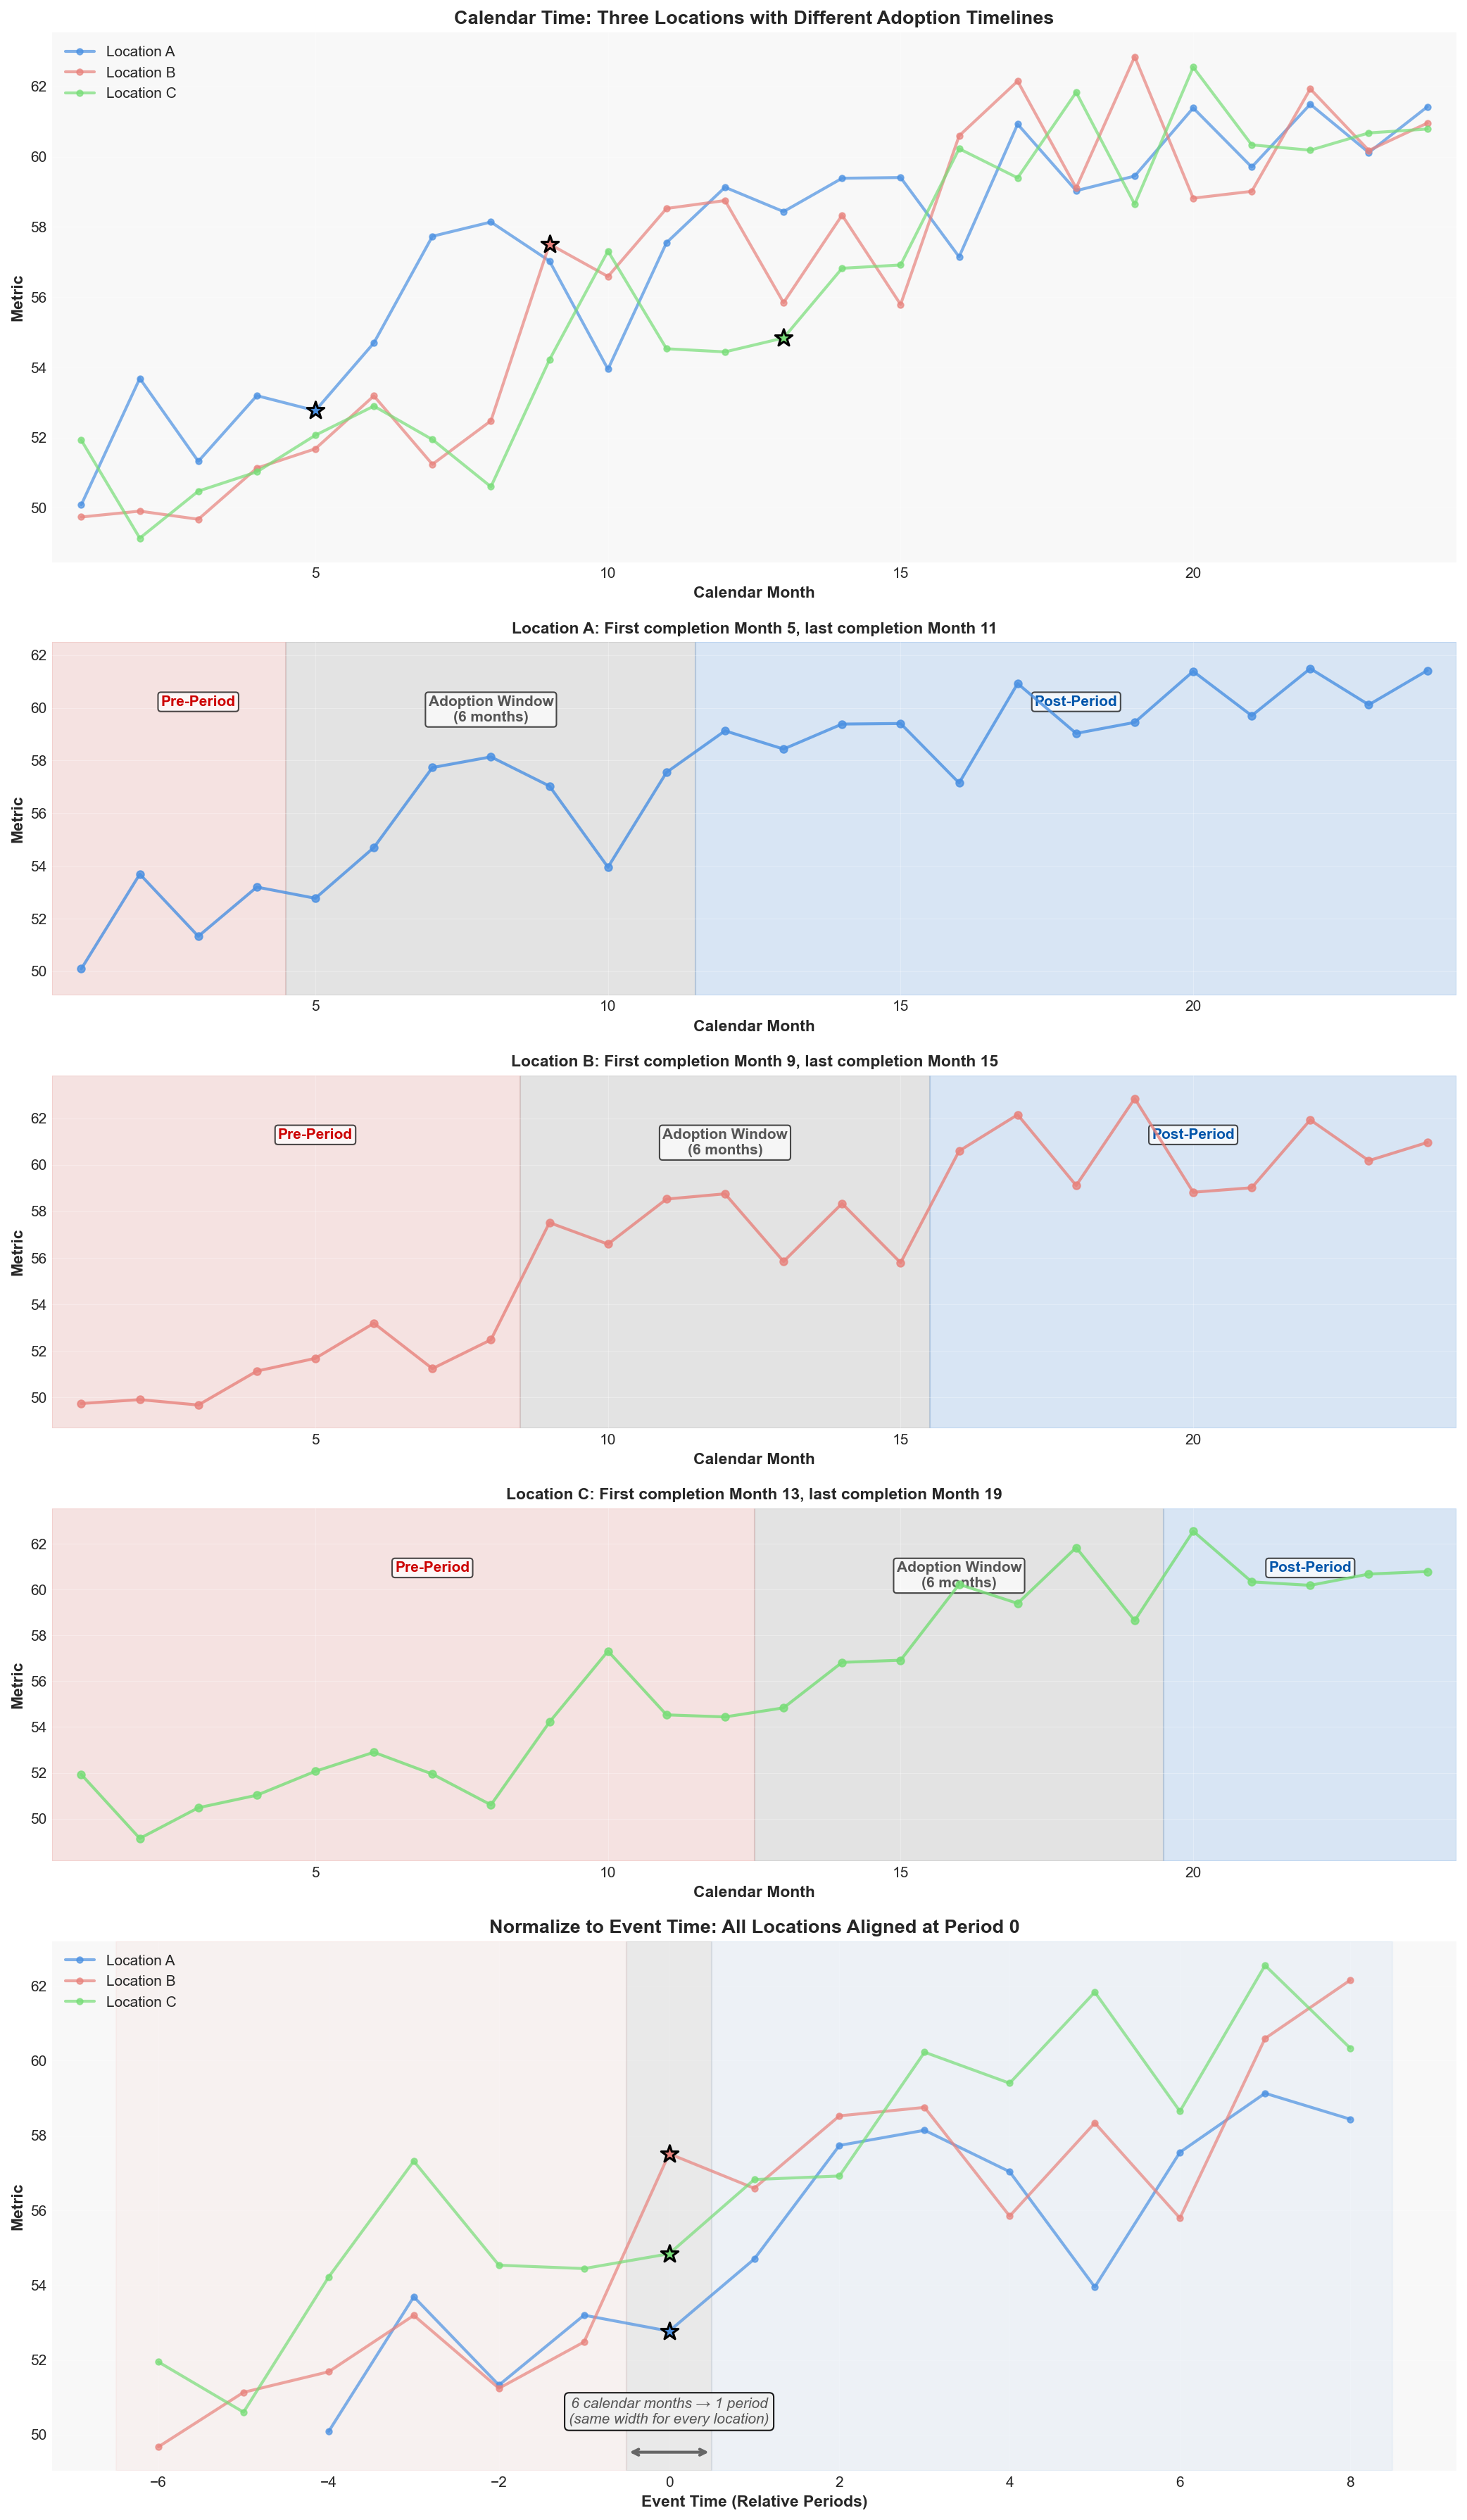
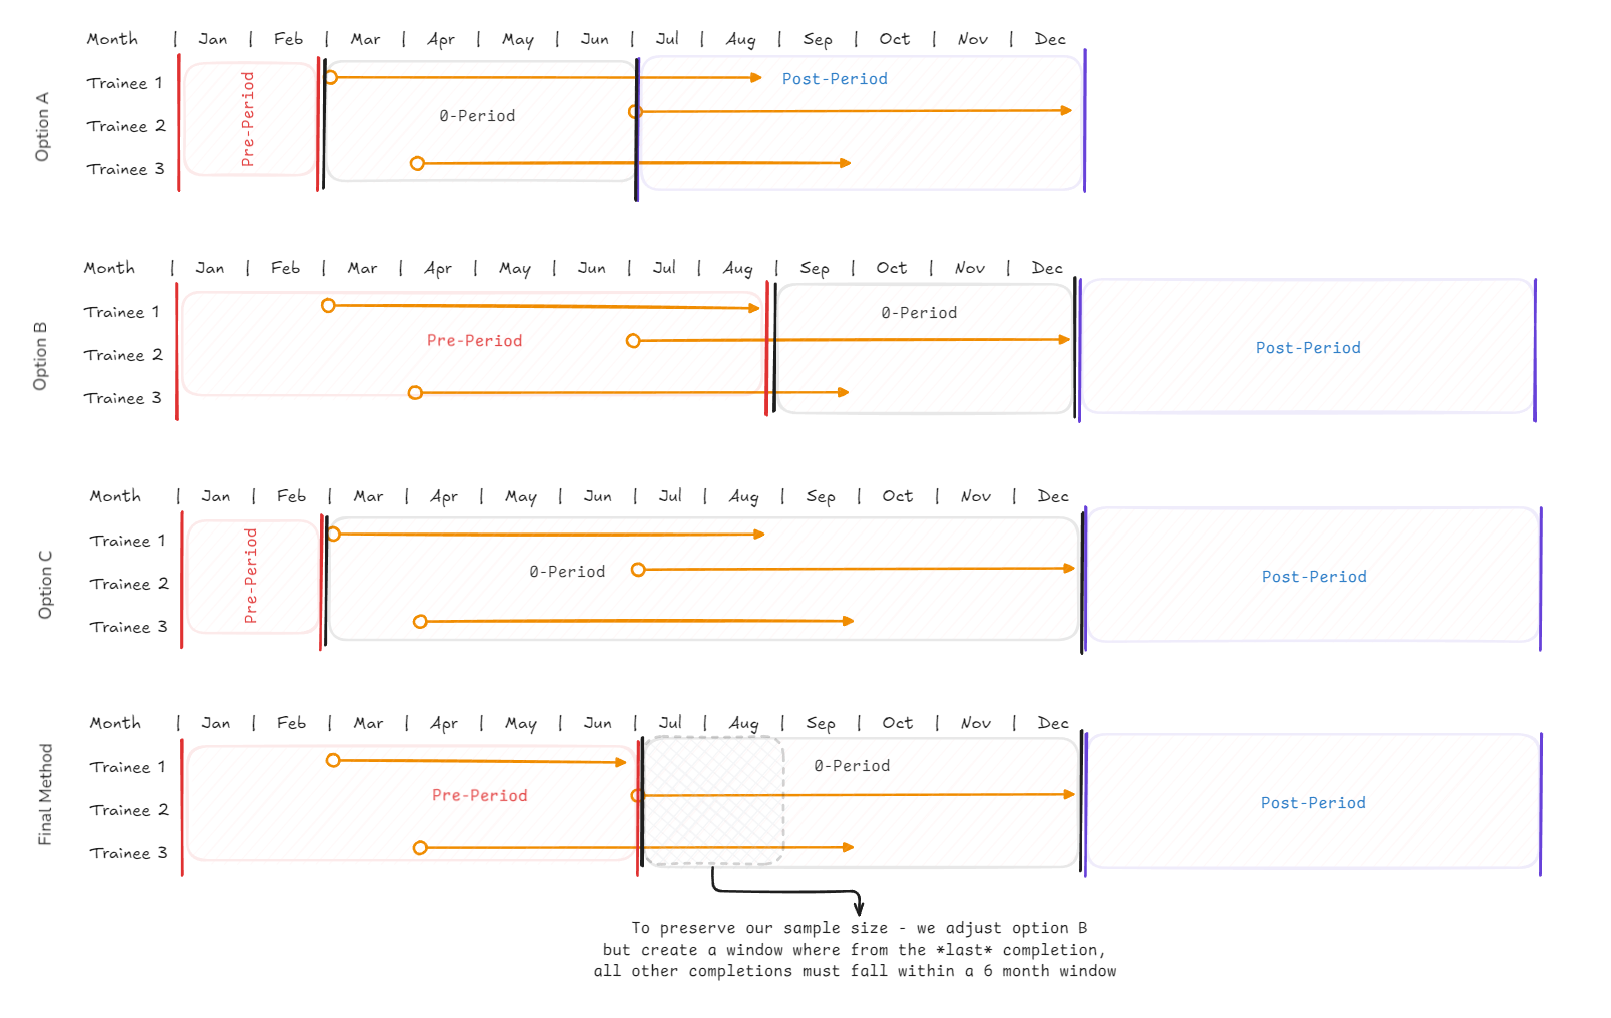
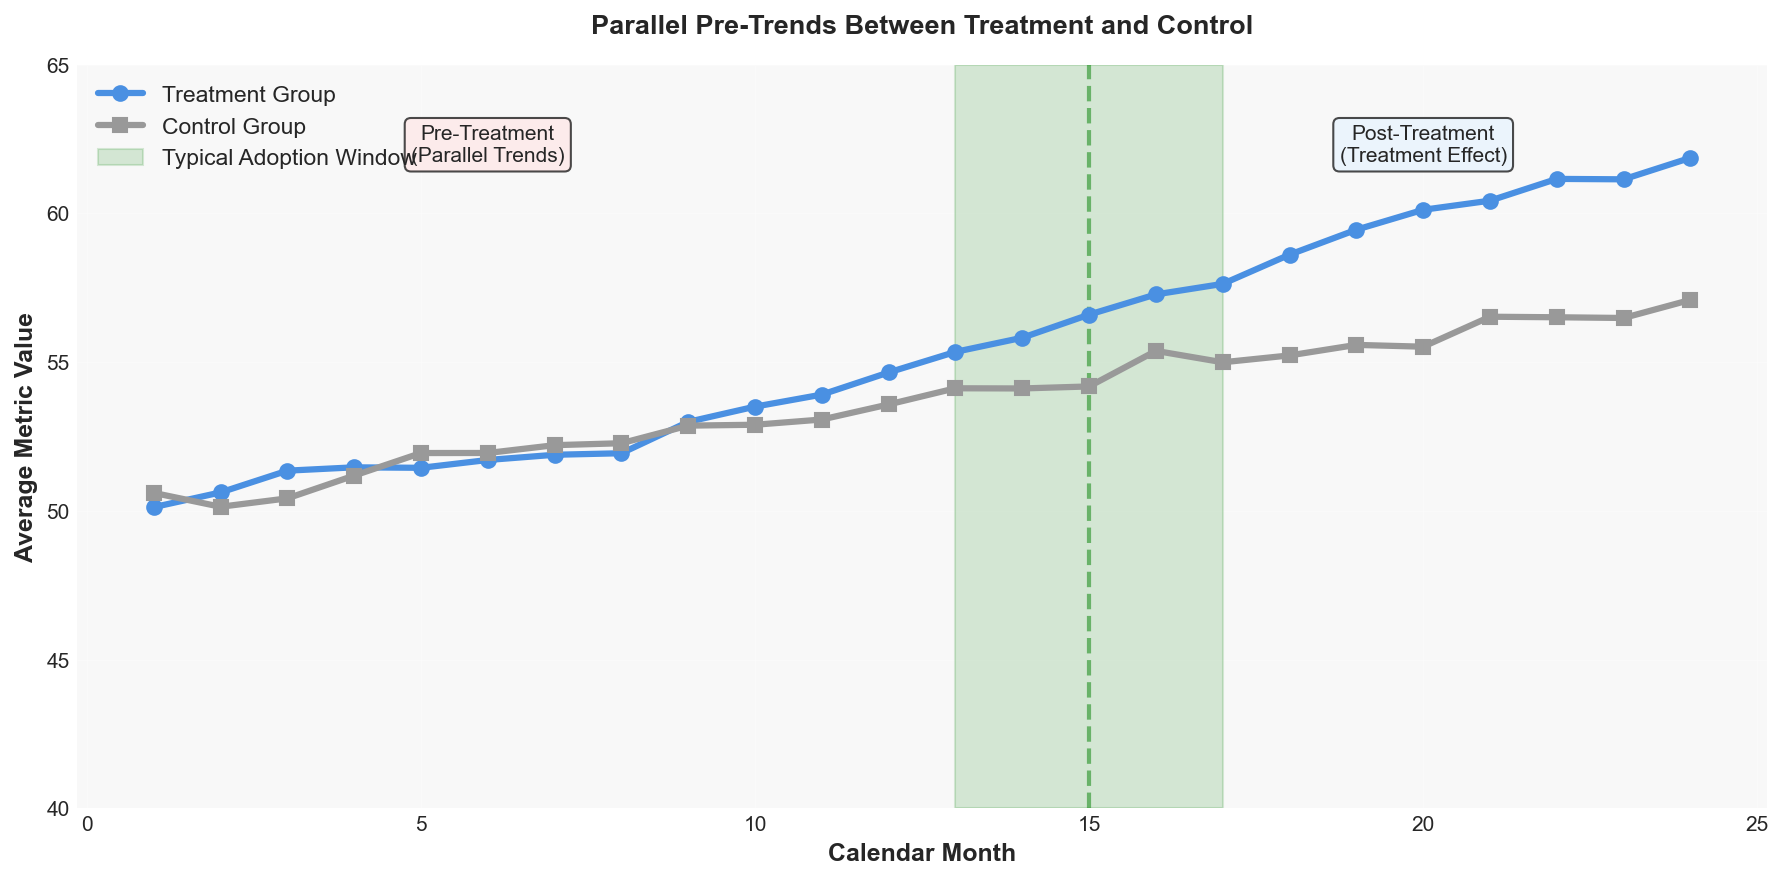
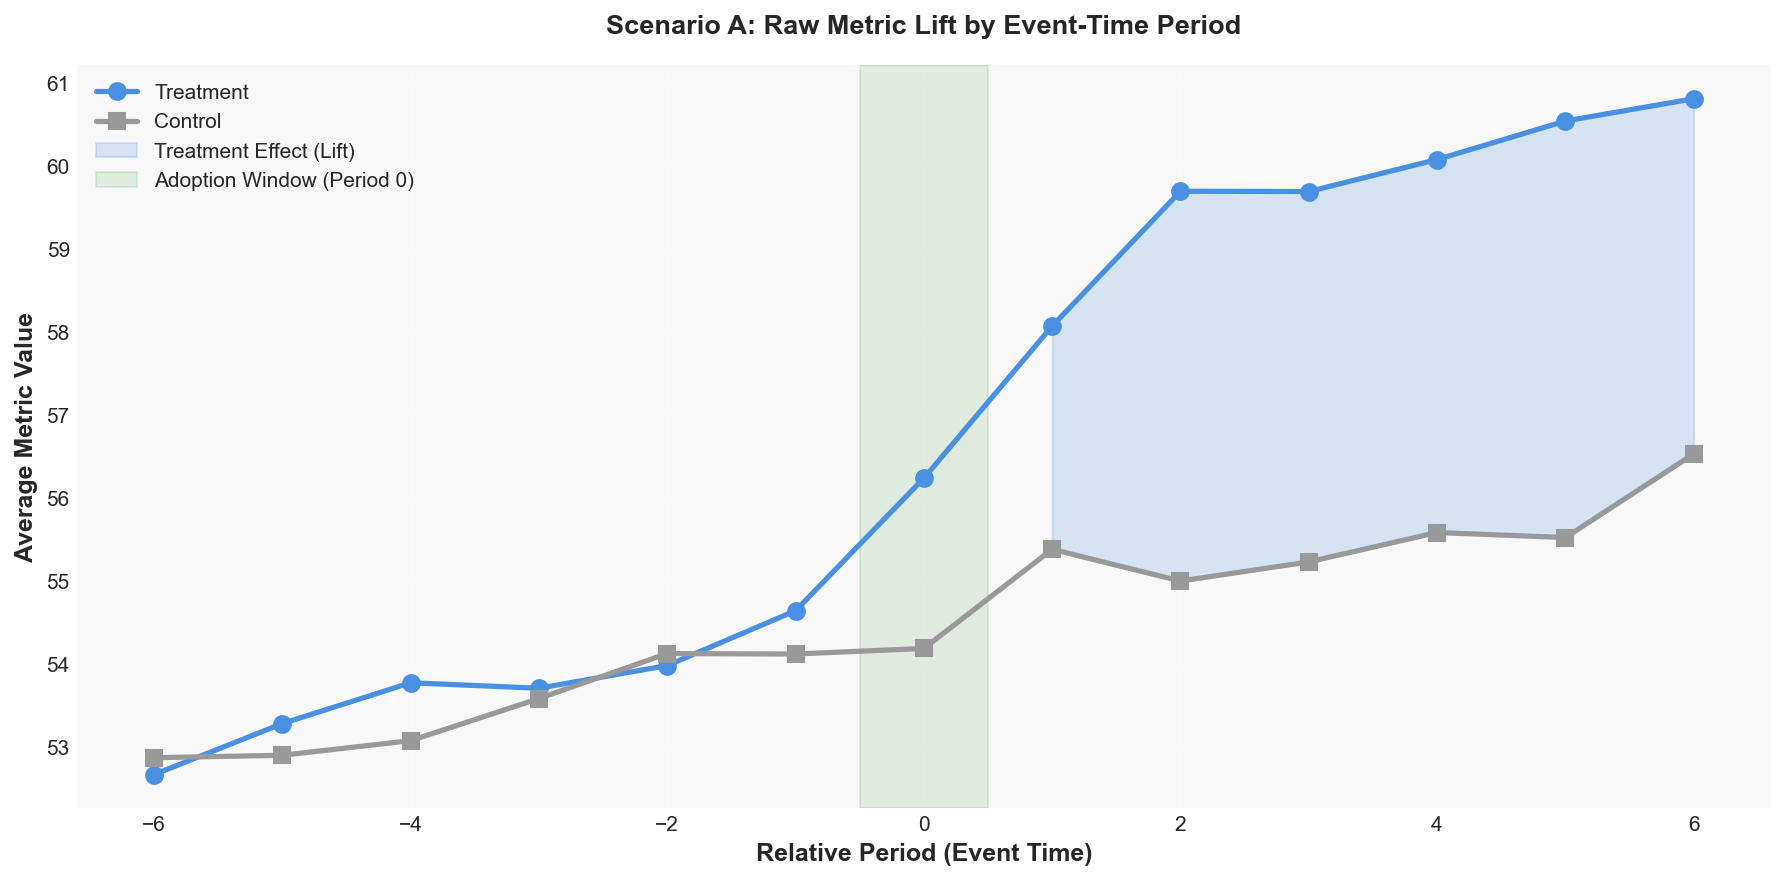
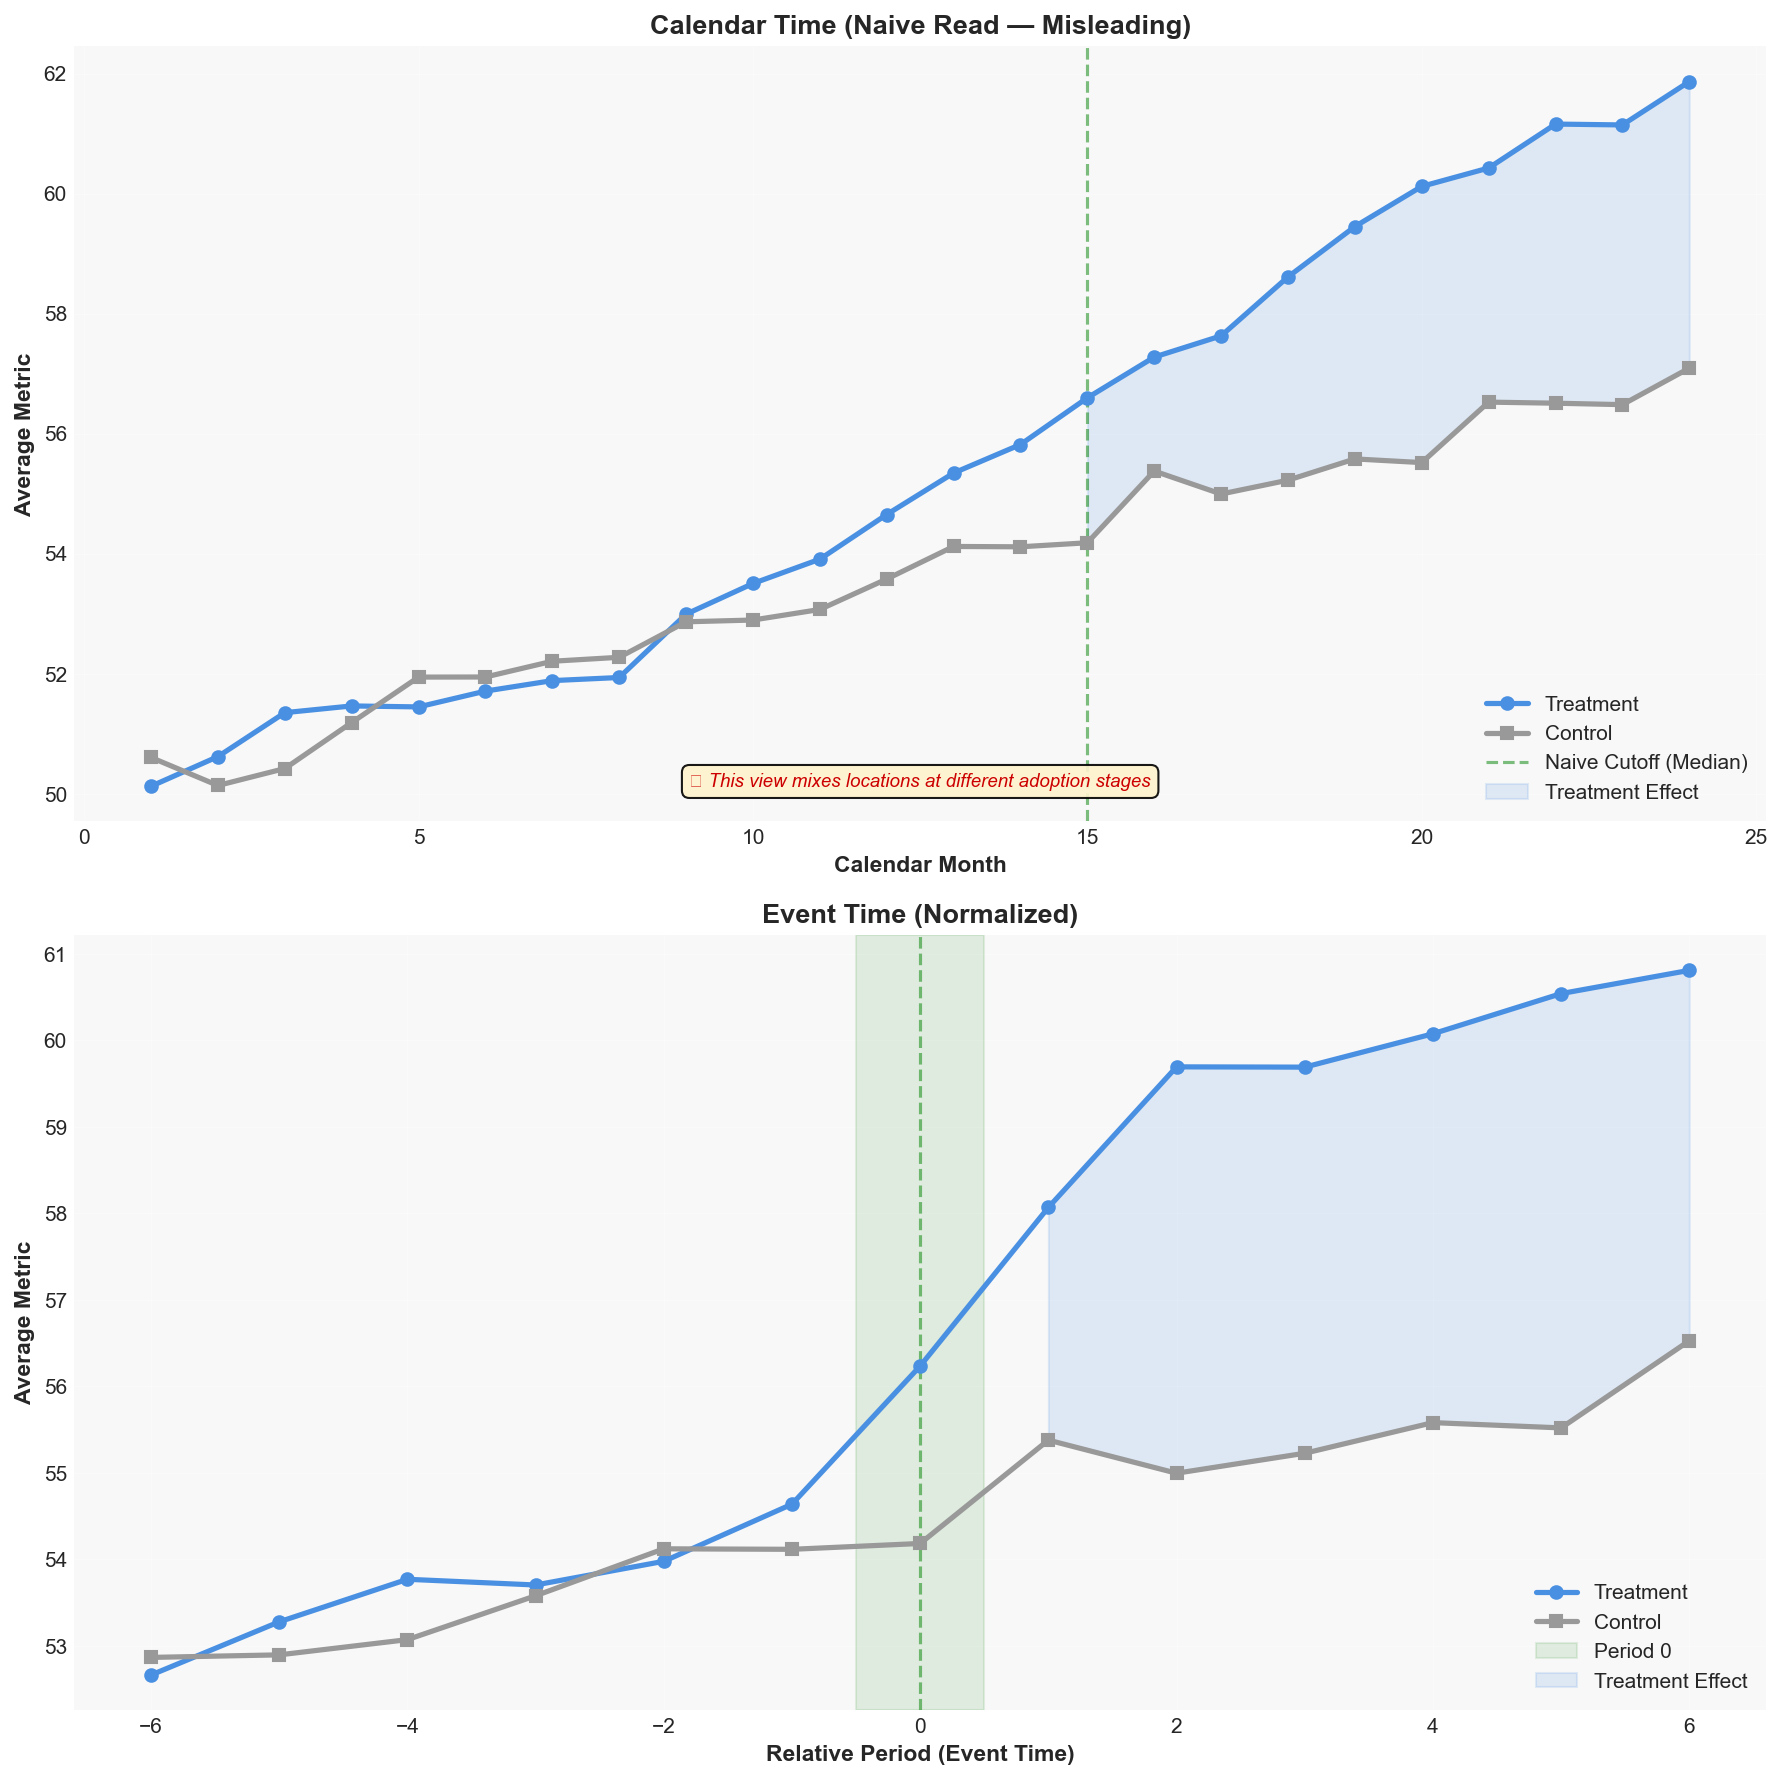
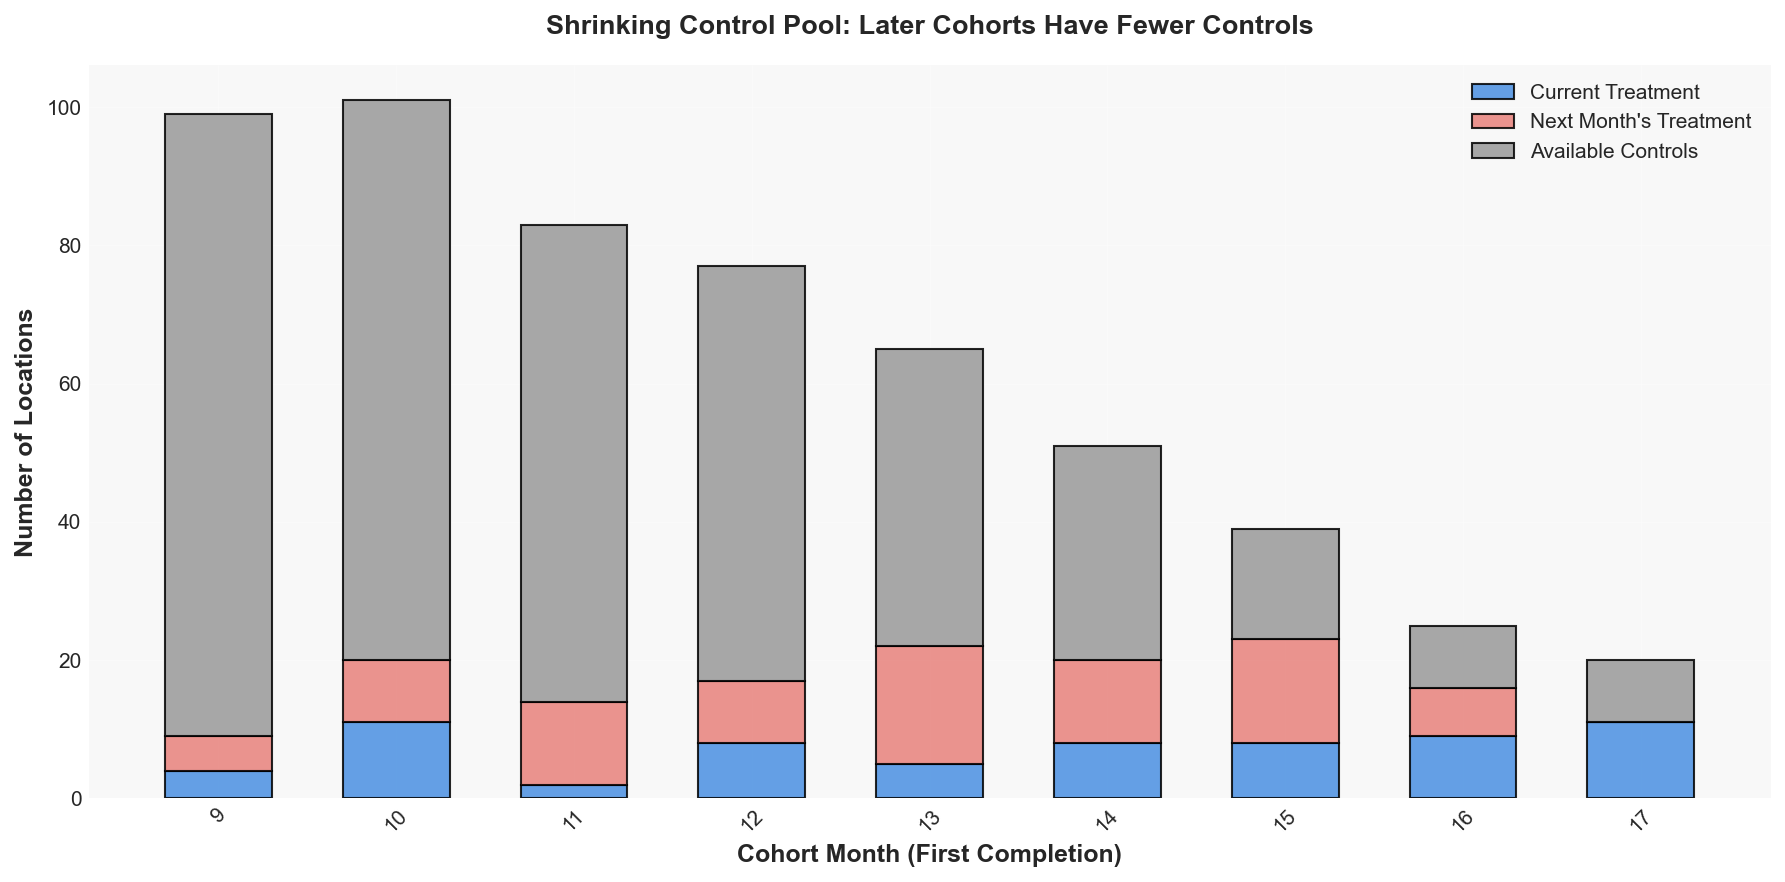
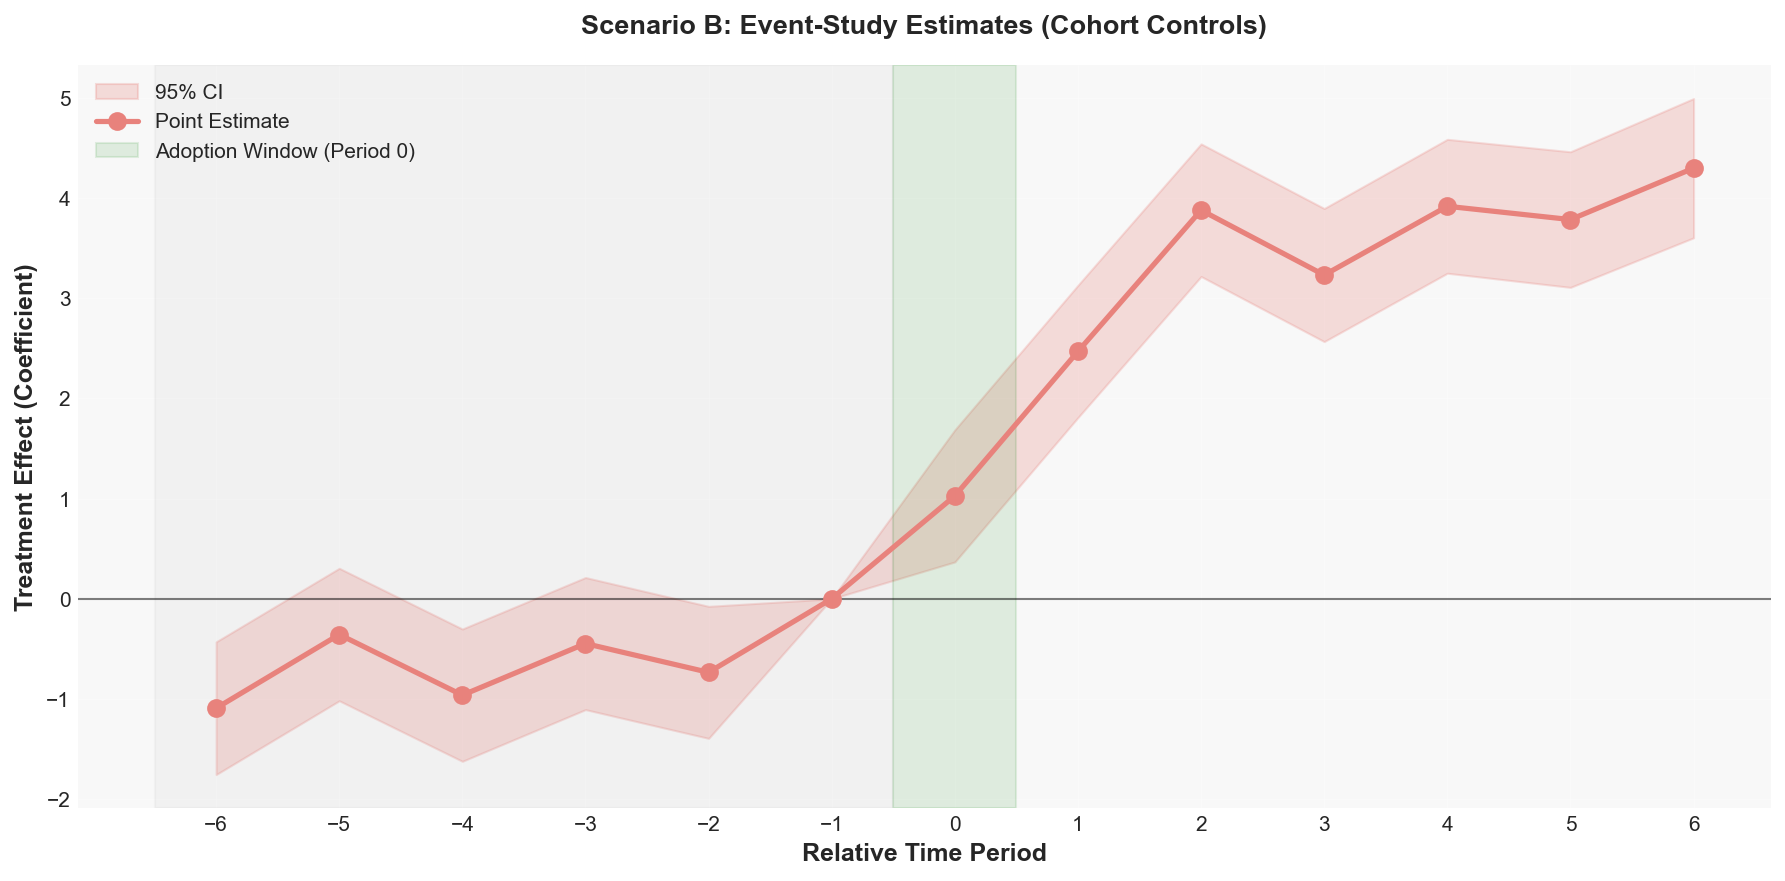
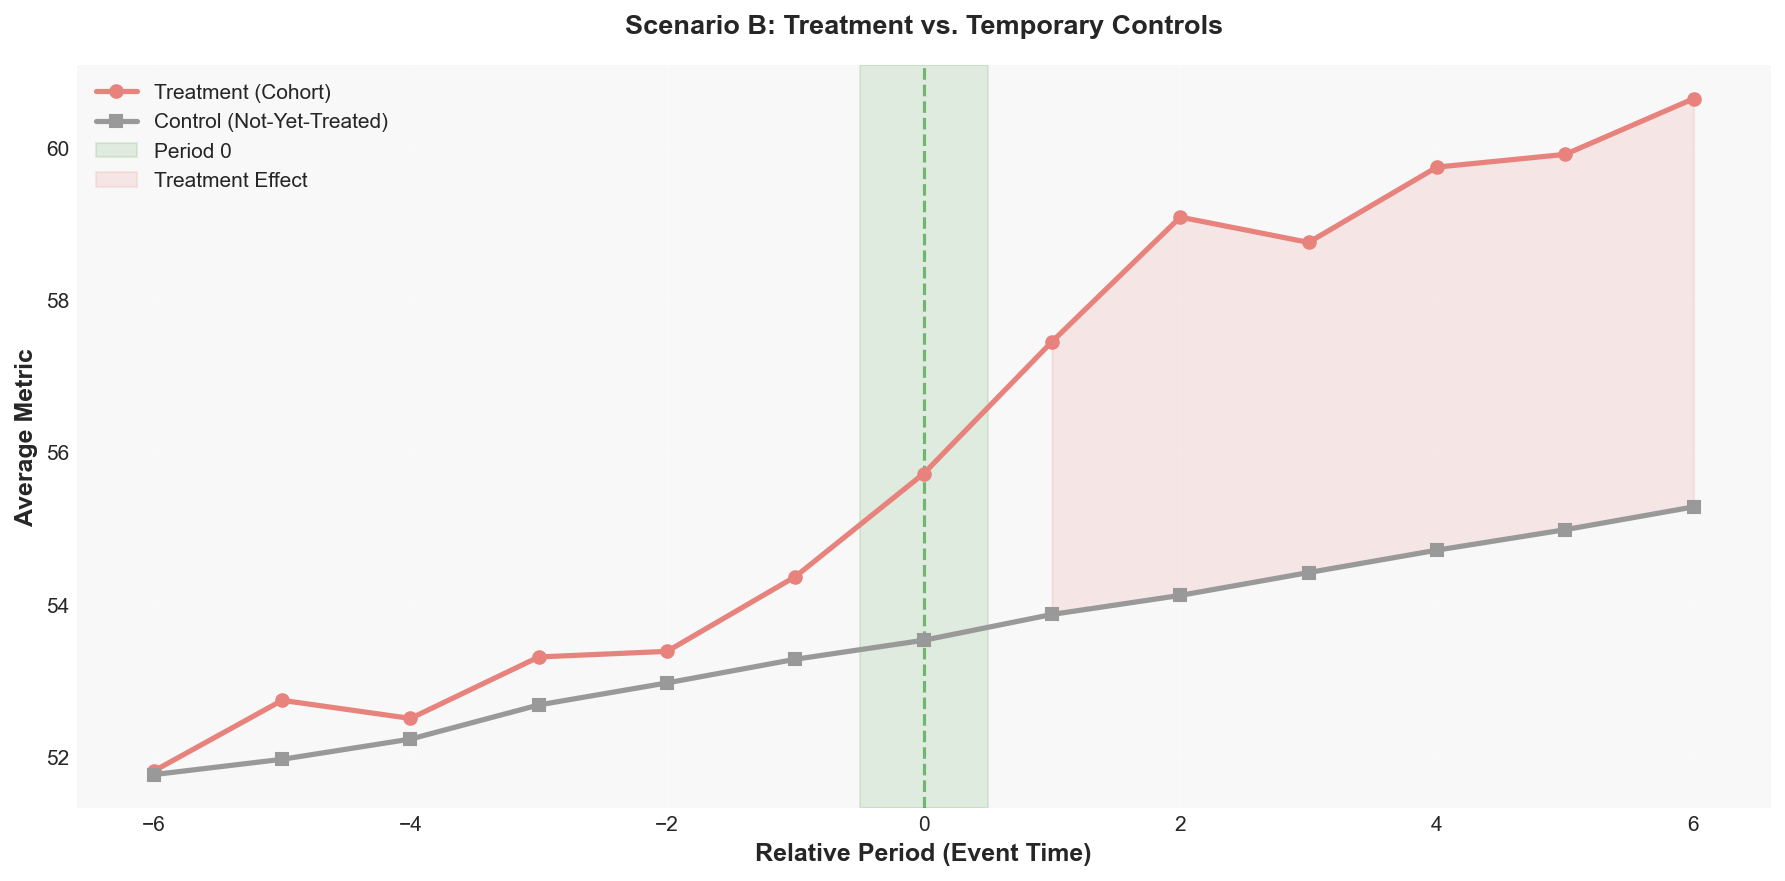
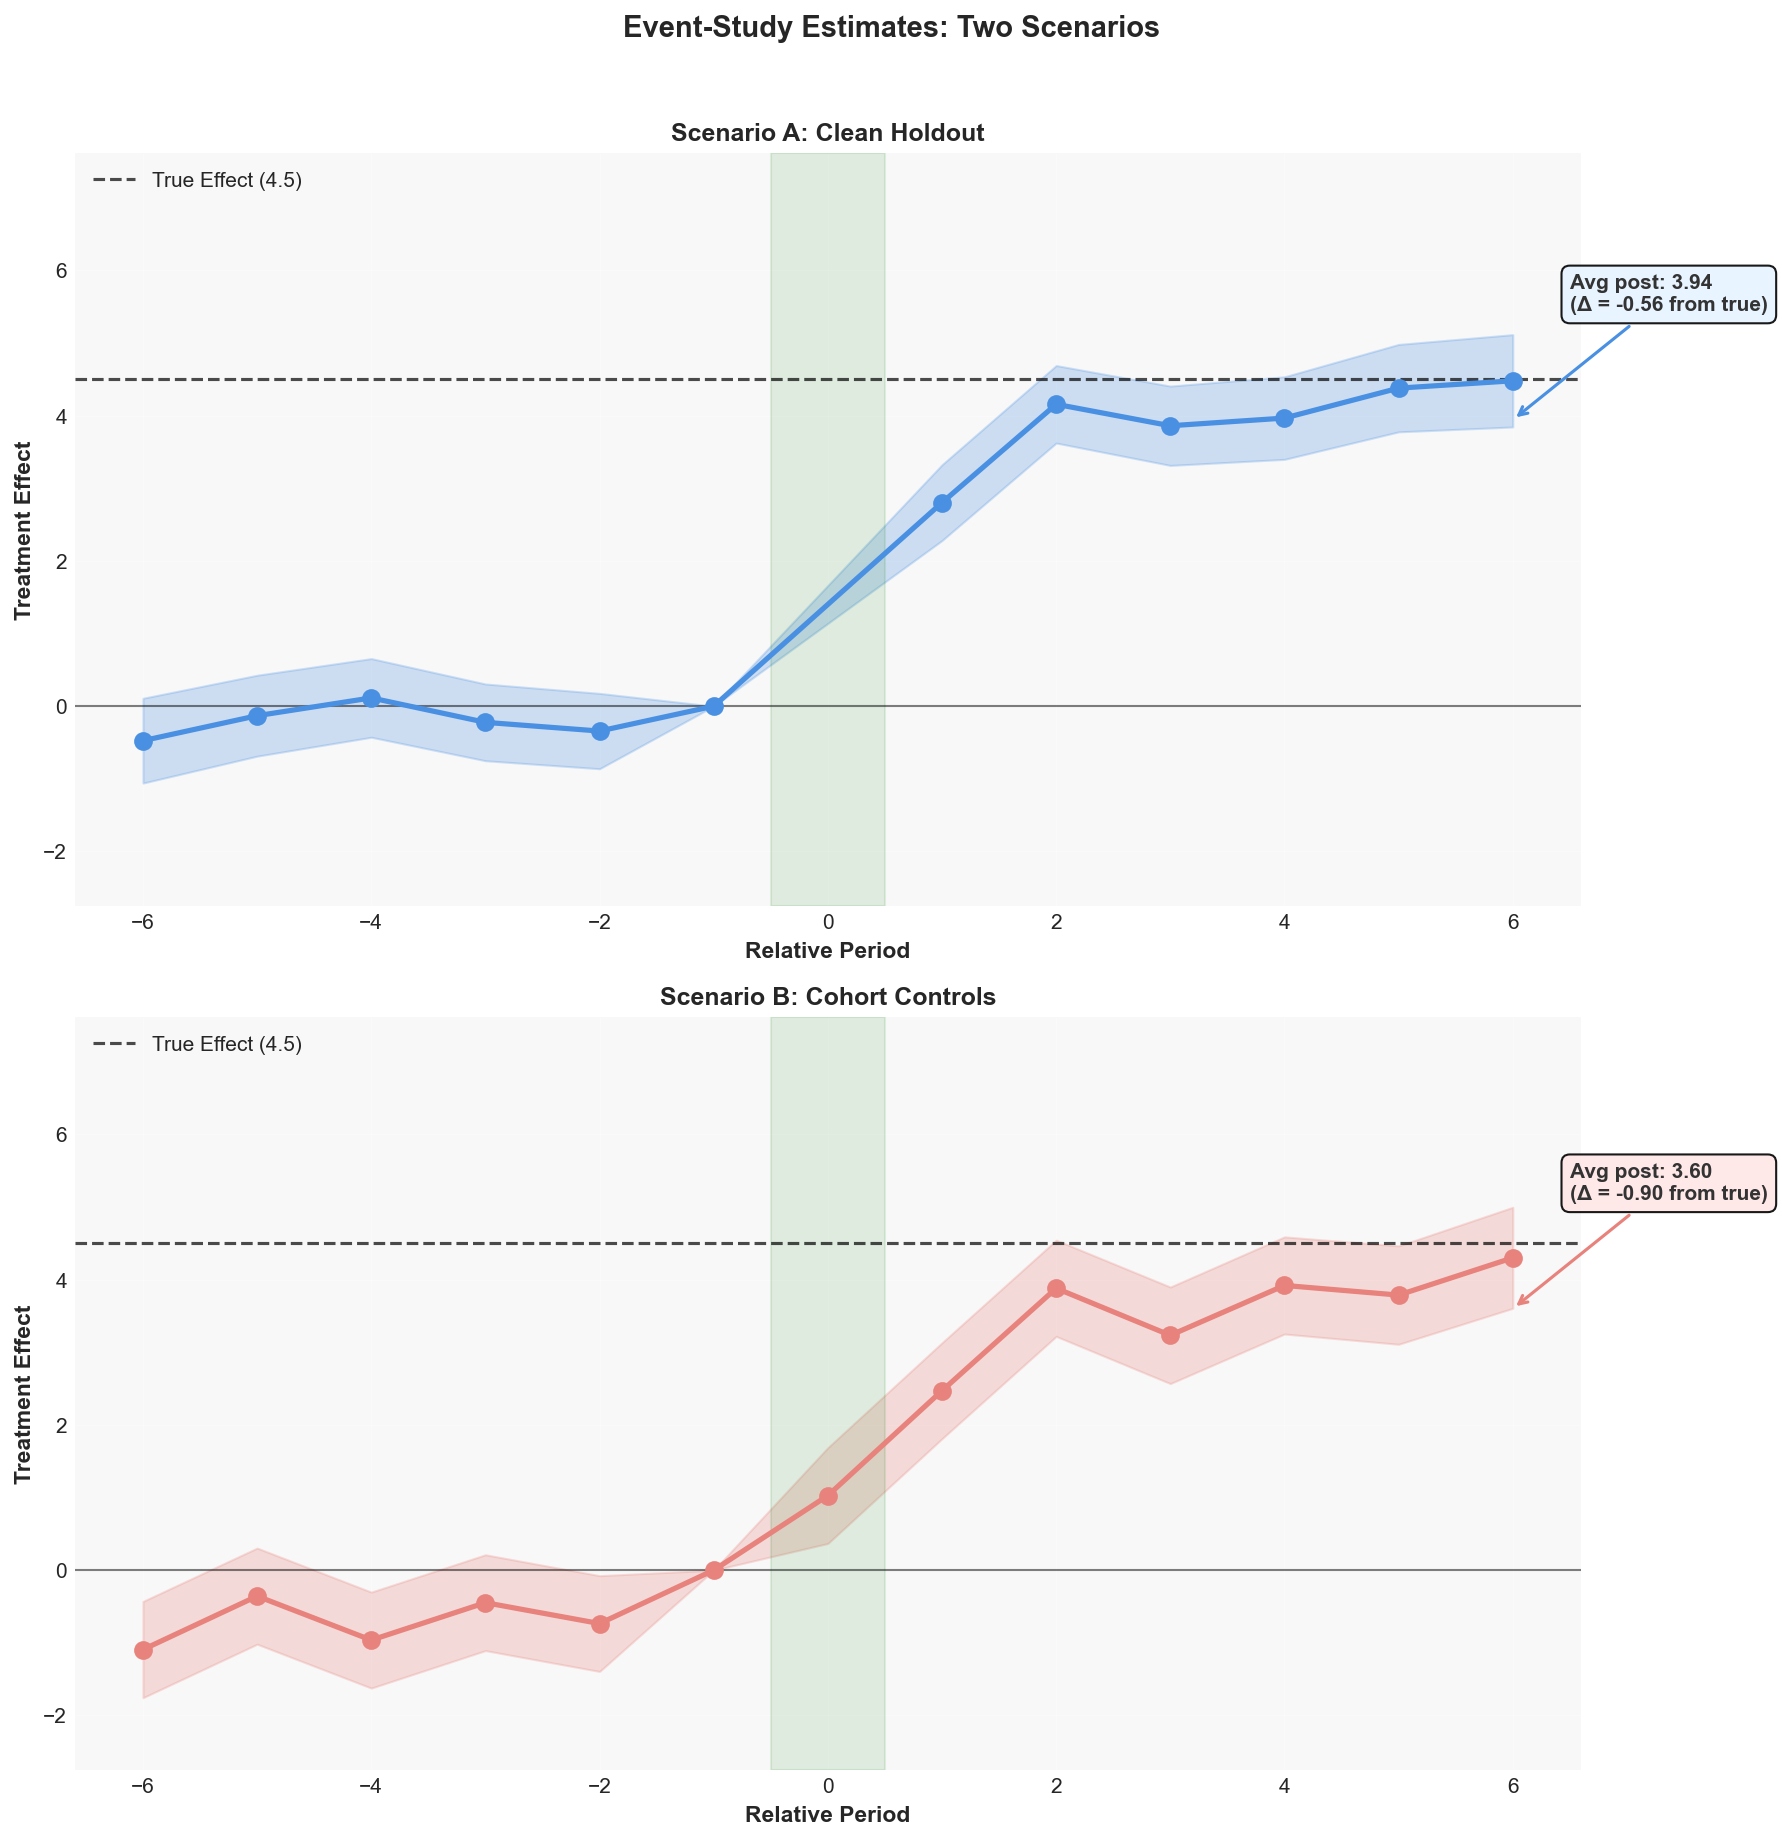
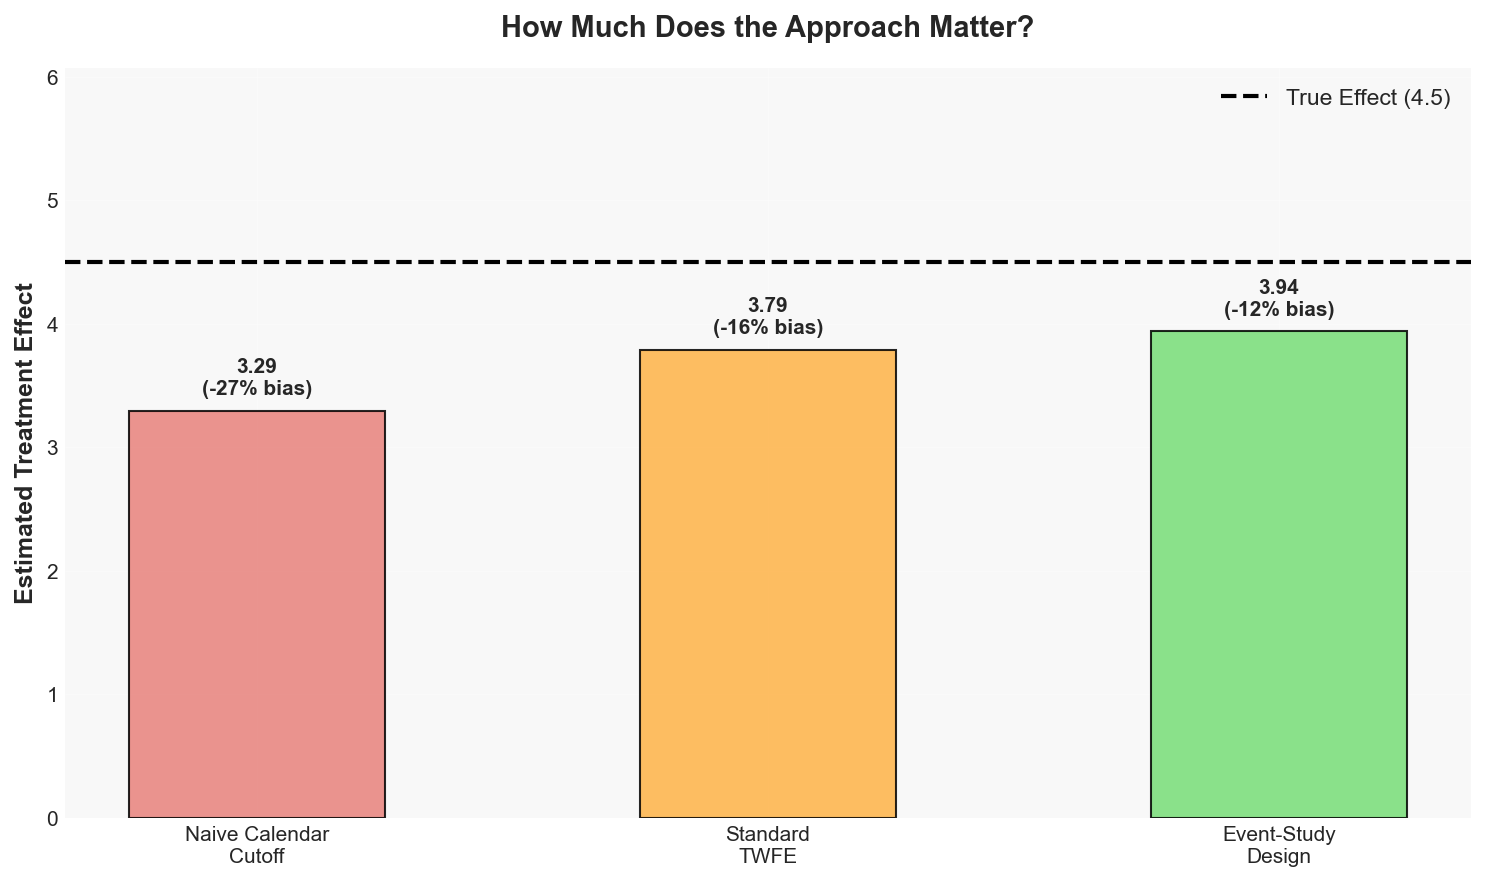
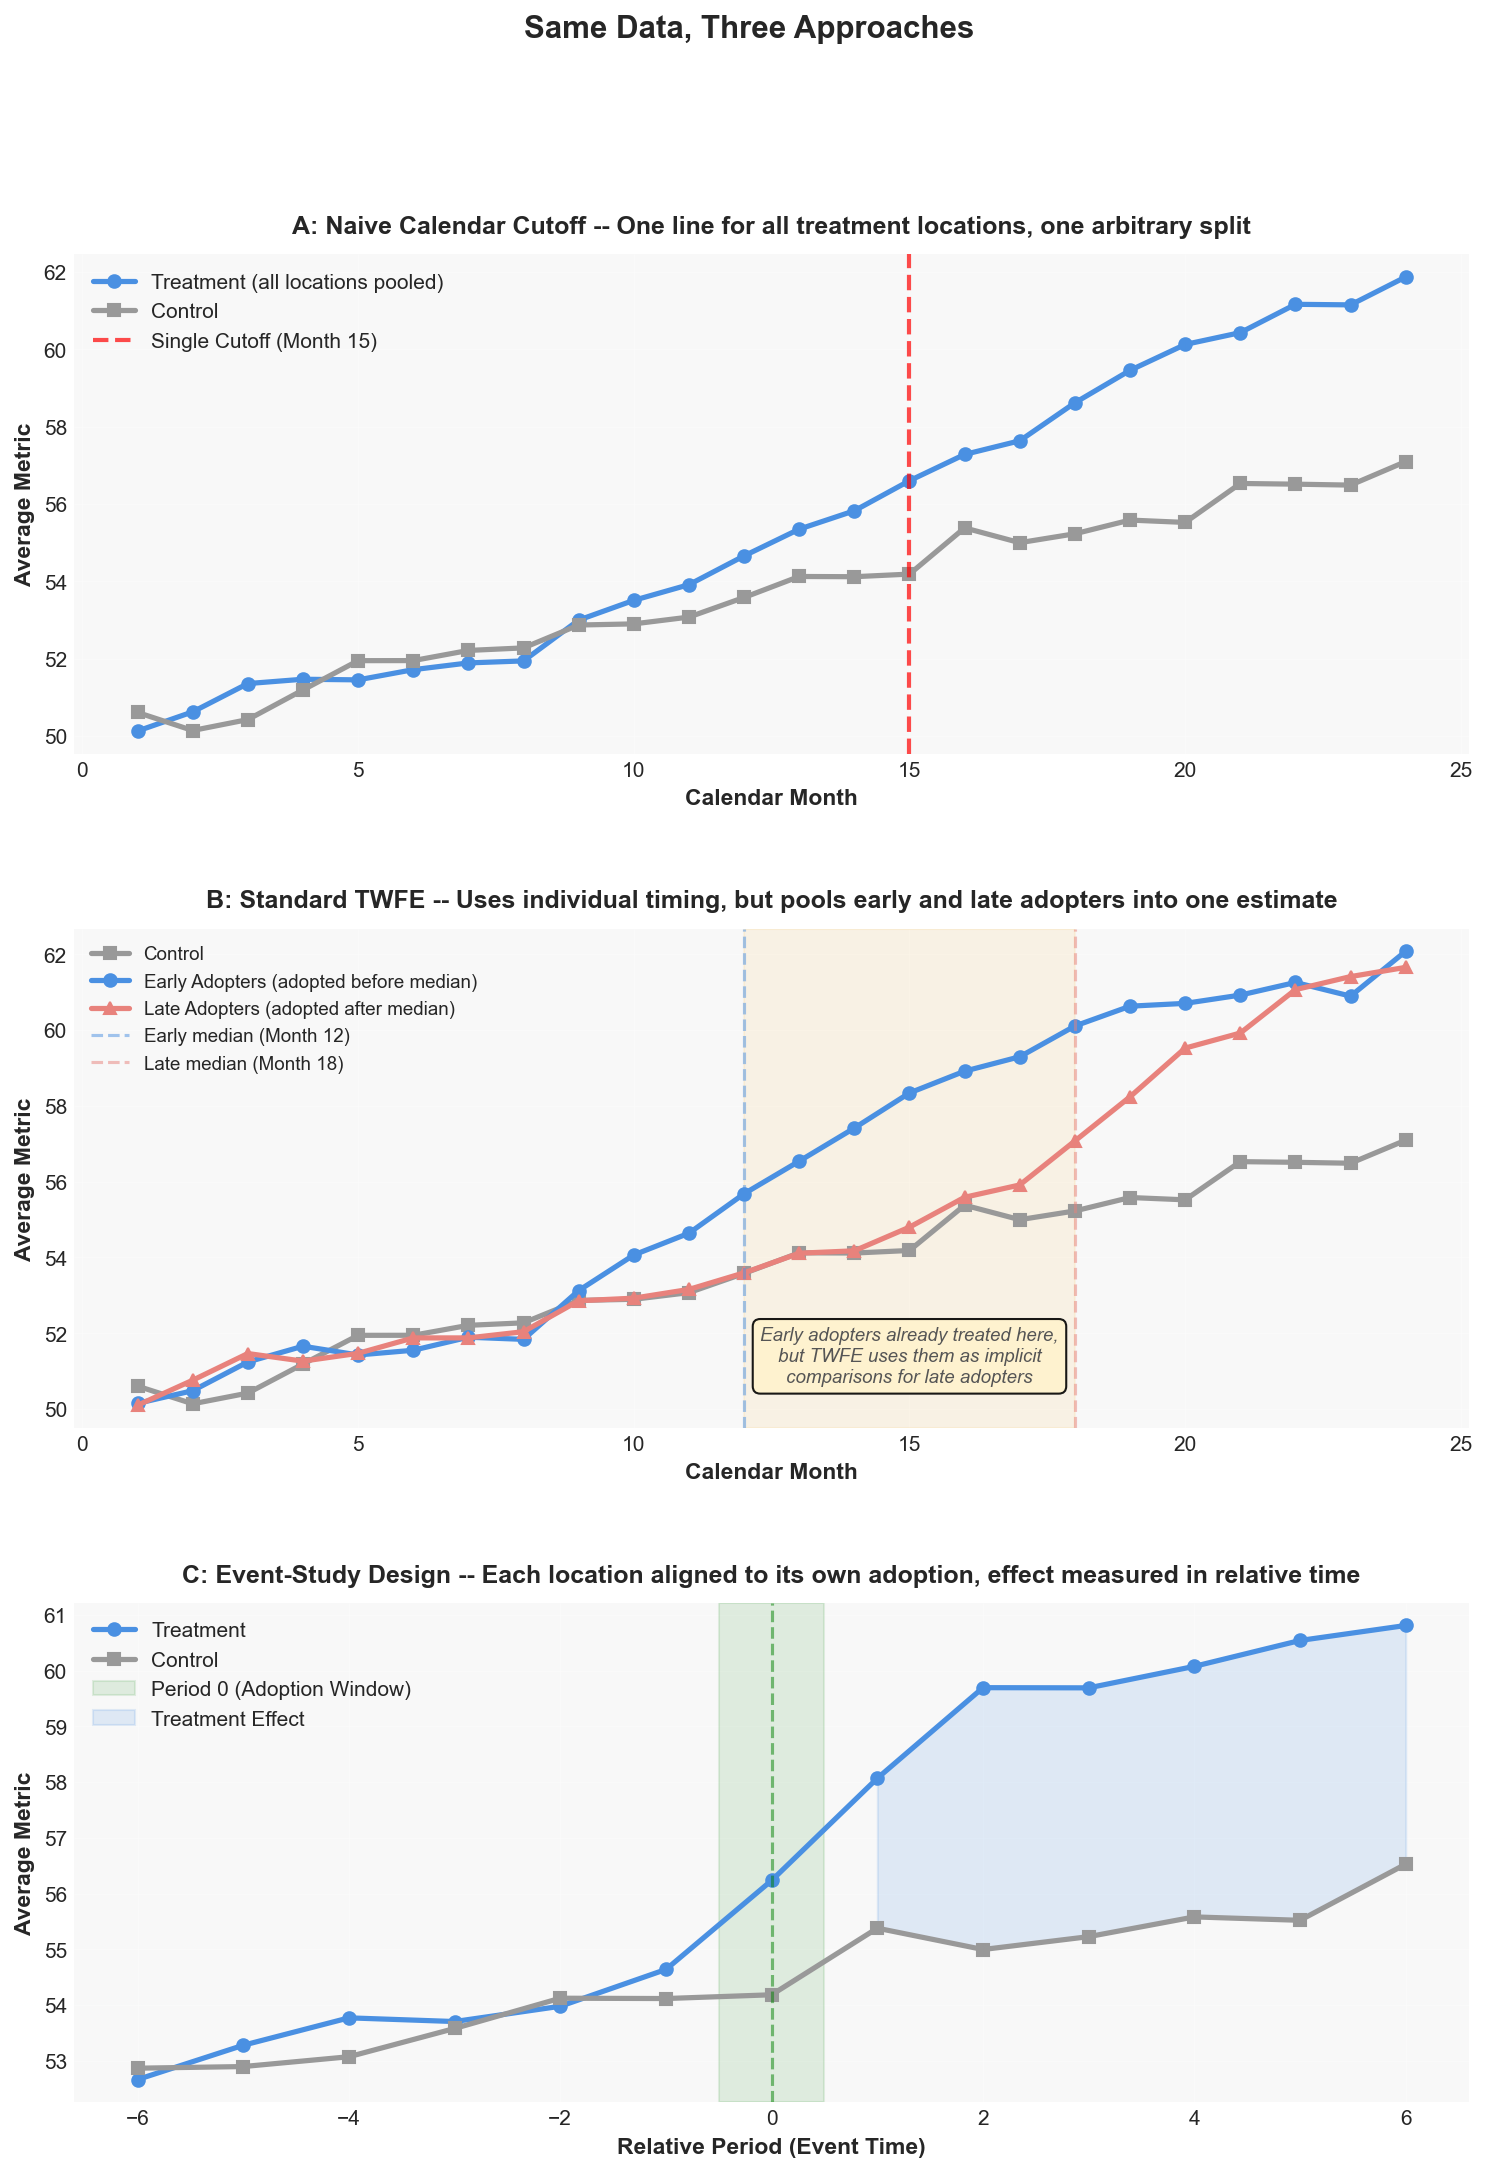
<hr />

<h2 id="introduction">Introduction</h2>

<p>Classification is the bread and butter of supervised machine learning. You have data with labels, and you want to predict labels for new data. Spam or not spam. Cat or dog. Will this customer churn?</p>

<p>In this post, we build three classifiers from scratch:</p>

<ol>
  <li><strong>Logistic Regression</strong>: A probabilistic model that learns a linear decision boundary</li>
  <li><strong>Naive Bayes</strong>: A generative model that applies Bayes’ theorem with independence assumptions</li>
  <li><strong>K-Nearest Neighbors (KNN)</strong>: A non-parametric method that classifies based on similar training examples</li>
</ol>

<p>We’ll derive the math, implement the algorithms, and compare their decision boundaries on real data.</p>

<p><strong>Just want the code?</strong> Skip to the <a href="#appendix-complete-implementations">Appendix</a> for copy-paste ready implementations.</p>

<hr />

<h2 id="part-1-logistic-regression">Part 1: Logistic Regression</h2>

<h3 id="the-problem">The Problem</h3>

<p>We have training data ${(x^{(1)}, y^{(1)}), (x^{(2)}, y^{(2)}), \ldots, (x^{(m)}, y^{(m)})}$ where:</p>
<ul>
  <li>$x^{(i)} \in \mathbb{R}^d$ is the feature vector for sample $i$</li>
  <li>$y^{(i)} \in {0, 1}$ is the binary label</li>
</ul>

<p>We want to learn parameters $\theta$ such that we can predict $P(y=1 \mid x)$ for new data points.</p>

<h3 id="the-model">The Model</h3>

<p><strong>Plain English:</strong> Logistic regression takes a linear combination of features $\theta^T x$ and squashes it through the sigmoid function to get a probability between 0 and 1.</p>

<p>The sigmoid (logistic) function is:</p>

\[\sigma(z) = \frac{1}{1 + e^{-z}}\]

<details>
<summary><strong>Why sigmoid?</strong></summary>
<p>The sigmoid has nice properties:</p>
<ul>
<li>Output is always between 0 and 1 (valid probability)</li>
<li>Monotonically increasing (higher scores → higher probabilities)</li>
<li>Smooth and differentiable everywhere</li>
<li>Simple derivative: σ'(z) = σ(z)(1 - σ(z))</li>
</ul>
</details>

<p>The probability that $y=1$ given features $x$ and parameters $\theta$:</p>

\[P(y=1 \mid x; \theta) = \sigma(\theta^T x) = \frac{1}{1 + e^{-\theta^T x}}\]

<p>And therefore:</p>

\[P(y=0 \mid x; \theta) = 1 - \sigma(\theta^T x) = \frac{e^{-\theta^T x}}{1 + e^{-\theta^T x}}\]

<h3 id="maximum-likelihood-estimation">Maximum Likelihood Estimation</h3>

<p>We want to find $\theta$ that makes our observed labels most likely. The likelihood function is:</p>

\[L(\theta) = \prod_{i=1}^{m} P(y^{(i)} \mid x^{(i)}; \theta)\]

<p>For binary labels, we can write this compactly as:</p>

\[L(\theta) = \prod_{i=1}^{m} \sigma(\theta^T x^{(i)})^{y^{(i)}} \cdot (1 - \sigma(\theta^T x^{(i)}))^{1-y^{(i)}}\]

<p>Taking the log (easier to work with):</p>

\[\ell(\theta) = \sum_{i=1}^{m} \left[ y^{(i)} \log \sigma(\theta^T x^{(i)}) + (1-y^{(i)}) \log(1 - \sigma(\theta^T x^{(i)})) \right]\]

<p>After some algebra, this simplifies to:</p>

\[\ell(\theta) = \sum_{i=1}^{m} \left[ -\log(1 + e^{-\theta^T x^{(i)}}) + (y^{(i)} - 1) \theta^T x^{(i)} \right]\]

<details>
<summary><strong>See the algebra step by step</strong></summary>
<p>Starting with the log-likelihood:</p>
<p>For a single sample with y=1:</p>
<ul>
<li>log σ(θᵀx) = log(1/(1+e⁻θᵀˣ)) = -log(1+e⁻θᵀˣ)</li>
</ul>
<p>For a single sample with y=0:</p>
<ul>
<li>log(1-σ(θᵀx)) = log(e⁻θᵀˣ/(1+e⁻θᵀˣ)) = -θᵀx - log(1+e⁻θᵀˣ)</li>
</ul>
<p>Combining these with the y⁽ⁱ⁾ and (1-y⁽ⁱ⁾) weighting gives the simplified form.</p>
</details>

<h3 id="deriving-the-gradient">Deriving the Gradient</h3>

<p>To maximize $\ell(\theta)$ using gradient ascent, we need $\frac{\partial \ell}{\partial \theta}$.</p>

<p>Let’s work through this using the chain rule. For the first part of $\ell(\theta)$:</p>

\[\frac{\partial}{\partial \theta}\left[-\log(1 + e^{-\theta^T x})\right]\]

<p>Let $n = -\theta^T x$, so we have $-\log(1 + e^n)$.</p>

\[\frac{\partial}{\partial n}\left[-\log(1 + e^n)\right] = -\frac{e^n}{1 + e^n}\]

<p>And $\frac{\partial n}{\partial \theta} = -x$.</p>

<p>By chain rule:</p>

\[\frac{\partial}{\partial \theta}\left[-\log(1 + e^{-\theta^T x})\right] = -\frac{e^{-\theta^T x}}{1 + e^{-\theta^T x}} \cdot (-x) = x \cdot \frac{e^{-\theta^T x}}{1 + e^{-\theta^T x}}\]

<p>For the second part $(y-1)\theta^T x$, the derivative is simply $(y-1)x$.</p>

<p>Combining:</p>

\[\frac{\partial \ell^{(i)}}{\partial \theta} = x^{(i)} \cdot \frac{e^{-\theta^T x^{(i)}}}{1 + e^{-\theta^T x^{(i)}}} + (y^{(i)} - 1) x^{(i)}\]

<p>This simplifies beautifully. Note that $\frac{e^{-\theta^T x}}{1 + e^{-\theta^T x}} = 1 - \sigma(\theta^T x)$:</p>

\[\frac{\partial \ell^{(i)}}{\partial \theta} = x^{(i)} \left[ (1 - \sigma(\theta^T x^{(i)})) + (y^{(i)} - 1) \right] = x^{(i)} \left[ y^{(i)} - \sigma(\theta^T x^{(i)}) \right]\]

<p><strong>The final gradient:</strong></p>

\[\nabla_\theta \ell(\theta) = \sum_{i=1}^{m} x^{(i)} \left[ y^{(i)} - \sigma(\theta^T x^{(i)}) \right]\]

<p>This has a nice interpretation: the gradient is the sum of feature vectors, each weighted by the “error” (actual label minus predicted probability).</p>

<details>
<summary><strong>See it with a tiny example</strong></summary>
<p><strong>Setup:</strong> Single feature (1D), single data point: x = 2, y = 1, current θ = 0.5</p>

<p><strong>Step 1: Compute prediction</strong></p>
<ul>
<li>θᵀx = 0.5 × 2 = 1</li>
<li>σ(1) = 1/(1+e⁻¹) ≈ 0.73</li>
</ul>

<p><strong>Step 2: Compute error</strong></p>
<ul>
<li>y - σ(θᵀx) = 1 - 0.73 = 0.27</li>
</ul>

<p><strong>Step 3: Compute gradient</strong></p>
<ul>
<li>∇θℓ = x × (y - σ(θᵀx)) = 2 × 0.27 = 0.54</li>
</ul>

<p><strong>Interpretation:</strong> The gradient is positive, so we should increase θ. This makes sense: we predicted 0.73 but the true label is 1, so we want to push the prediction higher by increasing θ.</p>
</details>

<h3 id="batch-gradient-descent">Batch Gradient Descent</h3>

<p>With the gradient in hand, we can use gradient ascent to find the optimal $\theta$:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">batch_gradient_descent</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">y</span><span class="p">,</span> <span class="n">gamma</span><span class="o">=</span><span class="mf">0.01</span><span class="p">,</span> <span class="n">epsilon</span><span class="o">=</span><span class="mf">1e-6</span><span class="p">,</span> <span class="n">max_iters</span><span class="o">=</span><span class="mi">10000</span><span class="p">):</span>
    <span class="s">"""
    Fit logistic regression using batch gradient descent.

    Parameters:
    - X: feature matrix (m samples, d features)
    - y: labels (m,)
    - gamma: learning rate
    - epsilon: convergence threshold
    - max_iters: maximum iterations

    Returns:
    - theta: learned parameters (d,)
    """</span>
    <span class="n">m</span><span class="p">,</span> <span class="n">d</span> <span class="o">=</span> <span class="n">X</span><span class="p">.</span><span class="n">shape</span>
    <span class="n">theta</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">zeros</span><span class="p">(</span><span class="n">d</span><span class="p">)</span>  <span class="c1"># Initialize parameters to zero
</span>
    <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">max_iters</span><span class="p">):</span>
        <span class="c1"># Compute predictions for all samples
</span>        <span class="c1"># sigma(theta^T x) for each x
</span>        <span class="n">z</span> <span class="o">=</span> <span class="n">X</span> <span class="o">@</span> <span class="n">theta</span>  <span class="c1"># Shape: (m,)
</span>        <span class="n">predictions</span> <span class="o">=</span> <span class="mi">1</span> <span class="o">/</span> <span class="p">(</span><span class="mi">1</span> <span class="o">+</span> <span class="n">np</span><span class="p">.</span><span class="n">exp</span><span class="p">(</span><span class="o">-</span><span class="n">z</span><span class="p">))</span>  <span class="c1"># Sigmoid
</span>
        <span class="c1"># Compute gradient: sum over all samples of x_i * (y_i - pred_i)
</span>        <span class="n">errors</span> <span class="o">=</span> <span class="n">y</span> <span class="o">-</span> <span class="n">predictions</span>  <span class="c1"># Shape: (m,)
</span>        <span class="n">gradient</span> <span class="o">=</span> <span class="n">X</span><span class="p">.</span><span class="n">T</span> <span class="o">@</span> <span class="n">errors</span>  <span class="c1"># Shape: (d,)
</span>
        <span class="c1"># Update parameters (gradient ascent, so we add)
</span>        <span class="n">theta_new</span> <span class="o">=</span> <span class="n">theta</span> <span class="o">+</span> <span class="n">gamma</span> <span class="o">*</span> <span class="n">gradient</span>

        <span class="c1"># Check convergence
</span>        <span class="k">if</span> <span class="n">np</span><span class="p">.</span><span class="n">linalg</span><span class="p">.</span><span class="n">norm</span><span class="p">(</span><span class="n">theta_new</span> <span class="o">-</span> <span class="n">theta</span><span class="p">)</span> <span class="o">&lt;</span> <span class="n">epsilon</span><span class="p">:</span>
            <span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">"Converged in </span><span class="si">{</span><span class="n">t</span><span class="o">+</span><span class="mi">1</span><span class="si">}</span><span class="s"> iterations"</span><span class="p">)</span>
            <span class="k">break</span>

        <span class="n">theta</span> <span class="o">=</span> <span class="n">theta_new</span>

    <span class="k">return</span> <span class="n">theta</span>
</code></pre></div></div>

<p><strong>What happens if you change gamma?</strong> Too large and you’ll overshoot the optimum, potentially diverging. Too small and convergence will be slow. A common approach: start with $\gamma = 0.01$ and decrease it if you see oscillation.</p>

<h3 id="stochastic-gradient-descent">Stochastic Gradient Descent</h3>

<p>Batch gradient descent computes the gradient using all $m$ samples. For large datasets, this is expensive. Stochastic gradient descent (SGD) updates after each sample:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">stochastic_gradient_descent</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">y</span><span class="p">,</span> <span class="n">gamma</span><span class="o">=</span><span class="mf">0.01</span><span class="p">,</span> <span class="n">epsilon</span><span class="o">=</span><span class="mf">1e-6</span><span class="p">,</span> <span class="n">max_iters</span><span class="o">=</span><span class="mi">10000</span><span class="p">):</span>
    <span class="s">"""
    Fit logistic regression using stochastic gradient descent.

    Parameters:
    - X: feature matrix (m samples, d features)
    - y: labels (m,)
    - gamma: learning rate
    - epsilon: convergence threshold
    - max_iters: maximum passes through the data

    Returns:
    - theta: learned parameters (d,)
    """</span>
    <span class="n">m</span><span class="p">,</span> <span class="n">d</span> <span class="o">=</span> <span class="n">X</span><span class="p">.</span><span class="n">shape</span>
    <span class="n">theta</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">zeros</span><span class="p">(</span><span class="n">d</span><span class="p">)</span>

    <span class="k">for</span> <span class="n">epoch</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">max_iters</span><span class="p">):</span>
        <span class="n">theta_old</span> <span class="o">=</span> <span class="n">theta</span><span class="p">.</span><span class="n">copy</span><span class="p">()</span>

        <span class="c1"># Shuffle data each epoch for better convergence
</span>        <span class="n">indices</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">permutation</span><span class="p">(</span><span class="n">m</span><span class="p">)</span>

        <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="n">indices</span><span class="p">:</span>
            <span class="c1"># Single sample gradient
</span>            <span class="n">x_i</span> <span class="o">=</span> <span class="n">X</span><span class="p">[</span><span class="n">i</span><span class="p">]</span>
            <span class="n">y_i</span> <span class="o">=</span> <span class="n">y</span><span class="p">[</span><span class="n">i</span><span class="p">]</span>

            <span class="n">z</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">dot</span><span class="p">(</span><span class="n">theta</span><span class="p">,</span> <span class="n">x_i</span><span class="p">)</span>
            <span class="n">prediction</span> <span class="o">=</span> <span class="mi">1</span> <span class="o">/</span> <span class="p">(</span><span class="mi">1</span> <span class="o">+</span> <span class="n">np</span><span class="p">.</span><span class="n">exp</span><span class="p">(</span><span class="o">-</span><span class="n">z</span><span class="p">))</span>

            <span class="c1"># Update using single sample
</span>            <span class="n">gradient</span> <span class="o">=</span> <span class="n">x_i</span> <span class="o">*</span> <span class="p">(</span><span class="n">y_i</span> <span class="o">-</span> <span class="n">prediction</span><span class="p">)</span>
            <span class="n">theta</span> <span class="o">=</span> <span class="n">theta</span> <span class="o">+</span> <span class="n">gamma</span> <span class="o">*</span> <span class="n">gradient</span>

        <span class="c1"># Check convergence after each epoch
</span>        <span class="k">if</span> <span class="n">np</span><span class="p">.</span><span class="n">linalg</span><span class="p">.</span><span class="n">norm</span><span class="p">(</span><span class="n">theta</span> <span class="o">-</span> <span class="n">theta_old</span><span class="p">)</span> <span class="o">&lt;</span> <span class="n">epsilon</span><span class="p">:</span>
            <span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">"Converged in </span><span class="si">{</span><span class="n">epoch</span><span class="o">+</span><span class="mi">1</span><span class="si">}</span><span class="s"> epochs"</span><span class="p">)</span>
            <span class="k">break</span>

    <span class="k">return</span> <span class="n">theta</span>
</code></pre></div></div>

<table>
  <thead>
    <tr>
      <th>Aspect</th>
      <th>Batch GD</th>
      <th>Stochastic GD</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Update frequency</td>
      <td>Once per pass through data</td>
      <td>After each sample</td>
    </tr>
    <tr>
      <td>Gradient estimate</td>
      <td>Exact (uses all data)</td>
      <td>Noisy (single sample)</td>
    </tr>
    <tr>
      <td>Memory</td>
      <td>Needs all data in memory</td>
      <td>Processes one sample at a time</td>
    </tr>
    <tr>
      <td>Convergence</td>
      <td>Smooth path to optimum</td>
      <td>Noisy but can escape local minima</td>
    </tr>
    <tr>
      <td>Best for</td>
      <td>Small to medium datasets</td>
      <td>Large datasets</td>
    </tr>
  </tbody>
</table>

<h3 id="why-gradient-descent-works-concavity">Why Gradient Descent Works: Concavity</h3>

<p>How do we know gradient ascent will find the global maximum? Because the log-likelihood is <strong>concave</strong>.</p>

<p>A function is concave if its second derivative is negative (or the Hessian is negative semi-definite for multivariate functions).</p>

<p>Let’s check. Taking the second derivative of $\ell(\theta)$:</p>

<p>The first derivative (gradient) for a single sample is:
\(\frac{\partial \ell^{(i)}}{\partial \theta} = x^{(i)}(y^{(i)} - \sigma(\theta^T x^{(i)}))\)</p>

<p>The $(y^{(i)} - 1)x^{(i)}$ term is constant with respect to $\theta$, so its second derivative is zero.</p>

<p>For the other term, we need $\frac{\partial}{\partial \theta}\left[x^{(i)} \cdot \frac{e^{-\theta^T x^{(i)}}}{1+e^{-\theta^T x^{(i)}}}\right]$.</p>

<p>Using the derivative of $\frac{e^u}{1+e^u}$ which is $\frac{e^u(1-e^u)}{(1+e^u)^2}$:</p>

\[\frac{\partial^2 \ell^{(i)}}{\partial \theta^2} = -x^{(i)}(x^{(i)})^T \cdot \sigma(\theta^T x^{(i)}) \cdot (1 - \sigma(\theta^T x^{(i)}))\]

<p>Since $\sigma(z) \in (0,1)$, we have $\sigma(z)(1-\sigma(z)) &gt; 0$.</p>

<p>Therefore: $\frac{\partial^2 \ell}{\partial \theta^2} \leq 0$ for all $\theta$.</p>

<p><strong>Conclusion:</strong> The log-likelihood is concave, so any local maximum is also the global maximum. Gradient ascent will find it.</p>

<hr />

<h2 id="part-2-naive-bayes-for-text-classification">Part 2: Naive Bayes for Text Classification</h2>

<h3 id="the-problem-1">The Problem</h3>

<p>We have text documents (like movie reviews or emails) and we want to classify them into categories (positive/negative sentiment, spam/not spam).</p>

<h3 id="the-bayes-classifier">The Bayes Classifier</h3>

<p>Using Bayes’ theorem:</p>

\[P(y = c \mid x) = \frac{P(x \mid y = c) \cdot P(y = c)}{P(x)}\]

<p>Where:</p>
<ul>
  <li>$P(y = c \mid x)$ is the <strong>posterior</strong>: probability of class $c$ given the features</li>
  <li>$P(x \mid y = c)$ is the <strong>likelihood</strong>: probability of seeing these features given class $c$</li>
  <li>$P(y = c)$ is the <strong>prior</strong>: base rate of class $c$</li>
  <li>$P(x)$ is the <strong>evidence</strong>: total probability of the features (normalizing constant)</li>
</ul>

<p>For classification, we pick the class with highest posterior:</p>

\[\hat{y} = \arg\max_c P(y = c \mid x) = \arg\max_c P(x \mid y = c) \cdot P(y = c)\]

<p>We can ignore $P(x)$ since it’s the same for all classes.</p>

<h3 id="the-naive-assumption">The “Naive” Assumption</h3>

<p>Computing $P(x \mid y = c)$ is hard because $x$ is a high-dimensional vector (e.g., word counts). If we have $d$ binary features, there are $2^d$ possible feature combinations.</p>

<p>The <strong>naive</strong> assumption: features are conditionally independent given the class.</p>

\[P(x \mid y = c) = \prod_{k=1}^{d} P(x_k \mid y = c)\]

<p>This reduces the problem from learning $2^d$ probabilities to learning $d$ probabilities per class.</p>

<details>
<summary><strong>Why is this assumption "naive"?</strong></summary>
<p>In text, words are clearly not independent. "New York" tends to appear together. "Not good" has different meaning than "good" alone.</p>
<p>Yet Naive Bayes often works well despite this. Why?</p>
<ul>
<li>We only need to get the ranking right, not exact probabilities</li>
<li>Errors in independence assumption may cancel out</li>
<li>With limited data, simpler models can outperform complex ones</li>
</ul>
</details>

<h3 id="multinomial-naive-bayes-for-text">Multinomial Naive Bayes for Text</h3>

<p>For text, we represent each document as a vector of word counts: $x = (x_1, x_2, \ldots, x_d)$ where $x_k$ is how many times word $k$ appears.</p>

<p><strong>Estimating the prior:</strong></p>

\[P(y = c) = \frac{\text{number of documents in class } c}{\text{total documents}} = \frac{\sum_{i=1}^{n} \mathbf{1}(y^{(i)} = c)}{n}\]

<p><strong>Estimating word probabilities:</strong></p>

<p>For each class $c$ and word $k$, we estimate:</p>

\[\theta_{c,k} = P(\text{word } k \mid \text{class } c) = \frac{M_{c,k}}{N_c}\]

<p>Where:</p>
<ul>
  <li>$M_{c,k}$ = total count of word $k$ in all documents of class $c$</li>
  <li>$N_c$ = total word count across all documents of class $c$</li>
</ul>

<details>
<summary><strong>Deriving this with MLE</strong></summary>
<p>We want to find the word probabilities that maximize the likelihood of the observed word counts.</p>

<p><strong>Setup:</strong> For class c, we observe word counts c_k for each word k. We want q_k = P(word k | class c) that maximizes:</p>

<p>q* = argmax Σₖ cₖ log qₖ</p>

<p>subject to Σₖ qₖ = 1 (probabilities must sum to 1).</p>

<p><strong>Using Lagrange multipliers:</strong></p>

<p>L(q, λ) = Σₖ cₖ log qₖ - λ(Σₖ qₖ - 1)</p>

<p>Taking the derivative with respect to qₖ and setting to zero:</p>

<p>∂L/∂qₖ = cₖ/qₖ - λ = 0 → qₖ = cₖ/λ</p>

<p>Using the constraint Σₖ qₖ = 1:</p>

<p>Σₖ (cₖ/λ) = 1 → λ = Σₖ cₖ</p>

<p>Therefore:</p>

<p>qₖ = cₖ / Σₖ' cₖ'</p>

<p>This is exactly our MLE formula: word count divided by total words.</p>
</details>

<h3 id="example-sentiment-classification">Example: Sentiment Classification</h3>

<p>Let’s work through a concrete example.</p>

<p><strong>Training data:</strong></p>

<table>
  <thead>
    <tr>
      <th>Sentence</th>
      <th>Label</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>“I love this movie”</td>
      <td>Positive</td>
    </tr>
    <tr>
      <td>“Such an amazing experience”</td>
      <td>Positive</td>
    </tr>
    <tr>
      <td>“Best day of my life”</td>
      <td>Positive</td>
    </tr>
    <tr>
      <td>“This movie is terrible”</td>
      <td>Negative</td>
    </tr>
    <tr>
      <td>“I hate this product”</td>
      <td>Negative</td>
    </tr>
    <tr>
      <td>“Worst service ever”</td>
      <td>Negative</td>
    </tr>
    <tr>
      <td>“Such a bad experience”</td>
      <td>Negative</td>
    </tr>
  </tbody>
</table>

<p><strong>Step 1: Compute priors</strong></p>
<ul>
  <li>$P(\text{Positive}) = 3/7$</li>
  <li>$P(\text{Negative}) = 4/7$</li>
</ul>

<p><strong>Step 2: Build vocabulary and count words</strong></p>

<p>Positive class (13 total words):</p>
<ul>
  <li>I: 1, love: 1, this: 1, movie: 1, such: 1, an: 1, amazing: 1, experience: 1, best: 1, day: 1, of: 1, my: 1, life: 1</li>
</ul>

<p>Negative class (15 total words):</p>
<ul>
  <li>this: 1, movie: 1, is: 1, terrible: 1, I: 1, hate: 1, product: 1, worst: 1, service: 1, ever: 1, such: 1, a: 1, bad: 1, experience: 1</li>
</ul>

<p><strong>Step 3: Compute word probabilities</strong></p>

<table>
  <thead>
    <tr>
      <th>Word</th>
      <th>$\theta_{\text{pos}}$</th>
      <th>$\theta_{\text{neg}}$</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>I</td>
      <td>1/13</td>
      <td>1/15</td>
    </tr>
    <tr>
      <td>love</td>
      <td>1/13</td>
      <td>0</td>
    </tr>
    <tr>
      <td>this</td>
      <td>1/13</td>
      <td>1/15</td>
    </tr>
    <tr>
      <td>movie</td>
      <td>1/13</td>
      <td>1/15</td>
    </tr>
    <tr>
      <td>experience</td>
      <td>1/13</td>
      <td>1/15</td>
    </tr>
    <tr>
      <td>terrible</td>
      <td>0</td>
      <td>1/15</td>
    </tr>
    <tr>
      <td>…</td>
      <td>…</td>
      <td>…</td>
    </tr>
  </tbody>
</table>

<p><strong>Step 4: Classify a new sentence</strong></p>

<p>Test sentence: “I experience this movie”</p>

\[P(\text{Pos} \mid x) \propto P(\text{Pos}) \cdot P(\text{I} \mid \text{Pos}) \cdot P(\text{experience} \mid \text{Pos}) \cdot P(\text{this} \mid \text{Pos}) \cdot P(\text{movie} \mid \text{Pos})\]

\[= \frac{3}{7} \times \frac{1}{13} \times \frac{1}{13} \times \frac{1}{13} \times \frac{1}{13} = \frac{3}{7 \times 13^4}\]

\[P(\text{Neg} \mid x) \propto \frac{4}{7} \times \frac{1}{15} \times \frac{1}{15} \times \frac{1}{15} \times \frac{1}{15} = \frac{4}{7 \times 15^4}\]

<p>Normalizing:</p>
<ul>
  <li>$P(\text{Positive} \mid x) \approx 57\%$</li>
  <li>$P(\text{Negative} \mid x) \approx 43\%$</li>
</ul>

<p><strong>Classification: Positive</strong> (which makes sense given the neutral-to-positive words)</p>

<h3 id="implementation">Implementation</h3>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">numpy</span> <span class="k">as</span> <span class="n">np</span>

<span class="k">class</span> <span class="nc">NaiveBayesClassifier</span><span class="p">:</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">1.0</span><span class="p">):</span>
        <span class="s">"""
        Initialize Naive Bayes classifier.

        Parameters:
        - alpha: Laplace smoothing parameter (prevents zero probabilities)
        """</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">alpha</span> <span class="o">=</span> <span class="n">alpha</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">class_priors</span> <span class="o">=</span> <span class="p">{}</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">word_probs</span> <span class="o">=</span> <span class="p">{}</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">vocab</span> <span class="o">=</span> <span class="nb">set</span><span class="p">()</span>

    <span class="k">def</span> <span class="nf">fit</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">X</span><span class="p">,</span> <span class="n">y</span><span class="p">):</span>
        <span class="s">"""
        Train the classifier.

        Parameters:
        - X: list of documents (each document is a list of words)
        - y: list of labels
        """</span>
        <span class="c1"># Build vocabulary
</span>        <span class="k">for</span> <span class="n">doc</span> <span class="ow">in</span> <span class="n">X</span><span class="p">:</span>
            <span class="bp">self</span><span class="p">.</span><span class="n">vocab</span><span class="p">.</span><span class="n">update</span><span class="p">(</span><span class="n">doc</span><span class="p">)</span>

        <span class="c1"># Count documents per class
</span>        <span class="n">classes</span> <span class="o">=</span> <span class="nb">set</span><span class="p">(</span><span class="n">y</span><span class="p">)</span>
        <span class="n">n_docs</span> <span class="o">=</span> <span class="nb">len</span><span class="p">(</span><span class="n">y</span><span class="p">)</span>

        <span class="k">for</span> <span class="n">c</span> <span class="ow">in</span> <span class="n">classes</span><span class="p">:</span>
            <span class="c1"># Prior: P(class = c)
</span>            <span class="n">class_docs</span> <span class="o">=</span> <span class="p">[</span><span class="n">X</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">n_docs</span><span class="p">)</span> <span class="k">if</span> <span class="n">y</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="o">==</span> <span class="n">c</span><span class="p">]</span>
            <span class="bp">self</span><span class="p">.</span><span class="n">class_priors</span><span class="p">[</span><span class="n">c</span><span class="p">]</span> <span class="o">=</span> <span class="nb">len</span><span class="p">(</span><span class="n">class_docs</span><span class="p">)</span> <span class="o">/</span> <span class="n">n_docs</span>

            <span class="c1"># Count all words in this class
</span>            <span class="n">word_counts</span> <span class="o">=</span> <span class="p">{}</span>
            <span class="n">total_words</span> <span class="o">=</span> <span class="mi">0</span>
            <span class="k">for</span> <span class="n">doc</span> <span class="ow">in</span> <span class="n">class_docs</span><span class="p">:</span>
                <span class="k">for</span> <span class="n">word</span> <span class="ow">in</span> <span class="n">doc</span><span class="p">:</span>
                    <span class="n">word_counts</span><span class="p">[</span><span class="n">word</span><span class="p">]</span> <span class="o">=</span> <span class="n">word_counts</span><span class="p">.</span><span class="n">get</span><span class="p">(</span><span class="n">word</span><span class="p">,</span> <span class="mi">0</span><span class="p">)</span> <span class="o">+</span> <span class="mi">1</span>
                    <span class="n">total_words</span> <span class="o">+=</span> <span class="mi">1</span>

            <span class="c1"># Compute word probabilities with Laplace smoothing
</span>            <span class="c1"># P(word | class) = (count + alpha) / (total + alpha * vocab_size)
</span>            <span class="bp">self</span><span class="p">.</span><span class="n">word_probs</span><span class="p">[</span><span class="n">c</span><span class="p">]</span> <span class="o">=</span> <span class="p">{}</span>
            <span class="n">vocab_size</span> <span class="o">=</span> <span class="nb">len</span><span class="p">(</span><span class="bp">self</span><span class="p">.</span><span class="n">vocab</span><span class="p">)</span>
            <span class="k">for</span> <span class="n">word</span> <span class="ow">in</span> <span class="bp">self</span><span class="p">.</span><span class="n">vocab</span><span class="p">:</span>
                <span class="n">count</span> <span class="o">=</span> <span class="n">word_counts</span><span class="p">.</span><span class="n">get</span><span class="p">(</span><span class="n">word</span><span class="p">,</span> <span class="mi">0</span><span class="p">)</span>
                <span class="bp">self</span><span class="p">.</span><span class="n">word_probs</span><span class="p">[</span><span class="n">c</span><span class="p">][</span><span class="n">word</span><span class="p">]</span> <span class="o">=</span> <span class="p">(</span><span class="n">count</span> <span class="o">+</span> <span class="bp">self</span><span class="p">.</span><span class="n">alpha</span><span class="p">)</span> <span class="o">/</span> <span class="p">(</span><span class="n">total_words</span> <span class="o">+</span> <span class="bp">self</span><span class="p">.</span><span class="n">alpha</span> <span class="o">*</span> <span class="n">vocab_size</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">predict_proba</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">doc</span><span class="p">):</span>
        <span class="s">"""
        Compute posterior probabilities for a document.

        Parameters:
        - doc: list of words

        Returns:
        - dict mapping class to probability
        """</span>
        <span class="n">log_probs</span> <span class="o">=</span> <span class="p">{}</span>

        <span class="k">for</span> <span class="n">c</span> <span class="ow">in</span> <span class="bp">self</span><span class="p">.</span><span class="n">class_priors</span><span class="p">:</span>
            <span class="c1"># Start with log prior
</span>            <span class="n">log_prob</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">log</span><span class="p">(</span><span class="bp">self</span><span class="p">.</span><span class="n">class_priors</span><span class="p">[</span><span class="n">c</span><span class="p">])</span>

            <span class="c1"># Add log likelihood of each word
</span>            <span class="k">for</span> <span class="n">word</span> <span class="ow">in</span> <span class="n">doc</span><span class="p">:</span>
                <span class="k">if</span> <span class="n">word</span> <span class="ow">in</span> <span class="bp">self</span><span class="p">.</span><span class="n">word_probs</span><span class="p">[</span><span class="n">c</span><span class="p">]:</span>
                    <span class="n">log_prob</span> <span class="o">+=</span> <span class="n">np</span><span class="p">.</span><span class="n">log</span><span class="p">(</span><span class="bp">self</span><span class="p">.</span><span class="n">word_probs</span><span class="p">[</span><span class="n">c</span><span class="p">][</span><span class="n">word</span><span class="p">])</span>
                <span class="c1"># Words not in vocabulary are ignored
</span>
            <span class="n">log_probs</span><span class="p">[</span><span class="n">c</span><span class="p">]</span> <span class="o">=</span> <span class="n">log_prob</span>

        <span class="c1"># Convert to probabilities using log-sum-exp trick
</span>        <span class="n">max_log</span> <span class="o">=</span> <span class="nb">max</span><span class="p">(</span><span class="n">log_probs</span><span class="p">.</span><span class="n">values</span><span class="p">())</span>
        <span class="n">probs</span> <span class="o">=</span> <span class="p">{</span><span class="n">c</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">exp</span><span class="p">(</span><span class="n">log_probs</span><span class="p">[</span><span class="n">c</span><span class="p">]</span> <span class="o">-</span> <span class="n">max_log</span><span class="p">)</span> <span class="k">for</span> <span class="n">c</span> <span class="ow">in</span> <span class="n">log_probs</span><span class="p">}</span>
        <span class="n">total</span> <span class="o">=</span> <span class="nb">sum</span><span class="p">(</span><span class="n">probs</span><span class="p">.</span><span class="n">values</span><span class="p">())</span>
        <span class="k">return</span> <span class="p">{</span><span class="n">c</span><span class="p">:</span> <span class="n">p</span> <span class="o">/</span> <span class="n">total</span> <span class="k">for</span> <span class="n">c</span><span class="p">,</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">probs</span><span class="p">.</span><span class="n">items</span><span class="p">()}</span>

    <span class="k">def</span> <span class="nf">predict</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">doc</span><span class="p">):</span>
        <span class="s">"""Predict the class for a document."""</span>
        <span class="n">probs</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">predict_proba</span><span class="p">(</span><span class="n">doc</span><span class="p">)</span>
        <span class="k">return</span> <span class="nb">max</span><span class="p">(</span><span class="n">probs</span><span class="p">,</span> <span class="n">key</span><span class="o">=</span><span class="n">probs</span><span class="p">.</span><span class="n">get</span><span class="p">)</span>
</code></pre></div></div>

<p><strong>What happens if you change alpha?</strong> This is Laplace smoothing. Setting $\alpha = 1$ (add-one smoothing) prevents zero probabilities when a word appears in test data but not in training. Larger $\alpha$ makes the model more uniform (less confident). With $\alpha = 0$, any unseen word gives zero probability for that class.</p>

<hr />

<h2 id="part-3-comparing-classifiers">Part 3: Comparing Classifiers</h2>

<h3 id="k-nearest-neighbors">K-Nearest Neighbors</h3>

<p>We’ve covered Logistic Regression and Naive Bayes. Let’s briefly add KNN for comparison.</p>

<p><strong>Plain English:</strong> To classify a new point, find the $k$ training points closest to it and take a majority vote.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="nn">sklearn.neighbors</span> <span class="kn">import</span> <span class="n">KNeighborsClassifier</span>

<span class="n">knn</span> <span class="o">=</span> <span class="n">KNeighborsClassifier</span><span class="p">(</span><span class="n">n_neighbors</span><span class="o">=</span><span class="mi">5</span><span class="p">)</span>
<span class="n">knn</span><span class="p">.</span><span class="n">fit</span><span class="p">(</span><span class="n">X_train</span><span class="p">,</span> <span class="n">y_train</span><span class="p">)</span>
<span class="n">y_pred</span> <span class="o">=</span> <span class="n">knn</span><span class="p">.</span><span class="n">predict</span><span class="p">(</span><span class="n">X_test</span><span class="p">)</span>
</code></pre></div></div>

<table>
  <thead>
    <tr>
      <th>Aspect</th>
      <th>Logistic Regression</th>
      <th>Naive Bayes</th>
      <th>KNN</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Model type</td>
      <td>Discriminative</td>
      <td>Generative</td>
      <td>Non-parametric</td>
    </tr>
    <tr>
      <td>Decision boundary</td>
      <td>Linear</td>
      <td>Linear (for Gaussian NB)</td>
      <td>Complex, local</td>
    </tr>
    <tr>
      <td>Training time</td>
      <td>Moderate (iterative)</td>
      <td>Fast (closed-form)</td>
      <td>None (lazy learning)</td>
    </tr>
    <tr>
      <td>Prediction time</td>
      <td>Fast</td>
      <td>Fast</td>
      <td>Slow (compares to all training data)</td>
    </tr>
    <tr>
      <td>Handles irrelevant features</td>
      <td>Yes (regularization)</td>
      <td>Poorly</td>
      <td>Poorly</td>
    </tr>
    <tr>
      <td>Probabilistic output</td>
      <td>Yes</td>
      <td>Yes</td>
      <td>Limited</td>
    </tr>
  </tbody>
</table>

<h3 id="application-marriage-dataset">Application: Marriage Dataset</h3>

<p>Let’s compare all three classifiers on a real dataset with 54 features predicting a binary outcome.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">import</span> <span class="nn">pandas</span> <span class="k">as</span> <span class="n">pd</span>
<span class="kn">from</span> <span class="nn">sklearn.model_selection</span> <span class="kn">import</span> <span class="n">train_test_split</span>
<span class="kn">from</span> <span class="nn">sklearn.linear_model</span> <span class="kn">import</span> <span class="n">LogisticRegression</span>
<span class="kn">from</span> <span class="nn">sklearn.neighbors</span> <span class="kn">import</span> <span class="n">KNeighborsClassifier</span>
<span class="kn">from</span> <span class="nn">sklearn.naive_bayes</span> <span class="kn">import</span> <span class="n">GaussianNB</span>
<span class="kn">from</span> <span class="nn">sklearn.metrics</span> <span class="kn">import</span> <span class="n">accuracy_score</span>

<span class="c1"># Load data
</span><span class="n">data</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">read_csv</span><span class="p">(</span><span class="s">'marriage.csv'</span><span class="p">)</span>
<span class="n">X</span> <span class="o">=</span> <span class="n">data</span><span class="p">.</span><span class="n">drop</span><span class="p">(</span><span class="s">'Label'</span><span class="p">,</span> <span class="n">axis</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
<span class="n">y</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span><span class="s">'Label'</span><span class="p">]</span>

<span class="c1"># Split data
</span><span class="n">X_train</span><span class="p">,</span> <span class="n">X_test</span><span class="p">,</span> <span class="n">y_train</span><span class="p">,</span> <span class="n">y_test</span> <span class="o">=</span> <span class="n">train_test_split</span><span class="p">(</span>
    <span class="n">X</span><span class="p">,</span> <span class="n">y</span><span class="p">,</span> <span class="n">test_size</span><span class="o">=</span><span class="mf">0.2</span><span class="p">,</span> <span class="n">random_state</span><span class="o">=</span><span class="mi">1</span>
<span class="p">)</span>

<span class="c1"># Train classifiers
</span><span class="n">log_reg</span> <span class="o">=</span> <span class="n">LogisticRegression</span><span class="p">(</span><span class="n">max_iter</span><span class="o">=</span><span class="mi">1000</span><span class="p">)</span>
<span class="n">knn</span> <span class="o">=</span> <span class="n">KNeighborsClassifier</span><span class="p">(</span><span class="n">n_neighbors</span><span class="o">=</span><span class="mi">5</span><span class="p">)</span>
<span class="n">nb</span> <span class="o">=</span> <span class="n">GaussianNB</span><span class="p">()</span>

<span class="n">log_reg</span><span class="p">.</span><span class="n">fit</span><span class="p">(</span><span class="n">X_train</span><span class="p">,</span> <span class="n">y_train</span><span class="p">)</span>
<span class="n">knn</span><span class="p">.</span><span class="n">fit</span><span class="p">(</span><span class="n">X_train</span><span class="p">,</span> <span class="n">y_train</span><span class="p">)</span>
<span class="n">nb</span><span class="p">.</span><span class="n">fit</span><span class="p">(</span><span class="n">X_train</span><span class="p">,</span> <span class="n">y_train</span><span class="p">)</span>

<span class="c1"># Evaluate
</span><span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">"Logistic Regression: </span><span class="si">{</span><span class="n">accuracy_score</span><span class="p">(</span><span class="n">y_test</span><span class="p">,</span> <span class="n">log_reg</span><span class="p">.</span><span class="n">predict</span><span class="p">(</span><span class="n">X_test</span><span class="p">))</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">f</span><span class="si">}</span><span class="s">"</span><span class="p">)</span>
<span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">"KNN: </span><span class="si">{</span><span class="n">accuracy_score</span><span class="p">(</span><span class="n">y_test</span><span class="p">,</span> <span class="n">knn</span><span class="p">.</span><span class="n">predict</span><span class="p">(</span><span class="n">X_test</span><span class="p">))</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">f</span><span class="si">}</span><span class="s">"</span><span class="p">)</span>
<span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">"Naive Bayes: </span><span class="si">{</span><span class="n">accuracy_score</span><span class="p">(</span><span class="n">y_test</span><span class="p">,</span> <span class="n">nb</span><span class="p">.</span><span class="n">predict</span><span class="p">(</span><span class="n">X_test</span><span class="p">))</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">f</span><span class="si">}</span><span class="s">"</span><span class="p">)</span>
</code></pre></div></div>

<p><strong>Results:</strong></p>

<table>
  <thead>
    <tr>
      <th>Classifier</th>
      <th>Accuracy</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Logistic Regression</td>
      <td>94.1%</td>
    </tr>
    <tr>
      <td>KNN (k=5)</td>
      <td>94.1%</td>
    </tr>
    <tr>
      <td>Naive Bayes</td>
      <td>94.1%</td>
    </tr>
  </tbody>
</table>

<p>All three classifiers achieve the same accuracy on this dataset. This suggests the classes are well-separated and the problem is relatively easy. Let’s visualize why.</p>

<h3 id="visualizing-decision-boundaries-with-pca">Visualizing Decision Boundaries with PCA</h3>

<p>To visualize the decision boundaries, we reduce the 54 features to 2 using PCA:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="nn">sklearn.decomposition</span> <span class="kn">import</span> <span class="n">PCA</span>
<span class="kn">from</span> <span class="nn">sklearn.inspection</span> <span class="kn">import</span> <span class="n">DecisionBoundaryDisplay</span>
<span class="kn">import</span> <span class="nn">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>

<span class="c1"># Reduce to 2D for visualization
</span><span class="n">pca</span> <span class="o">=</span> <span class="n">PCA</span><span class="p">(</span><span class="n">n_components</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
<span class="n">X_pca</span> <span class="o">=</span> <span class="n">pca</span><span class="p">.</span><span class="n">fit_transform</span><span class="p">(</span><span class="n">X</span><span class="p">)</span>

<span class="c1"># Re-split with PCA features
</span><span class="n">X_train_pca</span><span class="p">,</span> <span class="n">X_test_pca</span><span class="p">,</span> <span class="n">y_train</span><span class="p">,</span> <span class="n">y_test</span> <span class="o">=</span> <span class="n">train_test_split</span><span class="p">(</span>
    <span class="n">X_pca</span><span class="p">,</span> <span class="n">y</span><span class="p">,</span> <span class="n">test_size</span><span class="o">=</span><span class="mf">0.2</span><span class="p">,</span> <span class="n">random_state</span><span class="o">=</span><span class="mi">1</span>
<span class="p">)</span>

<span class="c1"># Re-train on 2D features
</span><span class="n">log_reg</span><span class="p">.</span><span class="n">fit</span><span class="p">(</span><span class="n">X_train_pca</span><span class="p">,</span> <span class="n">y_train</span><span class="p">)</span>
<span class="n">knn</span><span class="p">.</span><span class="n">fit</span><span class="p">(</span><span class="n">X_train_pca</span><span class="p">,</span> <span class="n">y_train</span><span class="p">)</span>
<span class="n">nb</span><span class="p">.</span><span class="n">fit</span><span class="p">(</span><span class="n">X_train_pca</span><span class="p">,</span> <span class="n">y_train</span><span class="p">)</span>

<span class="c1"># Plot decision boundaries
</span><span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="n">subplots</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">15</span><span class="p">,</span> <span class="mi">4</span><span class="p">))</span>
<span class="n">models</span> <span class="o">=</span> <span class="p">[(</span><span class="s">'Logistic Regression'</span><span class="p">,</span> <span class="n">log_reg</span><span class="p">),</span> <span class="p">(</span><span class="s">'KNN'</span><span class="p">,</span> <span class="n">knn</span><span class="p">),</span> <span class="p">(</span><span class="s">'Naive Bayes'</span><span class="p">,</span> <span class="n">nb</span><span class="p">)]</span>

<span class="k">for</span> <span class="n">ax</span><span class="p">,</span> <span class="p">(</span><span class="n">name</span><span class="p">,</span> <span class="n">model</span><span class="p">)</span> <span class="ow">in</span> <span class="nb">zip</span><span class="p">(</span><span class="n">axes</span><span class="p">,</span> <span class="n">models</span><span class="p">):</span>
    <span class="n">DecisionBoundaryDisplay</span><span class="p">.</span><span class="n">from_estimator</span><span class="p">(</span>
        <span class="n">model</span><span class="p">,</span> <span class="n">X_pca</span><span class="p">,</span> <span class="n">response_method</span><span class="o">=</span><span class="s">"predict"</span><span class="p">,</span>
        <span class="n">alpha</span><span class="o">=</span><span class="mf">0.5</span><span class="p">,</span> <span class="n">ax</span><span class="o">=</span><span class="n">ax</span>
    <span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="n">scatter</span><span class="p">(</span><span class="n">X_pca</span><span class="p">[:,</span> <span class="mi">0</span><span class="p">],</span> <span class="n">X_pca</span><span class="p">[:,</span> <span class="mi">1</span><span class="p">],</span> <span class="n">c</span><span class="o">=</span><span class="n">y</span><span class="p">,</span> <span class="n">edgecolor</span><span class="o">=</span><span class="s">"k"</span><span class="p">,</span> <span class="n">cmap</span><span class="o">=</span><span class="n">plt</span><span class="p">.</span><span class="n">cm</span><span class="p">.</span><span class="n">Paired</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="n">set_title</span><span class="p">(</span><span class="n">name</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="n">set_xlabel</span><span class="p">(</span><span class="s">"PC1"</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="n">set_ylabel</span><span class="p">(</span><span class="s">"PC2"</span><span class="p">)</span>

<span class="n">plt</span><span class="p">.</span><span class="n">tight_layout</span><span class="p">()</span>
<span class="n">plt</span><span class="p">.</span><span class="n">show</span><span class="p">()</span>
</code></pre></div></div>

<p><img src="/assets/images/posts/classification/decision-boundaries.png" alt="Decision Boundaries" />
<em>Decision boundaries for three classifiers on PCA-reduced data. Left: Logistic regression creates a linear boundary. Middle: KNN creates a more complex boundary that follows the local structure. Right: Naive Bayes (Gaussian) also creates a linear boundary.</em></p>

<p><strong>Observations:</strong></p>

<ol>
  <li>
    <p><strong>The classes are well-separated</strong>: Class 0 (blue) clusters on the left, Class 1 (orange) on the right. This explains why all classifiers achieve similar accuracy.</p>
  </li>
  <li>
    <p><strong>Logistic Regression</strong>: Creates a clean linear boundary perpendicular to the direction of maximum separation.</p>
  </li>
  <li>
    <p><strong>KNN</strong>: The boundary is more irregular, following the local structure of the data. It’s more flexible but can be noisier.</p>
  </li>
  <li>
    <p><strong>Naive Bayes (Gaussian)</strong>: Also creates a linear boundary because Gaussian NB assumes each class is normally distributed.</p>
  </li>
</ol>

<h3 id="when-to-use-each-classifier">When to Use Each Classifier</h3>

<p><strong>Logistic Regression:</strong></p>
<ul>
  <li>When you want interpretable coefficients</li>
  <li>When classes are roughly linearly separable</li>
  <li>When you need probability estimates</li>
  <li>As a baseline model</li>
</ul>

<p><strong>Naive Bayes:</strong></p>
<ul>
  <li>For text classification (multinomial NB)</li>
  <li>When you have limited training data</li>
  <li>When features are approximately independent</li>
  <li>For fast training and prediction</li>
</ul>

<p><strong>KNN:</strong></p>
<ul>
  <li>When decision boundaries are complex</li>
  <li>When you have lots of data and can afford slow prediction</li>
  <li>When you want a non-parametric approach</li>
  <li>As a quick baseline without training</li>
</ul>

<hr />

<h2 id="summary">Summary</h2>

<h3 id="logistic-regression">Logistic Regression</h3>
<ul>
  <li>Models $P(y=1 \mid x)$ directly using sigmoid function</li>
  <li>Learns linear decision boundary</li>
  <li>Uses gradient descent to maximize log-likelihood</li>
  <li>Log-likelihood is concave, guaranteeing global optimum</li>
</ul>

<h3 id="naive-bayes">Naive Bayes</h3>
<ul>
  <li>Applies Bayes’ theorem with conditional independence assumption</li>
  <li>Estimates class priors and feature likelihoods from data</li>
  <li>Fast to train (closed-form solutions)</li>
  <li>Works well for text classification</li>
</ul>

<h3 id="k-nearest-neighbors-1">K-Nearest Neighbors</h3>
<ul>
  <li>No training phase (lazy learning)</li>
  <li>Classifies based on majority vote of neighbors</li>
  <li>Can capture complex decision boundaries</li>
  <li>Slow at prediction time for large datasets</li>
</ul>

<h3 id="general-principles">General Principles</h3>

<ol>
  <li>
    <p><strong>Start simple.</strong> Logistic regression is often a strong baseline.</p>
  </li>
  <li>
    <p><strong>Consider your data size.</strong> Naive Bayes works well with limited data. KNN needs enough neighbors to be meaningful.</p>
  </li>
  <li>
    <p><strong>Think about interpretability.</strong> Logistic regression coefficients have clear meaning. KNN is a black box.</p>
  </li>
  <li>
    <p><strong>Visualize when possible.</strong> PCA can reveal whether classes are separable and which classifier’s assumptions fit best.</p>
  </li>
  <li>
    <p><strong>When classifiers agree, the problem is easy.</strong> When they disagree, investigate why.</p>
  </li>
</ol>

<hr />

<h2 id="references">References</h2>

<p><strong>Logistic Regression</strong></p>
<ul>
  <li>Bishop, C. M. (2006). <em>Pattern Recognition and Machine Learning</em>, Chapter 4. Springer.</li>
  <li>Hastie, T., Tibshirani, R., &amp; Friedman, J. (2009). <em>The Elements of Statistical Learning</em>, Chapter 4. Springer.</li>
</ul>

<p><strong>Naive Bayes</strong></p>
<ul>
  <li>Mitchell, T. (1997). <em>Machine Learning</em>, Chapter 6. McGraw Hill.</li>
  <li>Manning, C. D., Raghavan, P., &amp; Schütze, H. (2008). <a href="https://nlp.stanford.edu/IR-book/"><em>Introduction to Information Retrieval</em></a>, Chapter 13.</li>
</ul>

<p><strong>Optimization</strong></p>
<ul>
  <li>Boyd, S., &amp; Vandenberghe, L. (2004). <a href="https://web.stanford.edu/~boyd/cvxbook/"><em>Convex Optimization</em></a>. Cambridge University Press.</li>
</ul>

<hr />

<h2 id="appendix-complete-implementations">Appendix: Complete Implementations</h2>

<h3 id="logistic-regression-1">Logistic Regression</h3>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">numpy</span> <span class="k">as</span> <span class="n">np</span>

<span class="k">def</span> <span class="nf">sigmoid</span><span class="p">(</span><span class="n">z</span><span class="p">):</span>
    <span class="s">"""Compute sigmoid function, handling overflow."""</span>
    <span class="k">return</span> <span class="n">np</span><span class="p">.</span><span class="n">where</span><span class="p">(</span><span class="n">z</span> <span class="o">&gt;=</span> <span class="mi">0</span><span class="p">,</span>
                    <span class="mi">1</span> <span class="o">/</span> <span class="p">(</span><span class="mi">1</span> <span class="o">+</span> <span class="n">np</span><span class="p">.</span><span class="n">exp</span><span class="p">(</span><span class="o">-</span><span class="n">z</span><span class="p">)),</span>
                    <span class="n">np</span><span class="p">.</span><span class="n">exp</span><span class="p">(</span><span class="n">z</span><span class="p">)</span> <span class="o">/</span> <span class="p">(</span><span class="mi">1</span> <span class="o">+</span> <span class="n">np</span><span class="p">.</span><span class="n">exp</span><span class="p">(</span><span class="n">z</span><span class="p">)))</span>

<span class="k">def</span> <span class="nf">logistic_regression_fit</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">y</span><span class="p">,</span> <span class="n">learning_rate</span><span class="o">=</span><span class="mf">0.01</span><span class="p">,</span> <span class="n">max_iters</span><span class="o">=</span><span class="mi">10000</span><span class="p">,</span> <span class="n">tol</span><span class="o">=</span><span class="mf">1e-6</span><span class="p">):</span>
    <span class="s">"""
    Fit logistic regression using gradient ascent.

    Parameters:
    - X: feature matrix (m, d), should include bias column if desired
    - y: labels (m,), values in {0, 1}
    - learning_rate: step size for gradient ascent
    - max_iters: maximum iterations
    - tol: convergence tolerance

    Returns:
    - theta: learned parameters (d,)
    - history: list of log-likelihood values
    """</span>
    <span class="n">m</span><span class="p">,</span> <span class="n">d</span> <span class="o">=</span> <span class="n">X</span><span class="p">.</span><span class="n">shape</span>
    <span class="n">theta</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">zeros</span><span class="p">(</span><span class="n">d</span><span class="p">)</span>
    <span class="n">history</span> <span class="o">=</span> <span class="p">[]</span>

    <span class="k">for</span> <span class="n">iteration</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">max_iters</span><span class="p">):</span>
        <span class="c1"># Forward pass
</span>        <span class="n">z</span> <span class="o">=</span> <span class="n">X</span> <span class="o">@</span> <span class="n">theta</span>
        <span class="n">predictions</span> <span class="o">=</span> <span class="n">sigmoid</span><span class="p">(</span><span class="n">z</span><span class="p">)</span>

        <span class="c1"># Log-likelihood
</span>        <span class="n">ll</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nb">sum</span><span class="p">(</span><span class="n">y</span> <span class="o">*</span> <span class="n">np</span><span class="p">.</span><span class="n">log</span><span class="p">(</span><span class="n">predictions</span> <span class="o">+</span> <span class="mf">1e-10</span><span class="p">)</span> <span class="o">+</span>
                    <span class="p">(</span><span class="mi">1</span> <span class="o">-</span> <span class="n">y</span><span class="p">)</span> <span class="o">*</span> <span class="n">np</span><span class="p">.</span><span class="n">log</span><span class="p">(</span><span class="mi">1</span> <span class="o">-</span> <span class="n">predictions</span> <span class="o">+</span> <span class="mf">1e-10</span><span class="p">))</span>
        <span class="n">history</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">ll</span><span class="p">)</span>

        <span class="c1"># Gradient
</span>        <span class="n">gradient</span> <span class="o">=</span> <span class="n">X</span><span class="p">.</span><span class="n">T</span> <span class="o">@</span> <span class="p">(</span><span class="n">y</span> <span class="o">-</span> <span class="n">predictions</span><span class="p">)</span>

        <span class="c1"># Update
</span>        <span class="n">theta_new</span> <span class="o">=</span> <span class="n">theta</span> <span class="o">+</span> <span class="n">learning_rate</span> <span class="o">*</span> <span class="n">gradient</span>

        <span class="c1"># Check convergence
</span>        <span class="k">if</span> <span class="n">np</span><span class="p">.</span><span class="n">linalg</span><span class="p">.</span><span class="n">norm</span><span class="p">(</span><span class="n">theta_new</span> <span class="o">-</span> <span class="n">theta</span><span class="p">)</span> <span class="o">&lt;</span> <span class="n">tol</span><span class="p">:</span>
            <span class="k">break</span>

        <span class="n">theta</span> <span class="o">=</span> <span class="n">theta_new</span>

    <span class="k">return</span> <span class="n">theta</span><span class="p">,</span> <span class="n">history</span>

<span class="k">def</span> <span class="nf">logistic_regression_predict_proba</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">theta</span><span class="p">):</span>
    <span class="s">"""Predict probabilities."""</span>
    <span class="k">return</span> <span class="n">sigmoid</span><span class="p">(</span><span class="n">X</span> <span class="o">@</span> <span class="n">theta</span><span class="p">)</span>

<span class="k">def</span> <span class="nf">logistic_regression_predict</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">theta</span><span class="p">,</span> <span class="n">threshold</span><span class="o">=</span><span class="mf">0.5</span><span class="p">):</span>
    <span class="s">"""Predict class labels."""</span>
    <span class="k">return</span> <span class="p">(</span><span class="n">logistic_regression_predict_proba</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">theta</span><span class="p">)</span> <span class="o">&gt;=</span> <span class="n">threshold</span><span class="p">).</span><span class="n">astype</span><span class="p">(</span><span class="nb">int</span><span class="p">)</span>
</code></pre></div></div>

<h3 id="naive-bayes-1">Naive Bayes</h3>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">from</span> <span class="nn">collections</span> <span class="kn">import</span> <span class="n">defaultdict</span>

<span class="k">class</span> <span class="nc">MultinomialNaiveBayes</span><span class="p">:</span>
    <span class="s">"""Multinomial Naive Bayes for text classification."""</span>

    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">1.0</span><span class="p">):</span>
        <span class="s">"""
        Parameters:
        - alpha: Laplace smoothing parameter
        """</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">alpha</span> <span class="o">=</span> <span class="n">alpha</span>

    <span class="k">def</span> <span class="nf">fit</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">X</span><span class="p">,</span> <span class="n">y</span><span class="p">):</span>
        <span class="s">"""
        Fit the model.

        Parameters:
        - X: list of documents (each is a list of words)
        - y: list of labels
        """</span>
        <span class="c1"># Build vocabulary
</span>        <span class="bp">self</span><span class="p">.</span><span class="n">vocab</span> <span class="o">=</span> <span class="nb">set</span><span class="p">()</span>
        <span class="k">for</span> <span class="n">doc</span> <span class="ow">in</span> <span class="n">X</span><span class="p">:</span>
            <span class="bp">self</span><span class="p">.</span><span class="n">vocab</span><span class="p">.</span><span class="n">update</span><span class="p">(</span><span class="n">doc</span><span class="p">)</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">vocab</span> <span class="o">=</span> <span class="nb">sorted</span><span class="p">(</span><span class="bp">self</span><span class="p">.</span><span class="n">vocab</span><span class="p">)</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">word_to_idx</span> <span class="o">=</span> <span class="p">{</span><span class="n">w</span><span class="p">:</span> <span class="n">i</span> <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">w</span> <span class="ow">in</span> <span class="nb">enumerate</span><span class="p">(</span><span class="bp">self</span><span class="p">.</span><span class="n">vocab</span><span class="p">)}</span>

        <span class="c1"># Get unique classes
</span>        <span class="bp">self</span><span class="p">.</span><span class="n">classes</span> <span class="o">=</span> <span class="nb">sorted</span><span class="p">(</span><span class="nb">set</span><span class="p">(</span><span class="n">y</span><span class="p">))</span>

        <span class="c1"># Compute priors and likelihoods
</span>        <span class="bp">self</span><span class="p">.</span><span class="n">log_priors</span> <span class="o">=</span> <span class="p">{}</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">log_likelihoods</span> <span class="o">=</span> <span class="p">{}</span>

        <span class="n">n_docs</span> <span class="o">=</span> <span class="nb">len</span><span class="p">(</span><span class="n">y</span><span class="p">)</span>
        <span class="n">n_vocab</span> <span class="o">=</span> <span class="nb">len</span><span class="p">(</span><span class="bp">self</span><span class="p">.</span><span class="n">vocab</span><span class="p">)</span>

        <span class="k">for</span> <span class="n">c</span> <span class="ow">in</span> <span class="bp">self</span><span class="p">.</span><span class="n">classes</span><span class="p">:</span>
            <span class="c1"># Documents in class c
</span>            <span class="n">docs_c</span> <span class="o">=</span> <span class="p">[</span><span class="n">X</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">n_docs</span><span class="p">)</span> <span class="k">if</span> <span class="n">y</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="o">==</span> <span class="n">c</span><span class="p">]</span>

            <span class="c1"># Log prior
</span>            <span class="bp">self</span><span class="p">.</span><span class="n">log_priors</span><span class="p">[</span><span class="n">c</span><span class="p">]</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">log</span><span class="p">(</span><span class="nb">len</span><span class="p">(</span><span class="n">docs_c</span><span class="p">)</span> <span class="o">/</span> <span class="n">n_docs</span><span class="p">)</span>

            <span class="c1"># Word counts
</span>            <span class="n">word_counts</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">zeros</span><span class="p">(</span><span class="n">n_vocab</span><span class="p">)</span>
            <span class="k">for</span> <span class="n">doc</span> <span class="ow">in</span> <span class="n">docs_c</span><span class="p">:</span>
                <span class="k">for</span> <span class="n">word</span> <span class="ow">in</span> <span class="n">doc</span><span class="p">:</span>
                    <span class="k">if</span> <span class="n">word</span> <span class="ow">in</span> <span class="bp">self</span><span class="p">.</span><span class="n">word_to_idx</span><span class="p">:</span>
                        <span class="n">word_counts</span><span class="p">[</span><span class="bp">self</span><span class="p">.</span><span class="n">word_to_idx</span><span class="p">[</span><span class="n">word</span><span class="p">]]</span> <span class="o">+=</span> <span class="mi">1</span>

            <span class="c1"># Log likelihoods with smoothing
</span>            <span class="n">total</span> <span class="o">=</span> <span class="n">word_counts</span><span class="p">.</span><span class="nb">sum</span><span class="p">()</span>
            <span class="bp">self</span><span class="p">.</span><span class="n">log_likelihoods</span><span class="p">[</span><span class="n">c</span><span class="p">]</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">log</span><span class="p">(</span>
                <span class="p">(</span><span class="n">word_counts</span> <span class="o">+</span> <span class="bp">self</span><span class="p">.</span><span class="n">alpha</span><span class="p">)</span> <span class="o">/</span> <span class="p">(</span><span class="n">total</span> <span class="o">+</span> <span class="bp">self</span><span class="p">.</span><span class="n">alpha</span> <span class="o">*</span> <span class="n">n_vocab</span><span class="p">)</span>
            <span class="p">)</span>

    <span class="k">def</span> <span class="nf">predict_log_proba</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">doc</span><span class="p">):</span>
        <span class="s">"""Compute log probabilities for a document."""</span>
        <span class="n">log_probs</span> <span class="o">=</span> <span class="p">{}</span>
        <span class="k">for</span> <span class="n">c</span> <span class="ow">in</span> <span class="bp">self</span><span class="p">.</span><span class="n">classes</span><span class="p">:</span>
            <span class="n">log_prob</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">log_priors</span><span class="p">[</span><span class="n">c</span><span class="p">]</span>
            <span class="k">for</span> <span class="n">word</span> <span class="ow">in</span> <span class="n">doc</span><span class="p">:</span>
                <span class="k">if</span> <span class="n">word</span> <span class="ow">in</span> <span class="bp">self</span><span class="p">.</span><span class="n">word_to_idx</span><span class="p">:</span>
                    <span class="n">log_prob</span> <span class="o">+=</span> <span class="bp">self</span><span class="p">.</span><span class="n">log_likelihoods</span><span class="p">[</span><span class="n">c</span><span class="p">][</span><span class="bp">self</span><span class="p">.</span><span class="n">word_to_idx</span><span class="p">[</span><span class="n">word</span><span class="p">]]</span>
            <span class="n">log_probs</span><span class="p">[</span><span class="n">c</span><span class="p">]</span> <span class="o">=</span> <span class="n">log_prob</span>
        <span class="k">return</span> <span class="n">log_probs</span>

    <span class="k">def</span> <span class="nf">predict</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">doc</span><span class="p">):</span>
        <span class="s">"""Predict class for a document."""</span>
        <span class="n">log_probs</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">predict_log_proba</span><span class="p">(</span><span class="n">doc</span><span class="p">)</span>
        <span class="k">return</span> <span class="nb">max</span><span class="p">(</span><span class="n">log_probs</span><span class="p">,</span> <span class="n">key</span><span class="o">=</span><span class="n">log_probs</span><span class="p">.</span><span class="n">get</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">predict_proba</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">doc</span><span class="p">):</span>
        <span class="s">"""Predict class probabilities for a document."""</span>
        <span class="n">log_probs</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">predict_log_proba</span><span class="p">(</span><span class="n">doc</span><span class="p">)</span>
        <span class="c1"># Log-sum-exp trick for numerical stability
</span>        <span class="n">max_log</span> <span class="o">=</span> <span class="nb">max</span><span class="p">(</span><span class="n">log_probs</span><span class="p">.</span><span class="n">values</span><span class="p">())</span>
        <span class="n">probs</span> <span class="o">=</span> <span class="p">{</span><span class="n">c</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">exp</span><span class="p">(</span><span class="n">log_probs</span><span class="p">[</span><span class="n">c</span><span class="p">]</span> <span class="o">-</span> <span class="n">max_log</span><span class="p">)</span> <span class="k">for</span> <span class="n">c</span> <span class="ow">in</span> <span class="n">log_probs</span><span class="p">}</span>
        <span class="n">total</span> <span class="o">=</span> <span class="nb">sum</span><span class="p">(</span><span class="n">probs</span><span class="p">.</span><span class="n">values</span><span class="p">())</span>
        <span class="k">return</span> <span class="p">{</span><span class="n">c</span><span class="p">:</span> <span class="n">p</span> <span class="o">/</span> <span class="n">total</span> <span class="k">for</span> <span class="n">c</span><span class="p">,</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">probs</span><span class="p">.</span><span class="n">items</span><span class="p">()}</span>
</code></pre></div></div>

<h3 id="comparison-script">Comparison Script</h3>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">import</span> <span class="nn">pandas</span> <span class="k">as</span> <span class="n">pd</span>
<span class="kn">from</span> <span class="nn">sklearn.model_selection</span> <span class="kn">import</span> <span class="n">train_test_split</span>
<span class="kn">from</span> <span class="nn">sklearn.linear_model</span> <span class="kn">import</span> <span class="n">LogisticRegression</span>
<span class="kn">from</span> <span class="nn">sklearn.neighbors</span> <span class="kn">import</span> <span class="n">KNeighborsClassifier</span>
<span class="kn">from</span> <span class="nn">sklearn.naive_bayes</span> <span class="kn">import</span> <span class="n">GaussianNB</span>
<span class="kn">from</span> <span class="nn">sklearn.metrics</span> <span class="kn">import</span> <span class="n">accuracy_score</span><span class="p">,</span> <span class="n">classification_report</span>
<span class="kn">from</span> <span class="nn">sklearn.decomposition</span> <span class="kn">import</span> <span class="n">PCA</span>
<span class="kn">from</span> <span class="nn">sklearn.inspection</span> <span class="kn">import</span> <span class="n">DecisionBoundaryDisplay</span>
<span class="kn">import</span> <span class="nn">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>

<span class="k">def</span> <span class="nf">compare_classifiers</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">y</span><span class="p">,</span> <span class="n">test_size</span><span class="o">=</span><span class="mf">0.2</span><span class="p">,</span> <span class="n">random_state</span><span class="o">=</span><span class="mi">42</span><span class="p">):</span>
    <span class="s">"""
    Compare multiple classifiers on a dataset.

    Returns accuracy scores and trained models.
    """</span>
    <span class="c1"># Split data
</span>    <span class="n">X_train</span><span class="p">,</span> <span class="n">X_test</span><span class="p">,</span> <span class="n">y_train</span><span class="p">,</span> <span class="n">y_test</span> <span class="o">=</span> <span class="n">train_test_split</span><span class="p">(</span>
        <span class="n">X</span><span class="p">,</span> <span class="n">y</span><span class="p">,</span> <span class="n">test_size</span><span class="o">=</span><span class="n">test_size</span><span class="p">,</span> <span class="n">random_state</span><span class="o">=</span><span class="n">random_state</span>
    <span class="p">)</span>

    <span class="c1"># Initialize classifiers
</span>    <span class="n">classifiers</span> <span class="o">=</span> <span class="p">{</span>
        <span class="s">'Logistic Regression'</span><span class="p">:</span> <span class="n">LogisticRegression</span><span class="p">(</span><span class="n">max_iter</span><span class="o">=</span><span class="mi">1000</span><span class="p">),</span>
        <span class="s">'KNN (k=5)'</span><span class="p">:</span> <span class="n">KNeighborsClassifier</span><span class="p">(</span><span class="n">n_neighbors</span><span class="o">=</span><span class="mi">5</span><span class="p">),</span>
        <span class="s">'Naive Bayes'</span><span class="p">:</span> <span class="n">GaussianNB</span><span class="p">()</span>
    <span class="p">}</span>

    <span class="n">results</span> <span class="o">=</span> <span class="p">{}</span>
    <span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">clf</span> <span class="ow">in</span> <span class="n">classifiers</span><span class="p">.</span><span class="n">items</span><span class="p">():</span>
        <span class="n">clf</span><span class="p">.</span><span class="n">fit</span><span class="p">(</span><span class="n">X_train</span><span class="p">,</span> <span class="n">y_train</span><span class="p">)</span>
        <span class="n">y_pred</span> <span class="o">=</span> <span class="n">clf</span><span class="p">.</span><span class="n">predict</span><span class="p">(</span><span class="n">X_test</span><span class="p">)</span>
        <span class="n">results</span><span class="p">[</span><span class="n">name</span><span class="p">]</span> <span class="o">=</span> <span class="p">{</span>
            <span class="s">'accuracy'</span><span class="p">:</span> <span class="n">accuracy_score</span><span class="p">(</span><span class="n">y_test</span><span class="p">,</span> <span class="n">y_pred</span><span class="p">),</span>
            <span class="s">'model'</span><span class="p">:</span> <span class="n">clf</span>
        <span class="p">}</span>
        <span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">name</span><span class="si">}</span><span class="s">: </span><span class="si">{</span><span class="n">results</span><span class="p">[</span><span class="n">name</span><span class="p">][</span><span class="s">'accuracy'</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">f</span><span class="si">}</span><span class="s">"</span><span class="p">)</span>

    <span class="k">return</span> <span class="n">results</span>

<span class="k">def</span> <span class="nf">plot_decision_boundaries</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">y</span><span class="p">,</span> <span class="n">classifiers</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">15</span><span class="p">,</span> <span class="mi">4</span><span class="p">)):</span>
    <span class="s">"""
    Plot decision boundaries for multiple classifiers using PCA.
    """</span>
    <span class="c1"># Reduce to 2D
</span>    <span class="n">pca</span> <span class="o">=</span> <span class="n">PCA</span><span class="p">(</span><span class="n">n_components</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
    <span class="n">X_2d</span> <span class="o">=</span> <span class="n">pca</span><span class="p">.</span><span class="n">fit_transform</span><span class="p">(</span><span class="n">X</span><span class="p">)</span>

    <span class="c1"># Retrain on 2D data
</span>    <span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="n">subplots</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="nb">len</span><span class="p">(</span><span class="n">classifiers</span><span class="p">),</span> <span class="n">figsize</span><span class="o">=</span><span class="n">figsize</span><span class="p">)</span>

    <span class="k">for</span> <span class="n">ax</span><span class="p">,</span> <span class="p">(</span><span class="n">name</span><span class="p">,</span> <span class="n">clf</span><span class="p">)</span> <span class="ow">in</span> <span class="nb">zip</span><span class="p">(</span><span class="n">axes</span><span class="p">,</span> <span class="n">classifiers</span><span class="p">.</span><span class="n">items</span><span class="p">()):</span>
        <span class="c1"># Retrain on 2D
</span>        <span class="n">clf</span><span class="p">.</span><span class="n">fit</span><span class="p">(</span><span class="n">X_2d</span><span class="p">,</span> <span class="n">y</span><span class="p">)</span>

        <span class="c1"># Plot decision boundary
</span>        <span class="n">DecisionBoundaryDisplay</span><span class="p">.</span><span class="n">from_estimator</span><span class="p">(</span>
            <span class="n">clf</span><span class="p">,</span> <span class="n">X_2d</span><span class="p">,</span> <span class="n">response_method</span><span class="o">=</span><span class="s">"predict"</span><span class="p">,</span>
            <span class="n">alpha</span><span class="o">=</span><span class="mf">0.5</span><span class="p">,</span> <span class="n">ax</span><span class="o">=</span><span class="n">ax</span><span class="p">,</span> <span class="n">cmap</span><span class="o">=</span><span class="n">plt</span><span class="p">.</span><span class="n">cm</span><span class="p">.</span><span class="n">RdYlBu</span>
        <span class="p">)</span>

        <span class="c1"># Plot points
</span>        <span class="n">scatter</span> <span class="o">=</span> <span class="n">ax</span><span class="p">.</span><span class="n">scatter</span><span class="p">(</span><span class="n">X_2d</span><span class="p">[:,</span> <span class="mi">0</span><span class="p">],</span> <span class="n">X_2d</span><span class="p">[:,</span> <span class="mi">1</span><span class="p">],</span> <span class="n">c</span><span class="o">=</span><span class="n">y</span><span class="p">,</span>
                            <span class="n">edgecolor</span><span class="o">=</span><span class="s">"k"</span><span class="p">,</span> <span class="n">cmap</span><span class="o">=</span><span class="n">plt</span><span class="p">.</span><span class="n">cm</span><span class="p">.</span><span class="n">RdYlBu</span><span class="p">)</span>
        <span class="n">ax</span><span class="p">.</span><span class="n">set_title</span><span class="p">(</span><span class="n">name</span><span class="p">)</span>
        <span class="n">ax</span><span class="p">.</span><span class="n">set_xlabel</span><span class="p">(</span><span class="s">"PC1"</span><span class="p">)</span>
        <span class="n">ax</span><span class="p">.</span><span class="n">set_ylabel</span><span class="p">(</span><span class="s">"PC2"</span><span class="p">)</span>

    <span class="n">plt</span><span class="p">.</span><span class="n">tight_layout</span><span class="p">()</span>
    <span class="k">return</span> <span class="n">fig</span>
</code></pre></div></div>

<hr />

<p><em>PS: This work was completed at Georgia Tech. The original submission files can be provided upon request to validate that this work is entirely my own.</em></p>]]></content><author><name>Danny Tabach</name></author><category term="from-scratch" /><category term="classification" /><category term="machine-learning" /><category term="logistic-regression" /><category term="naive-bayes" /><category term="python" /><category term="numpy" /><summary type="html"><![CDATA[Given a data point, which class does it belong to? We build three different classifiers and see when each one shines.]]></summary></entry><entry><title type="html">Clustering Algorithms From Scratch</title><link href="https://danieltabach.github.io/from-scratch/clustering-from-scratch/" rel="alternate" type="text/html" title="Clustering Algorithms From Scratch" /><published>2025-01-17T00:00:00-05:00</published><updated>2025-01-17T00:00:00-05:00</updated><id>https://danieltabach.github.io/from-scratch/clustering-from-scratch</id><content type="html" xml:base="https://danieltabach.github.io/from-scratch/clustering-from-scratch/"><![CDATA[<p><em>You have 10,000 data points. How do you find natural groupings without any labels?</em></p>

<hr />

<h2 id="introduction">Introduction</h2>

<p>Clustering is one of those things that sounds simple until you try to implement it. “Group similar things together.” Easy, right? But what does “similar” mean? How many groups should there be? What if your data has weird shapes?</p>

<p>In this tutorial, we build two clustering algorithms from scratch:</p>

<ol>
  <li><strong>K-Means</strong>: The classic. Fast, interpretable, but assumes spherical clusters.</li>
  <li><strong>Spectral Clustering</strong>: Handles complex shapes by transforming the problem into a graph.</li>
</ol>

<p>We will apply K-Means to image compression (reducing millions of colors to just a few) and Spectral Clustering to network analysis (finding communities in a graph of political blogs).</p>

<p>All code is in NumPy. Obviously in practice you should pull Sklearn and do this in minutes, but this is a basic implementation of the algorithms underneath the packages.</p>

<p><strong>Just want the code?</strong> Skip to the <a href="#appendix-complete-implementations">Appendix</a> for copy-paste ready implementations.</p>

<hr />

<h2 id="part-1-k-means-clustering">Part 1: K-Means Clustering</h2>

<h3 id="problem-statement">Problem Statement</h3>

<p>Given $n$ data points ${x_1, x_2, \ldots, x_n}$ in $\mathbb{R}^d$, we want to partition them into $k$ clusters such that points within each cluster are as similar as possible.</p>

<p>The objective is to minimize the within-cluster sum of squares:</p>

\[J = \sum_{j=1}^{k} \sum_{x_i \in C_j} \|x_i - \mu_j\|^2\]

<p>Where:</p>
<ul>
  <li>$C_j$ is the set of points assigned to cluster $j$</li>
  <li>$\mu_j$ is the centroid (mean) of cluster $j$</li>
  <li>$|x_i - \mu_j|^2$ is the squared Euclidean distance</li>
</ul>

<h3 id="how-the-algorithm-works">How the Algorithm Works</h3>

<p>K-Means uses an iterative refinement approach:</p>

<ol>
  <li><strong>Initialize</strong>: Randomly select $k$ data points as initial centroids</li>
  <li><strong>Assign</strong>: For each point, find the nearest centroid and assign the point to that cluster</li>
  <li><strong>Update</strong>: Recalculate each centroid as the mean of all points assigned to it</li>
  <li><strong>Repeat</strong>: Go back to step 2 until centroids stop moving (or move very little)</li>
</ol>

<p>Why does this work? Each step either decreases the objective $J$ or leaves it unchanged. Assigning points to their nearest centroid minimizes distances given fixed centroids. Updating centroids to cluster means minimizes distances given fixed assignments. Since $J$ is bounded below by zero and decreases monotonically, the algorithm must converge.</p>

<details>
<summary><strong>See it with a tiny example</strong></summary>
<p>6 points in 2D, finding k=2 clusters:</p>
<table>
<tr><th>Point</th><th>X</th><th>Y</th></tr>
<tr><td>A</td><td>1</td><td>1</td></tr>
<tr><td>B</td><td>2</td><td>1</td></tr>
<tr><td>C</td><td>1</td><td>2</td></tr>
<tr><td>D</td><td>8</td><td>8</td></tr>
<tr><td>E</td><td>9</td><td>8</td></tr>
<tr><td>F</td><td>8</td><td>9</td></tr>
</table>
<p><strong>Iteration 1:</strong></p>
<ul>
<li>Random centroids: C1=(1,1), C2=(9,8)</li>
<li>Assign: A,B,C → C1 (closer), D,E,F → C2</li>
<li>Update: C1 = mean(A,B,C) = (1.33, 1.33), C2 = mean(D,E,F) = (8.33, 8.33)</li>
</ul>
<p><strong>Iteration 2:</strong></p>
<ul>
<li>Assign: same assignments (centroids barely moved)</li>
<li>Update: same centroids</li>
<li><strong>Converged!</strong></li>
</ul>
<p>Final clusters: {A,B,C} and {D,E,F}</p>
</details>

<h3 id="implementation">Implementation</h3>

<p>Let’s build it piece by piece.</p>

<h4 id="step-1-cluster-assignment">Step 1: Cluster Assignment</h4>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">assign_clusters</span><span class="p">(</span><span class="n">data</span><span class="p">,</span> <span class="n">centroids</span><span class="p">,</span> <span class="n">norm</span><span class="o">=</span><span class="mi">2</span><span class="p">):</span>
    <span class="s">"""
    Assign each data point to its nearest centroid.

    Parameters:
    - data: array of shape (n_samples, n_features)
    - centroids: array of shape (k_clusters, n_features)
    - norm: which distance metric (2 = Euclidean, 1 = Manhattan)

    Returns:
    - labels: array of shape (n_samples,) with cluster assignments 0 to k-1
    """</span>
    <span class="c1"># Calculate distance from each point to each centroid
</span>    <span class="c1"># data[:, np.newaxis] adds a dimension so we can broadcast against all k centroids
</span>    <span class="c1"># Original shape: (n_samples, n_features)
</span>    <span class="c1"># After newaxis: (n_samples, 1, n_features)
</span>    <span class="c1"># Centroids shape: (k_clusters, n_features)
</span>    <span class="c1"># Result of subtraction: (n_samples, k_clusters, n_features)
</span>    <span class="c1"># After norm: (n_samples, k_clusters)
</span>    <span class="n">distances</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">linalg</span><span class="p">.</span><span class="n">norm</span><span class="p">(</span> <span class="c1"># there is another version of this function that I wasn't able to use. 
</span>        <span class="n">data</span><span class="p">[:,</span> <span class="n">np</span><span class="p">.</span><span class="n">newaxis</span><span class="p">]</span> <span class="o">-</span> <span class="n">centroids</span><span class="p">,</span>
        <span class="n">axis</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span>
        <span class="nb">ord</span><span class="o">=</span><span class="n">norm</span>
    <span class="p">)</span>

    <span class="c1"># For each point, find which centroid is closest
</span>    <span class="c1"># argmin returns the INDEX of the minimum value
</span>    <span class="k">return</span> <span class="n">np</span><span class="p">.</span><span class="n">argmin</span><span class="p">(</span><span class="n">distances</span><span class="p">,</span> <span class="n">axis</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
</code></pre></div></div>

<p><strong>What happens if you change this?</strong> Setting <code class="language-plaintext highlighter-rouge">norm=1</code> switches to Manhattan distance (sum of absolute differences). Manhattan distance is less sensitive to outliers and works better when your features have different scales or when you care about axis-aligned distances.</p>

<h4 id="step-2-centroid-update">Step 2: Centroid Update</h4>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">update_centroids</span><span class="p">(</span><span class="n">data</span><span class="p">,</span> <span class="n">labels</span><span class="p">,</span> <span class="n">k</span><span class="p">):</span>
    <span class="s">"""
    Compute new centroids as the mean of assigned points.

    Parameters:
    - data: array of shape (n_samples, n_features)
    - labels: array of shape (n_samples,) with cluster assignments
    - k: number of clusters

    Returns:
    - new_centroids: array of shape (k_clusters, n_features)
    """</span>
    <span class="n">n_features</span> <span class="o">=</span> <span class="n">data</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span>
    <span class="n">centroids</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">zeros</span><span class="p">((</span><span class="n">k</span><span class="p">,</span> <span class="n">n_features</span><span class="p">))</span>

    <span class="k">for</span> <span class="n">j</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">k</span><span class="p">):</span>
        <span class="c1"># Find all points belonging to cluster j
</span>        <span class="n">cluster_points</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span><span class="n">labels</span> <span class="o">==</span> <span class="n">j</span><span class="p">]</span>

        <span class="k">if</span> <span class="nb">len</span><span class="p">(</span><span class="n">cluster_points</span><span class="p">)</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="p">:</span>
            <span class="c1"># Centroid is the mean of all points in the cluster
</span>            <span class="n">centroids</span><span class="p">[</span><span class="n">j</span><span class="p">]</span> <span class="o">=</span> <span class="n">cluster_points</span><span class="p">.</span><span class="n">mean</span><span class="p">(</span><span class="n">axis</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span>
        <span class="k">else</span><span class="p">:</span>
            <span class="c1"># Empty cluster! Reinitialize to a random data point
</span>            <span class="n">centroids</span><span class="p">[</span><span class="n">j</span><span class="p">]</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span><span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">randint</span><span class="p">(</span><span class="nb">len</span><span class="p">(</span><span class="n">data</span><span class="p">))]</span>

    <span class="k">return</span> <span class="n">centroids</span>
</code></pre></div></div>

<p><strong>What happens if you change this?</strong> Empty clusters are a real problem for a manual implementation like this. If a centroid drifts away from all data points, it gets no assignments and becomes useless. The code above handles this by reinitializing to a random point. Another approach is to reinitialize to the point furthest from its assigned centroid, which spreads centroids more evenly.</p>

<h4 id="step-3-convergence-check">Step 3: Convergence Check</h4>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">has_converged</span><span class="p">(</span><span class="n">old_centroids</span><span class="p">,</span> <span class="n">new_centroids</span><span class="p">,</span> <span class="n">tolerance</span><span class="o">=</span><span class="mf">1e-4</span><span class="p">):</span>
    <span class="s">"""
    Check if centroids have stopped moving.

    We measure the total movement of all centroids and compare to a tolerance.
    """</span>
    <span class="c1"># Sum of squared distances between old and new centroid positions
</span>    <span class="n">shift</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nb">sum</span><span class="p">((</span><span class="n">old_centroids</span> <span class="o">-</span> <span class="n">new_centroids</span><span class="p">)</span> <span class="o">**</span> <span class="mi">2</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">shift</span> <span class="o">&lt;</span> <span class="n">tolerance</span>
</code></pre></div></div>

<p><strong>What happens if you change this?</strong> A larger tolerance (like 0.1) makes the algorithm stop earlier, potentially before centroids have fully settled. A smaller tolerance (like 0.0001) gives more precision but takes more iterations. For image compression, you often do not need high precision since visual differences are imperceptible.</p>

<h4 id="putting-it-together">Putting It Together</h4>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">kmeans</span><span class="p">(</span><span class="n">data</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">norm</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span> <span class="n">max_iters</span><span class="o">=</span><span class="mi">100</span><span class="p">,</span> <span class="n">tolerance</span><span class="o">=</span><span class="mf">1e-4</span><span class="p">,</span> <span class="n">seed</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
    <span class="s">"""
    Full K-Means implementation.

    Parameters:
    - data: array of shape (n_samples, n_features)
    - k: number of clusters
    - norm: distance metric (2 = Euclidean, 1 = Manhattan)
    - max_iters: maximum iterations before stopping
    - tolerance: convergence threshold
    - seed: random seed for reproducibility

    Returns:
    - labels: cluster assignments
    - centroids: final centroid positions
    - iterations: number of iterations until convergence
    """</span>
    <span class="k">if</span> <span class="n">seed</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
        <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">seed</span><span class="p">(</span><span class="n">seed</span><span class="p">)</span>

    <span class="n">n_samples</span> <span class="o">=</span> <span class="n">data</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>

    <span class="c1"># Initialize: randomly select k data points as starting centroids
</span>    <span class="c1"># This is called "Forgy initialization"
</span>    <span class="n">random_indices</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">choice</span><span class="p">(</span><span class="n">n_samples</span><span class="p">,</span> <span class="n">size</span><span class="o">=</span><span class="n">k</span><span class="p">,</span> <span class="n">replace</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
    <span class="n">centroids</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span><span class="n">random_indices</span><span class="p">].</span><span class="n">copy</span><span class="p">()</span>

    <span class="k">for</span> <span class="n">iteration</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">max_iters</span><span class="p">):</span>
        <span class="c1"># Step 1: Assign each point to nearest centroid
</span>        <span class="n">labels</span> <span class="o">=</span> <span class="n">assign_clusters</span><span class="p">(</span><span class="n">data</span><span class="p">,</span> <span class="n">centroids</span><span class="p">,</span> <span class="n">norm</span><span class="p">)</span>

        <span class="c1"># Step 2: Update centroids to cluster means
</span>        <span class="n">new_centroids</span> <span class="o">=</span> <span class="n">update_centroids</span><span class="p">(</span><span class="n">data</span><span class="p">,</span> <span class="n">labels</span><span class="p">,</span> <span class="n">k</span><span class="p">)</span>

        <span class="c1"># Step 3: Check for convergence
</span>        <span class="k">if</span> <span class="n">has_converged</span><span class="p">(</span><span class="n">centroids</span><span class="p">,</span> <span class="n">new_centroids</span><span class="p">,</span> <span class="n">tolerance</span><span class="p">):</span>
            <span class="k">return</span> <span class="n">labels</span><span class="p">,</span> <span class="n">new_centroids</span><span class="p">,</span> <span class="n">iteration</span> <span class="o">+</span> <span class="mi">1</span>

        <span class="n">centroids</span> <span class="o">=</span> <span class="n">new_centroids</span>

    <span class="c1"># Did not converge within max_iters
</span>    <span class="k">return</span> <span class="n">labels</span><span class="p">,</span> <span class="n">centroids</span><span class="p">,</span> <span class="n">max_iters</span>
</code></pre></div></div>

<h3 id="handling-initialization-sensitivity">Handling Initialization Sensitivity</h3>

<p>K-Means has a dirty secret: the final result depends heavily on where you start. Bad initialization can lead to poor local minima.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">kmeans_best_of_n</span><span class="p">(</span><span class="n">data</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">n_runs</span><span class="o">=</span><span class="mi">10</span><span class="p">,</span> <span class="o">**</span><span class="n">kwargs</span><span class="p">):</span>
    <span class="s">"""
    Run K-Means multiple times and keep the best result.

    "Best" means lowest within-cluster sum of squares (WCSS).
    """</span>
    <span class="n">best_labels</span> <span class="o">=</span> <span class="bp">None</span>
    <span class="n">best_centroids</span> <span class="o">=</span> <span class="bp">None</span>
    <span class="n">best_wcss</span> <span class="o">=</span> <span class="nb">float</span><span class="p">(</span><span class="s">'inf'</span><span class="p">)</span>

    <span class="k">for</span> <span class="n">run</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">n_runs</span><span class="p">):</span>
        <span class="n">labels</span><span class="p">,</span> <span class="n">centroids</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="n">kmeans</span><span class="p">(</span><span class="n">data</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">seed</span><span class="o">=</span><span class="n">run</span><span class="p">,</span> <span class="o">**</span><span class="n">kwargs</span><span class="p">)</span>

        <span class="c1"># Calculate within-cluster sum of squares
</span>        <span class="n">wcss</span> <span class="o">=</span> <span class="mi">0</span>
        <span class="k">for</span> <span class="n">j</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">k</span><span class="p">):</span>
            <span class="n">cluster_points</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span><span class="n">labels</span> <span class="o">==</span> <span class="n">j</span><span class="p">]</span>
            <span class="k">if</span> <span class="nb">len</span><span class="p">(</span><span class="n">cluster_points</span><span class="p">)</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="p">:</span>
                <span class="n">wcss</span> <span class="o">+=</span> <span class="n">np</span><span class="p">.</span><span class="nb">sum</span><span class="p">((</span><span class="n">cluster_points</span> <span class="o">-</span> <span class="n">centroids</span><span class="p">[</span><span class="n">j</span><span class="p">])</span> <span class="o">**</span> <span class="mi">2</span><span class="p">)</span>

        <span class="k">if</span> <span class="n">wcss</span> <span class="o">&lt;</span> <span class="n">best_wcss</span><span class="p">:</span>
            <span class="n">best_wcss</span> <span class="o">=</span> <span class="n">wcss</span>
            <span class="n">best_labels</span> <span class="o">=</span> <span class="n">labels</span>
            <span class="n">best_centroids</span> <span class="o">=</span> <span class="n">centroids</span>

    <span class="k">return</span> <span class="n">best_labels</span><span class="p">,</span> <span class="n">best_centroids</span><span class="p">,</span> <span class="n">best_wcss</span>
</code></pre></div></div>

<p><strong>What happens if you change this?</strong> More runs increase your chances of finding a good solution but take longer. For most applications, 10 runs is sufficient. If you run this multiple times with different seeds, you will notice the WCSS varies. The variance decreases as you increase <code class="language-plaintext highlighter-rouge">n_runs</code>.</p>

<hr />

<h2 id="application-image-compression">Application: Image Compression</h2>

<h3 id="problem-statement-1">Problem Statement</h3>

<p>A color image is just a matrix of RGB values. Each pixel has three numbers (red, green, blue), each ranging from 0 to 255. A 400x225 image has 90,000 pixels, and if each pixel can be any of 16.7 million colors ($256^3$), that is a lot of data.</p>

<p>What if we limited the image to just $k$ colors? We would lose some detail, but the file size shrinks dramatically. This is lossy compression.</p>

<p>The approach:</p>
<ol>
  <li>Treat each pixel as a 3D point (R, G, B)</li>
  <li>Run K-Means to find $k$ cluster centroids</li>
  <li>Replace each pixel with its nearest centroid color</li>
</ol>

<h3 id="results">Results</h3>

<table>
  <thead>
    <tr>
      <th>k (colors)</th>
      <th>Converged</th>
      <th>Iterations</th>
      <th>Visual Quality</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>3</td>
      <td>Yes</td>
      <td>14</td>
      <td>Posterized, obvious color banding</td>
    </tr>
    <tr>
      <td>6</td>
      <td>Yes</td>
      <td>19</td>
      <td>Better gradients, still simplified</td>
    </tr>
    <tr>
      <td>12</td>
      <td>Yes</td>
      <td>23</td>
      <td>Good for graphics, slight loss on photos</td>
    </tr>
    <tr>
      <td>24</td>
      <td>Yes</td>
      <td>31</td>
      <td>Harder to distinguish from original</td>
    </tr>
  </tbody>
</table>

<p><img src="/assets/images/posts/clustering/shrek_original.png" alt="Original image" />
<em>Original image with millions of possible colors</em></p>

<p><img src="/assets/images/posts/clustering/compressed_shrek_cluster_3.png" alt="Compressed to 3 colors" />
<em>k=3: Only three colors. Dramatic posterization effect.</em></p>

<p><img src="/assets/images/posts/clustering/compressed_shrek_cluster_12.png" alt="Compressed to 12 colors" />
<em>k=12: Still a bit shaky on the details.</em></p>

<p><img src="/assets/images/posts/clustering/compressed_shrek_cluster_24.png" alt="Compressed to 24 colors" />
<em>k=24: The colors start to resemble the original.</em></p>

<p>Honestly, there is probably a way to make good pixel-art out of this.</p>

<h3 id="compression-code">Compression Code</h3>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">compress_image</span><span class="p">(</span><span class="n">image_path</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">norm</span><span class="o">=</span><span class="mi">2</span><span class="p">):</span>
    <span class="s">"""
    Compress an image to k colors using K-Means.

    Parameters:
    - image_path: path to the input image
    - k: number of colors in compressed image
    - norm: distance metric for K-Means

    Returns:
    - compressed: the compressed image array
    - centroids: the k colors used
    """</span>
    <span class="c1"># Load image and get dimensions
</span>    <span class="n">img</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="n">imread</span><span class="p">(</span><span class="n">image_path</span><span class="p">)</span>
    <span class="n">height</span><span class="p">,</span> <span class="n">width</span><span class="p">,</span> <span class="n">channels</span> <span class="o">=</span> <span class="n">img</span><span class="p">.</span><span class="n">shape</span>

    <span class="c1"># Reshape from (H, W, 3) to (H*W, 3)
</span>    <span class="c1"># Each row is now one pixel with R, G, B values
</span>    <span class="n">pixels</span> <span class="o">=</span> <span class="n">img</span><span class="p">.</span><span class="n">reshape</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="mi">3</span><span class="p">)</span>

    <span class="c1"># Convert to float if needed (some images are 0-255 integers)
</span>    <span class="k">if</span> <span class="n">pixels</span><span class="p">.</span><span class="nb">max</span><span class="p">()</span> <span class="o">&gt;</span> <span class="mi">1</span><span class="p">:</span>
        <span class="n">pixels</span> <span class="o">=</span> <span class="n">pixels</span> <span class="o">/</span> <span class="mf">255.0</span>

    <span class="c1"># Run K-Means to find k representative colors
</span>    <span class="n">labels</span><span class="p">,</span> <span class="n">centroids</span><span class="p">,</span> <span class="n">iterations</span> <span class="o">=</span> <span class="n">kmeans</span><span class="p">(</span><span class="n">pixels</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">norm</span><span class="o">=</span><span class="n">norm</span><span class="p">)</span>

    <span class="c1"># Replace each pixel with its centroid color
</span>    <span class="n">compressed_pixels</span> <span class="o">=</span> <span class="n">centroids</span><span class="p">[</span><span class="n">labels</span><span class="p">]</span>

    <span class="c1"># Reshape back to image dimensions
</span>    <span class="n">compressed</span> <span class="o">=</span> <span class="n">compressed_pixels</span><span class="p">.</span><span class="n">reshape</span><span class="p">(</span><span class="n">height</span><span class="p">,</span> <span class="n">width</span><span class="p">,</span> <span class="n">channels</span><span class="p">)</span>

    <span class="k">return</span> <span class="n">compressed</span><span class="p">,</span> <span class="n">centroids</span>
</code></pre></div></div>

<h3 id="euclidean-vs-manhattan-distance">Euclidean vs Manhattan Distance</h3>

<p>Does the distance metric matter for image compression?</p>

<table>
  <thead>
    <tr>
      <th>Metric</th>
      <th>k=12 WCSS</th>
      <th>Visual Difference</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Euclidean (L2)</td>
      <td>0.0142</td>
      <td>Smooth gradients</td>
    </tr>
    <tr>
      <td>Manhattan (L1)</td>
      <td>0.0156</td>
      <td>Slightly more saturated colors</td>
    </tr>
  </tbody>
</table>

<p>The difference is subtle. Euclidean tends to produce colors that are perceptually “average,” while Manhattan can produce colors that are slightly more vivid because it weights each RGB channel equally rather than penalizing large deviations in any single channel.</p>

<hr />

<h2 id="part-2-spectral-clustering">Part 2: Spectral Clustering</h2>

<h3 id="the-problem-with-k-means">The Problem with K-Means</h3>

<p>K-Means assumes clusters are spherical. It draws straight lines between cluster centers. What if your data looks like two interlocking spirals? Or two concentric circles? K-Means fails badly.</p>

<p>Spectral Clustering takes a different approach: instead of clustering points directly in their original space, we first transform them into a space where clusters become separable.</p>

<h3 id="the-core-idea">The Core Idea</h3>

<p><strong>Plain English:</strong> We build a graph where similar points are connected. Then we find a way to “cut” the graph into pieces such that we cut as few edges as possible.</p>

<p><strong>Why this helps:</strong> If two points are similar, they are connected. If two clusters exist, there should be fewer connections between clusters than within them. Finding a good cut means finding the natural cluster boundaries.</p>

<p><strong>The trick:</strong> Instead of literally finding cuts (which is NP-hard), we use the eigenvectors of a special matrix called the Graph Laplacian. The eigenvectors magically encode cluster membership.</p>

<h3 id="the-graph-laplacian">The Graph Laplacian</h3>

<p><strong>Plain English:</strong> The Laplacian is a matrix that captures how “different” each node is from its neighbors.</p>

<p><strong>Intuition:</strong> Imagine spreading heat through a network. Heat flows easily between connected nodes. The Laplacian describes this diffusion process. Clusters act like insulated regions where heat stays trapped.</p>

<p><strong>The formula:</strong></p>

<p>Given a graph with $n$ nodes:</p>

<ol>
  <li>
    <p><strong>Adjacency matrix $A$</strong>: An $n \times n$ matrix where $A_{ij} = 1$ if node $i$ connects to node $j$, and 0 otherwise.</p>
  </li>
  <li>
    <p><strong>Degree matrix $D$</strong>: A diagonal matrix where $D_{ii}$ equals the number of connections for node $i$.</p>
  </li>
  <li>
    <p><strong>Graph Laplacian</strong>: $L = D - A$</p>
  </li>
</ol>

<details>
<summary><strong>See it with a tiny example</strong></summary>
<p>Consider 4 nodes with this connection pattern:</p>
<pre>1 --- 2
|     |
3 --- 4</pre>
<p><strong>Adjacency matrix A</strong> (who connects to whom):</p>
<table>
<tr><th></th><th>1</th><th>2</th><th>3</th><th>4</th></tr>
<tr><td><strong>1</strong></td><td>0</td><td>1</td><td>1</td><td>0</td></tr>
<tr><td><strong>2</strong></td><td>1</td><td>0</td><td>0</td><td>1</td></tr>
<tr><td><strong>3</strong></td><td>1</td><td>0</td><td>0</td><td>1</td></tr>
<tr><td><strong>4</strong></td><td>0</td><td>1</td><td>1</td><td>0</td></tr>
</table>
<p><strong>Degree matrix D</strong> (count of connections per node):</p>
<table>
<tr><th></th><th>1</th><th>2</th><th>3</th><th>4</th></tr>
<tr><td><strong>1</strong></td><td>2</td><td>0</td><td>0</td><td>0</td></tr>
<tr><td><strong>2</strong></td><td>0</td><td>2</td><td>0</td><td>0</td></tr>
<tr><td><strong>3</strong></td><td>0</td><td>0</td><td>2</td><td>0</td></tr>
<tr><td><strong>4</strong></td><td>0</td><td>0</td><td>0</td><td>2</td></tr>
</table>
<p><strong>Laplacian L = D - A</strong>:</p>
<table>
<tr><th></th><th>1</th><th>2</th><th>3</th><th>4</th></tr>
<tr><td><strong>1</strong></td><td>2</td><td>-1</td><td>-1</td><td>0</td></tr>
<tr><td><strong>2</strong></td><td>-1</td><td>2</td><td>0</td><td>-1</td></tr>
<tr><td><strong>3</strong></td><td>-1</td><td>0</td><td>2</td><td>-1</td></tr>
<tr><td><strong>4</strong></td><td>0</td><td>-1</td><td>-1</td><td>2</td></tr>
</table>
<p>Notice: each row sums to 0. The diagonal shows the degree, off-diagonal shows negative connections.</p>
</details>

<p><strong>Code:</strong></p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">compute_laplacian</span><span class="p">(</span><span class="n">adjacency_matrix</span><span class="p">):</span>
    <span class="s">"""
    Compute the graph Laplacian from an adjacency matrix.

    The Laplacian L = D - A where:
    - D is the degree matrix (diagonal, D[i,i] = sum of row i in A)
    - A is the adjacency matrix

    Parameters:
    - adjacency_matrix: n x n symmetric matrix of edge weights

    Returns:
    - laplacian: n x n Laplacian matrix
    """</span>
    <span class="c1"># Degree of each node = sum of its edge weights
</span>    <span class="c1"># For unweighted graphs, this is just the number of neighbors
</span>    <span class="n">degrees</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nb">sum</span><span class="p">(</span><span class="n">adjacency_matrix</span><span class="p">,</span> <span class="n">axis</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>

    <span class="c1"># Degree matrix is diagonal with degrees on the diagonal
</span>    <span class="n">degree_matrix</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">diag</span><span class="p">(</span><span class="n">degrees</span><span class="p">)</span>

    <span class="c1"># Laplacian = Degree - Adjacency
</span>    <span class="n">laplacian</span> <span class="o">=</span> <span class="n">degree_matrix</span> <span class="o">-</span> <span class="n">adjacency_matrix</span>

    <span class="k">return</span> <span class="n">laplacian</span>
</code></pre></div></div>

<h3 id="why-eigenvectors">Why Eigenvectors?</h3>

<p>This is where it gets interesting.</p>

<p>The smallest eigenvalue of the Laplacian is always 0, with a constant eigenvector (all ones). This is not useful for clustering.</p>

<p>The second smallest eigenvalue is called the Fiedler value. Its eigenvector, the Fiedler vector, contains cluster information. Points with similar values in the Fiedler vector belong to the same cluster.</p>

<details>
<summary><strong>See it with a tiny example</strong></summary>
<p>Using the same 4-node graph, here are the Laplacian's eigenvectors:</p>
<table>
<tr><th>Eigenvalue</th><th>Eigenvector</th><th>Interpretation</th></tr>
<tr><td>0</td><td>[0.5, 0.5, 0.5, 0.5]</td><td>Constant (useless)</td></tr>
<tr><td>2</td><td>[0.5, -0.5, -0.5, 0.5]</td><td><strong>Fiedler vector</strong></td></tr>
<tr><td>2</td><td>[0.5, -0.5, 0.5, -0.5]</td><td>Third eigenvector</td></tr>
<tr><td>4</td><td>[0.5, 0.5, -0.5, -0.5]</td><td>Fourth eigenvector</td></tr>
</table>
<p><strong>The Fiedler vector</strong> [0.5, -0.5, -0.5, 0.5] groups:</p>
<ul>
<li>Nodes 1 and 4 together (positive values)</li>
<li>Nodes 2 and 3 together (negative values)</li>
</ul>
<p>This matches the graph structure: 1-4 are diagonal partners, 2-3 are diagonal partners.</p>
<p>For k=2 clusters: take the sign of the Fiedler vector → Cluster A: {1,4}, Cluster B: {2,3}</p>
</details>

<p>For $k$ clusters, we use the $k$ smallest eigenvectors. We stack them into an $n \times k$ matrix, where each row represents a node. Then we run K-Means on these rows.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">spectral_clustering</span><span class="p">(</span><span class="n">adjacency_matrix</span><span class="p">,</span> <span class="n">k</span><span class="p">):</span>
    <span class="s">"""
    Cluster nodes using spectral clustering.

    Parameters:
    - adjacency_matrix: n x n symmetric matrix
    - k: number of clusters

    Returns:
    - labels: cluster assignment for each node
    """</span>
    <span class="c1"># Step 1: Compute the Laplacian
</span>    <span class="n">laplacian</span> <span class="o">=</span> <span class="n">compute_laplacian</span><span class="p">(</span><span class="n">adjacency_matrix</span><span class="p">)</span>

    <span class="c1"># Step 2: Find the k smallest eigenvectors
</span>    <span class="c1"># eigh is for symmetric matrices (faster and more stable than eig)
</span>    <span class="c1"># eigenvalues come out sorted in ascending order
</span>    <span class="n">eigenvalues</span><span class="p">,</span> <span class="n">eigenvectors</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">linalg</span><span class="p">.</span><span class="n">eigh</span><span class="p">(</span><span class="n">laplacian</span><span class="p">)</span>

    <span class="c1"># Take the k eigenvectors corresponding to k smallest eigenvalues
</span>    <span class="c1"># Skip the first one (eigenvalue = 0, eigenvector = constant)
</span>    <span class="c1"># Actually, we include it but K-Means will handle it
</span>    <span class="n">embedding</span> <span class="o">=</span> <span class="n">eigenvectors</span><span class="p">[:,</span> <span class="p">:</span><span class="n">k</span><span class="p">]</span>

    <span class="c1"># Step 3: Normalize rows (optional but often helps)
</span>    <span class="c1"># This puts each point on the unit sphere
</span>    <span class="n">row_norms</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">linalg</span><span class="p">.</span><span class="n">norm</span><span class="p">(</span><span class="n">embedding</span><span class="p">,</span> <span class="n">axis</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdims</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="n">row_norms</span><span class="p">[</span><span class="n">row_norms</span> <span class="o">==</span> <span class="mi">0</span><span class="p">]</span> <span class="o">=</span> <span class="mi">1</span>  <span class="c1"># avoid division by zero
</span>    <span class="n">embedding_normalized</span> <span class="o">=</span> <span class="n">embedding</span> <span class="o">/</span> <span class="n">row_norms</span>

    <span class="c1"># Step 4: Run K-Means on the embedded points
</span>    <span class="n">labels</span><span class="p">,</span> <span class="n">_</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="n">kmeans</span><span class="p">(</span><span class="n">embedding_normalized</span><span class="p">,</span> <span class="n">k</span><span class="p">)</span>

    <span class="k">return</span> <span class="n">labels</span>
</code></pre></div></div>

<p><strong>What happens if you change this?</strong></p>

<ul>
  <li>Using <code class="language-plaintext highlighter-rouge">eig</code> instead of <code class="language-plaintext highlighter-rouge">eigh</code>: Works but is slower and can have numerical issues. <code class="language-plaintext highlighter-rouge">eigh</code> is designed for symmetric matrices and guarantees real eigenvalues. (also it just <em>works</em>)</li>
  <li>Skipping normalization: Often still works, but normalization makes clusters more spherical in the embedding space, which helps K-Means.</li>
  <li>Using more eigenvectors than clusters: Adds noise without adding information. Stick to exactly $k$.</li>
</ul>

<hr />

<h2 id="application-political-blog-networks">Application: Political Blog Networks</h2>

<h3 id="problem-statement-2">Problem Statement</h3>

<p>We have a network of 1,490 political blogs from 2004. Each blog has a known political leaning (liberal or conservative). Blogs link to each other, creating a network. Can spectral clustering recover the two political communities from the link structure alone?</p>

<p>The data:</p>
<ul>
  <li><strong>nodes.txt</strong>: Blog IDs, URLs, and ground-truth labels (0 = liberal, 1 = conservative)</li>
  <li><strong>edges.txt</strong>: Pairs of connected blogs</li>
</ul>

<table>
  <tbody>
    <tr>
      <td><a href="/assets/data/nodes_sample.txt">Download sample data: nodes</a></td>
      <td><a href="/assets/data/edges_sample.txt">edges</a></td>
    </tr>
  </tbody>
</table>

<h3 id="building-the-adjacency-matrix">Building the Adjacency Matrix</h3>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">load_blog_network</span><span class="p">(</span><span class="n">nodes_path</span><span class="p">,</span> <span class="n">edges_path</span><span class="p">):</span>
    <span class="s">"""
    Load the political blogs network.

    Returns:
    - adjacency: n x n symmetric adjacency matrix
    - labels: ground truth political labels
    """</span>
    <span class="c1"># Load nodes
</span>    <span class="c1"># Format: id, url, label, source
</span>    <span class="n">nodes</span> <span class="o">=</span> <span class="p">{}</span>
    <span class="n">labels</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">with</span> <span class="nb">open</span><span class="p">(</span><span class="n">nodes_path</span><span class="p">,</span> <span class="s">'r'</span><span class="p">)</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
        <span class="k">for</span> <span class="n">line</span> <span class="ow">in</span> <span class="n">f</span><span class="p">:</span>
            <span class="n">parts</span> <span class="o">=</span> <span class="n">line</span><span class="p">.</span><span class="n">strip</span><span class="p">().</span><span class="n">split</span><span class="p">(</span><span class="s">'</span><span class="se">\t</span><span class="s">'</span><span class="p">)</span>
            <span class="n">node_id</span> <span class="o">=</span> <span class="nb">int</span><span class="p">(</span><span class="n">parts</span><span class="p">[</span><span class="mi">0</span><span class="p">])</span>
            <span class="n">label</span> <span class="o">=</span> <span class="nb">int</span><span class="p">(</span><span class="n">parts</span><span class="p">[</span><span class="mi">2</span><span class="p">])</span>
            <span class="n">nodes</span><span class="p">[</span><span class="n">node_id</span><span class="p">]</span> <span class="o">=</span> <span class="nb">len</span><span class="p">(</span><span class="n">labels</span><span class="p">)</span>  <span class="c1"># map to 0-indexed
</span>            <span class="n">labels</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">label</span><span class="p">)</span>

    <span class="n">n</span> <span class="o">=</span> <span class="nb">len</span><span class="p">(</span><span class="n">labels</span><span class="p">)</span>
    <span class="n">adjacency</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">zeros</span><span class="p">((</span><span class="n">n</span><span class="p">,</span> <span class="n">n</span><span class="p">))</span>

    <span class="c1"># Load edges
</span>    <span class="c1"># Format: node1, node2 (tab-separated)
</span>    <span class="k">with</span> <span class="nb">open</span><span class="p">(</span><span class="n">edges_path</span><span class="p">,</span> <span class="s">'r'</span><span class="p">)</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
        <span class="k">for</span> <span class="n">line</span> <span class="ow">in</span> <span class="n">f</span><span class="p">:</span>
            <span class="n">parts</span> <span class="o">=</span> <span class="n">line</span><span class="p">.</span><span class="n">strip</span><span class="p">().</span><span class="n">split</span><span class="p">(</span><span class="s">'</span><span class="se">\t</span><span class="s">'</span><span class="p">)</span>
            <span class="n">n1</span><span class="p">,</span> <span class="n">n2</span> <span class="o">=</span> <span class="nb">int</span><span class="p">(</span><span class="n">parts</span><span class="p">[</span><span class="mi">0</span><span class="p">]),</span> <span class="nb">int</span><span class="p">(</span><span class="n">parts</span><span class="p">[</span><span class="mi">1</span><span class="p">])</span>
            <span class="k">if</span> <span class="n">n1</span> <span class="ow">in</span> <span class="n">nodes</span> <span class="ow">and</span> <span class="n">n2</span> <span class="ow">in</span> <span class="n">nodes</span><span class="p">:</span>
                <span class="n">i</span><span class="p">,</span> <span class="n">j</span> <span class="o">=</span> <span class="n">nodes</span><span class="p">[</span><span class="n">n1</span><span class="p">],</span> <span class="n">nodes</span><span class="p">[</span><span class="n">n2</span><span class="p">]</span>
                <span class="n">adjacency</span><span class="p">[</span><span class="n">i</span><span class="p">,</span> <span class="n">j</span><span class="p">]</span> <span class="o">=</span> <span class="mi">1</span>
                <span class="n">adjacency</span><span class="p">[</span><span class="n">j</span><span class="p">,</span> <span class="n">i</span><span class="p">]</span> <span class="o">=</span> <span class="mi">1</span>  <span class="c1"># symmetric
</span>
    <span class="k">return</span> <span class="n">adjacency</span><span class="p">,</span> <span class="n">np</span><span class="p">.</span><span class="n">array</span><span class="p">(</span><span class="n">labels</span><span class="p">)</span>
</code></pre></div></div>

<h3 id="results-1">Results</h3>

<table>
  <thead>
    <tr>
      <th>Method</th>
      <th>Accuracy</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Spectral Clustering (k=2)</td>
      <td>93.4%</td>
    </tr>
    <tr>
      <td>Random Guessing</td>
      <td>50%</td>
    </tr>
  </tbody>
</table>

<p>Spectral clustering correctly identifies the political leaning of 93.4% of blogs using only the link structure. No text analysis, no metadata, just who links to whom.</p>

<p><strong>Why does this work?</strong> Political blogs tend to link to blogs with similar views. Liberal blogs link to liberal blogs. Conservative blogs link to conservative blogs. This creates two densely connected communities with relatively few cross-links. The Laplacian eigenvectors capture exactly this structure.</p>

<h3 id="visualizing-the-result">Visualizing the Result</h3>

<p>The Fiedler vector (second eigenvector) cleanly separates the two communities:</p>

<table>
  <thead>
    <tr>
      <th>Fiedler Value Range</th>
      <th>Dominant Label</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Negative values</td>
      <td>Liberal (92% of nodes)</td>
    </tr>
    <tr>
      <td>Positive values</td>
      <td>Conservative (95% of nodes)</td>
    </tr>
  </tbody>
</table>

<p>Most misclassifications occur at the boundary where a blog has roughly equal links to both communities.</p>

<hr />

<h2 id="summary">Summary</h2>

<h3 id="k-means">K-Means</h3>

<ul>
  <li>Minimizes within-cluster sum of squares</li>
  <li>Assumes spherical, equal-sized clusters</li>
  <li>Sensitive to initialization. Run it multiple times.</li>
  <li>Fast and interpretable</li>
  <li>Great for: color quantization, customer segmentation, feature discretization</li>
</ul>

<h3 id="spectral-clustering">Spectral Clustering</h3>

<ul>
  <li>Transforms data using graph Laplacian eigenvectors</li>
  <li>Handles non-convex cluster shapes</li>
  <li>Requires building a similarity graph first</li>
  <li>Computationally expensive for large datasets</li>
  <li>Great for: community detection, image segmentation, any data with natural graph structure</li>
</ul>

<h3 id="general-principles">General Principles</h3>

<ol>
  <li>
    <p><strong>No free lunch.</strong> K-Means is fast but makes strong assumptions. Spectral clustering is flexible but slow. Pick the right tool for your data.</p>
  </li>
  <li>
    <p><strong>Initialization matters.</strong> Always run K-Means multiple times or use smarter initialization (K-Means++ is worth learning).</p>
  </li>
  <li>
    <p><strong>The choice of $k$ is hard.</strong> There is no perfect method. The elbow method, silhouette scores, and domain knowledge all help.</p>
  </li>
  <li>
    <p><strong>Distance metrics matter.</strong> Euclidean is not always the right choice. Think about what “similar” means for your data.</p>
  </li>
</ol>

<hr />

<h2 id="appendix-complete-implementations">Appendix: Complete Implementations</h2>

<h3 id="k-means-implementation">K-Means Implementation</h3>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">numpy</span> <span class="k">as</span> <span class="n">np</span>

<span class="k">def</span> <span class="nf">assign_clusters</span><span class="p">(</span><span class="n">data</span><span class="p">,</span> <span class="n">centroids</span><span class="p">,</span> <span class="n">norm</span><span class="o">=</span><span class="mi">2</span><span class="p">):</span>
    <span class="n">distances</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">linalg</span><span class="p">.</span><span class="n">norm</span><span class="p">(</span><span class="n">data</span><span class="p">[:,</span> <span class="n">np</span><span class="p">.</span><span class="n">newaxis</span><span class="p">]</span> <span class="o">-</span> <span class="n">centroids</span><span class="p">,</span> <span class="n">axis</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span> <span class="nb">ord</span><span class="o">=</span><span class="n">norm</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">np</span><span class="p">.</span><span class="n">argmin</span><span class="p">(</span><span class="n">distances</span><span class="p">,</span> <span class="n">axis</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>

<span class="k">def</span> <span class="nf">update_centroids</span><span class="p">(</span><span class="n">data</span><span class="p">,</span> <span class="n">labels</span><span class="p">,</span> <span class="n">k</span><span class="p">):</span>
    <span class="n">n_features</span> <span class="o">=</span> <span class="n">data</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span>
    <span class="n">centroids</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">zeros</span><span class="p">((</span><span class="n">k</span><span class="p">,</span> <span class="n">n_features</span><span class="p">))</span>
    <span class="k">for</span> <span class="n">j</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">k</span><span class="p">):</span>
        <span class="n">cluster_points</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span><span class="n">labels</span> <span class="o">==</span> <span class="n">j</span><span class="p">]</span>
        <span class="k">if</span> <span class="nb">len</span><span class="p">(</span><span class="n">cluster_points</span><span class="p">)</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="p">:</span>
            <span class="n">centroids</span><span class="p">[</span><span class="n">j</span><span class="p">]</span> <span class="o">=</span> <span class="n">cluster_points</span><span class="p">.</span><span class="n">mean</span><span class="p">(</span><span class="n">axis</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span>
        <span class="k">else</span><span class="p">:</span>
            <span class="n">centroids</span><span class="p">[</span><span class="n">j</span><span class="p">]</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span><span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">randint</span><span class="p">(</span><span class="nb">len</span><span class="p">(</span><span class="n">data</span><span class="p">))]</span>
    <span class="k">return</span> <span class="n">centroids</span>

<span class="k">def</span> <span class="nf">has_converged</span><span class="p">(</span><span class="n">old_centroids</span><span class="p">,</span> <span class="n">new_centroids</span><span class="p">,</span> <span class="n">tolerance</span><span class="o">=</span><span class="mf">1e-4</span><span class="p">):</span>
    <span class="n">shift</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nb">sum</span><span class="p">((</span><span class="n">old_centroids</span> <span class="o">-</span> <span class="n">new_centroids</span><span class="p">)</span> <span class="o">**</span> <span class="mi">2</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">shift</span> <span class="o">&lt;</span> <span class="n">tolerance</span>

<span class="k">def</span> <span class="nf">kmeans</span><span class="p">(</span><span class="n">data</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">norm</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span> <span class="n">max_iters</span><span class="o">=</span><span class="mi">100</span><span class="p">,</span> <span class="n">tolerance</span><span class="o">=</span><span class="mf">1e-4</span><span class="p">,</span> <span class="n">seed</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
    <span class="k">if</span> <span class="n">seed</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
        <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">seed</span><span class="p">(</span><span class="n">seed</span><span class="p">)</span>
    <span class="n">n_samples</span> <span class="o">=</span> <span class="n">data</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
    <span class="n">random_indices</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">choice</span><span class="p">(</span><span class="n">n_samples</span><span class="p">,</span> <span class="n">size</span><span class="o">=</span><span class="n">k</span><span class="p">,</span> <span class="n">replace</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
    <span class="n">centroids</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span><span class="n">random_indices</span><span class="p">].</span><span class="n">copy</span><span class="p">()</span>
    <span class="k">for</span> <span class="n">iteration</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">max_iters</span><span class="p">):</span>
        <span class="n">labels</span> <span class="o">=</span> <span class="n">assign_clusters</span><span class="p">(</span><span class="n">data</span><span class="p">,</span> <span class="n">centroids</span><span class="p">,</span> <span class="n">norm</span><span class="p">)</span>
        <span class="n">new_centroids</span> <span class="o">=</span> <span class="n">update_centroids</span><span class="p">(</span><span class="n">data</span><span class="p">,</span> <span class="n">labels</span><span class="p">,</span> <span class="n">k</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">has_converged</span><span class="p">(</span><span class="n">centroids</span><span class="p">,</span> <span class="n">new_centroids</span><span class="p">,</span> <span class="n">tolerance</span><span class="p">):</span>
            <span class="k">return</span> <span class="n">labels</span><span class="p">,</span> <span class="n">new_centroids</span><span class="p">,</span> <span class="n">iteration</span> <span class="o">+</span> <span class="mi">1</span>
        <span class="n">centroids</span> <span class="o">=</span> <span class="n">new_centroids</span>
    <span class="k">return</span> <span class="n">labels</span><span class="p">,</span> <span class="n">centroids</span><span class="p">,</span> <span class="n">max_iters</span>

<span class="k">def</span> <span class="nf">kmeans_best_of_n</span><span class="p">(</span><span class="n">data</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">n_runs</span><span class="o">=</span><span class="mi">10</span><span class="p">,</span> <span class="o">**</span><span class="n">kwargs</span><span class="p">):</span>
    <span class="n">best_labels</span><span class="p">,</span> <span class="n">best_centroids</span><span class="p">,</span> <span class="n">best_wcss</span> <span class="o">=</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span><span class="p">,</span> <span class="nb">float</span><span class="p">(</span><span class="s">'inf'</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">run</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">n_runs</span><span class="p">):</span>
        <span class="n">labels</span><span class="p">,</span> <span class="n">centroids</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="n">kmeans</span><span class="p">(</span><span class="n">data</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">seed</span><span class="o">=</span><span class="n">run</span><span class="p">,</span> <span class="o">**</span><span class="n">kwargs</span><span class="p">)</span>
        <span class="n">wcss</span> <span class="o">=</span> <span class="nb">sum</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nb">sum</span><span class="p">((</span><span class="n">data</span><span class="p">[</span><span class="n">labels</span> <span class="o">==</span> <span class="n">j</span><span class="p">]</span> <span class="o">-</span> <span class="n">centroids</span><span class="p">[</span><span class="n">j</span><span class="p">])</span> <span class="o">**</span> <span class="mi">2</span><span class="p">)</span>
                   <span class="k">for</span> <span class="n">j</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">k</span><span class="p">)</span> <span class="k">if</span> <span class="nb">len</span><span class="p">(</span><span class="n">data</span><span class="p">[</span><span class="n">labels</span> <span class="o">==</span> <span class="n">j</span><span class="p">])</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">wcss</span> <span class="o">&lt;</span> <span class="n">best_wcss</span><span class="p">:</span>
            <span class="n">best_wcss</span><span class="p">,</span> <span class="n">best_labels</span><span class="p">,</span> <span class="n">best_centroids</span> <span class="o">=</span> <span class="n">wcss</span><span class="p">,</span> <span class="n">labels</span><span class="p">,</span> <span class="n">centroids</span>
    <span class="k">return</span> <span class="n">best_labels</span><span class="p">,</span> <span class="n">best_centroids</span><span class="p">,</span> <span class="n">best_wcss</span>
</code></pre></div></div>

<h3 id="spectral-clustering-implementation">Spectral Clustering Implementation</h3>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">numpy</span> <span class="k">as</span> <span class="n">np</span>

<span class="k">def</span> <span class="nf">compute_laplacian</span><span class="p">(</span><span class="n">adjacency_matrix</span><span class="p">):</span>
    <span class="n">degrees</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nb">sum</span><span class="p">(</span><span class="n">adjacency_matrix</span><span class="p">,</span> <span class="n">axis</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">np</span><span class="p">.</span><span class="n">diag</span><span class="p">(</span><span class="n">degrees</span><span class="p">)</span> <span class="o">-</span> <span class="n">adjacency_matrix</span>

<span class="k">def</span> <span class="nf">spectral_clustering</span><span class="p">(</span><span class="n">adjacency_matrix</span><span class="p">,</span> <span class="n">k</span><span class="p">):</span>
    <span class="n">laplacian</span> <span class="o">=</span> <span class="n">compute_laplacian</span><span class="p">(</span><span class="n">adjacency_matrix</span><span class="p">)</span>
    <span class="n">eigenvalues</span><span class="p">,</span> <span class="n">eigenvectors</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">linalg</span><span class="p">.</span><span class="n">eigh</span><span class="p">(</span><span class="n">laplacian</span><span class="p">)</span>
    <span class="n">embedding</span> <span class="o">=</span> <span class="n">eigenvectors</span><span class="p">[:,</span> <span class="p">:</span><span class="n">k</span><span class="p">]</span>
    <span class="n">row_norms</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">linalg</span><span class="p">.</span><span class="n">norm</span><span class="p">(</span><span class="n">embedding</span><span class="p">,</span> <span class="n">axis</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdims</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="n">row_norms</span><span class="p">[</span><span class="n">row_norms</span> <span class="o">==</span> <span class="mi">0</span><span class="p">]</span> <span class="o">=</span> <span class="mi">1</span>
    <span class="n">embedding_normalized</span> <span class="o">=</span> <span class="n">embedding</span> <span class="o">/</span> <span class="n">row_norms</span>
    <span class="n">labels</span><span class="p">,</span> <span class="n">_</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="n">kmeans</span><span class="p">(</span><span class="n">embedding_normalized</span><span class="p">,</span> <span class="n">k</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">labels</span>

<span class="k">def</span> <span class="nf">load_blog_network</span><span class="p">(</span><span class="n">nodes_path</span><span class="p">,</span> <span class="n">edges_path</span><span class="p">):</span>
    <span class="n">nodes</span><span class="p">,</span> <span class="n">labels</span> <span class="o">=</span> <span class="p">{},</span> <span class="p">[]</span>
    <span class="k">with</span> <span class="nb">open</span><span class="p">(</span><span class="n">nodes_path</span><span class="p">,</span> <span class="s">'r'</span><span class="p">)</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
        <span class="k">for</span> <span class="n">line</span> <span class="ow">in</span> <span class="n">f</span><span class="p">:</span>
            <span class="n">parts</span> <span class="o">=</span> <span class="n">line</span><span class="p">.</span><span class="n">strip</span><span class="p">().</span><span class="n">split</span><span class="p">(</span><span class="s">'</span><span class="se">\t</span><span class="s">'</span><span class="p">)</span>
            <span class="n">node_id</span><span class="p">,</span> <span class="n">label</span> <span class="o">=</span> <span class="nb">int</span><span class="p">(</span><span class="n">parts</span><span class="p">[</span><span class="mi">0</span><span class="p">]),</span> <span class="nb">int</span><span class="p">(</span><span class="n">parts</span><span class="p">[</span><span class="mi">2</span><span class="p">])</span>
            <span class="n">nodes</span><span class="p">[</span><span class="n">node_id</span><span class="p">]</span> <span class="o">=</span> <span class="nb">len</span><span class="p">(</span><span class="n">labels</span><span class="p">)</span>
            <span class="n">labels</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">label</span><span class="p">)</span>
    <span class="n">n</span> <span class="o">=</span> <span class="nb">len</span><span class="p">(</span><span class="n">labels</span><span class="p">)</span>
    <span class="n">adjacency</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">zeros</span><span class="p">((</span><span class="n">n</span><span class="p">,</span> <span class="n">n</span><span class="p">))</span>
    <span class="k">with</span> <span class="nb">open</span><span class="p">(</span><span class="n">edges_path</span><span class="p">,</span> <span class="s">'r'</span><span class="p">)</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
        <span class="k">for</span> <span class="n">line</span> <span class="ow">in</span> <span class="n">f</span><span class="p">:</span>
            <span class="n">parts</span> <span class="o">=</span> <span class="n">line</span><span class="p">.</span><span class="n">strip</span><span class="p">().</span><span class="n">split</span><span class="p">(</span><span class="s">'</span><span class="se">\t</span><span class="s">'</span><span class="p">)</span>
            <span class="n">n1</span><span class="p">,</span> <span class="n">n2</span> <span class="o">=</span> <span class="nb">int</span><span class="p">(</span><span class="n">parts</span><span class="p">[</span><span class="mi">0</span><span class="p">]),</span> <span class="nb">int</span><span class="p">(</span><span class="n">parts</span><span class="p">[</span><span class="mi">1</span><span class="p">])</span>
            <span class="k">if</span> <span class="n">n1</span> <span class="ow">in</span> <span class="n">nodes</span> <span class="ow">and</span> <span class="n">n2</span> <span class="ow">in</span> <span class="n">nodes</span><span class="p">:</span>
                <span class="n">i</span><span class="p">,</span> <span class="n">j</span> <span class="o">=</span> <span class="n">nodes</span><span class="p">[</span><span class="n">n1</span><span class="p">],</span> <span class="n">nodes</span><span class="p">[</span><span class="n">n2</span><span class="p">]</span>
                <span class="n">adjacency</span><span class="p">[</span><span class="n">i</span><span class="p">,</span> <span class="n">j</span><span class="p">]</span> <span class="o">=</span> <span class="n">adjacency</span><span class="p">[</span><span class="n">j</span><span class="p">,</span> <span class="n">i</span><span class="p">]</span> <span class="o">=</span> <span class="mi">1</span>
    <span class="k">return</span> <span class="n">adjacency</span><span class="p">,</span> <span class="n">np</span><span class="p">.</span><span class="n">array</span><span class="p">(</span><span class="n">labels</span><span class="p">)</span>
</code></pre></div></div>

<h3 id="image-compression">Image Compression</h3>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">import</span> <span class="nn">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>

<span class="k">def</span> <span class="nf">compress_image</span><span class="p">(</span><span class="n">image_path</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">norm</span><span class="o">=</span><span class="mi">2</span><span class="p">):</span>
    <span class="n">img</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="n">imread</span><span class="p">(</span><span class="n">image_path</span><span class="p">)</span>
    <span class="n">height</span><span class="p">,</span> <span class="n">width</span><span class="p">,</span> <span class="n">channels</span> <span class="o">=</span> <span class="n">img</span><span class="p">.</span><span class="n">shape</span>
    <span class="n">pixels</span> <span class="o">=</span> <span class="n">img</span><span class="p">.</span><span class="n">reshape</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="mi">3</span><span class="p">)</span>
    <span class="k">if</span> <span class="n">pixels</span><span class="p">.</span><span class="nb">max</span><span class="p">()</span> <span class="o">&gt;</span> <span class="mi">1</span><span class="p">:</span>
        <span class="n">pixels</span> <span class="o">=</span> <span class="n">pixels</span> <span class="o">/</span> <span class="mf">255.0</span>
    <span class="n">labels</span><span class="p">,</span> <span class="n">centroids</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="n">kmeans</span><span class="p">(</span><span class="n">pixels</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">norm</span><span class="o">=</span><span class="n">norm</span><span class="p">)</span>
    <span class="n">compressed</span> <span class="o">=</span> <span class="n">centroids</span><span class="p">[</span><span class="n">labels</span><span class="p">].</span><span class="n">reshape</span><span class="p">(</span><span class="n">height</span><span class="p">,</span> <span class="n">width</span><span class="p">,</span> <span class="n">channels</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">compressed</span><span class="p">,</span> <span class="n">centroids</span>

<span class="k">def</span> <span class="nf">save_compressed</span><span class="p">(</span><span class="n">image_path</span><span class="p">,</span> <span class="n">output_path</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">norm</span><span class="o">=</span><span class="mi">2</span><span class="p">):</span>
    <span class="n">compressed</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="n">compress_image</span><span class="p">(</span><span class="n">image_path</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">norm</span><span class="p">)</span>
    <span class="n">plt</span><span class="p">.</span><span class="n">imsave</span><span class="p">(</span><span class="n">output_path</span><span class="p">,</span> <span class="n">compressed</span><span class="p">)</span>
</code></pre></div></div>

<hr />

<p><em>PS: This work was completed at Georgia Tech. The original submission files can be provided upon request to validate that this work is entirely my own.</em></p>]]></content><author><name>Danny Tabach</name></author><category term="from-scratch" /><category term="clustering" /><category term="machine-learning" /><category term="python" /><category term="numpy" /><category term="spectral-clustering" /><summary type="html"><![CDATA[You have 10,000 data points. How do you find natural groupings without any labels?]]></summary></entry><entry><title type="html">Density Estimation and Mixture Models From Scratch</title><link href="https://danieltabach.github.io/from-scratch/density-estimation-from-scratch/" rel="alternate" type="text/html" title="Density Estimation and Mixture Models From Scratch" /><published>2025-01-17T00:00:00-05:00</published><updated>2025-01-17T00:00:00-05:00</updated><id>https://danieltabach.github.io/from-scratch/density-estimation-from-scratch</id><content type="html" xml:base="https://danieltabach.github.io/from-scratch/density-estimation-from-scratch/"><![CDATA[<p><em>How do you estimate the shape of data when you don’t know what distribution it came from?</em></p>

<hr />

<h2 id="introduction">Introduction</h2>

<p>Sometimes you have data but no idea what distribution generated it. Maybe it’s unimodal, maybe bimodal, maybe something weird. Histograms give you a rough picture, but they’re choppy and dependent on bin choices. What if you want a smooth, continuous estimate of the underlying density?</p>

<p>In this post, we build two approaches from scratch:</p>

<ol>
  <li><strong>Kernel Density Estimation (KDE)</strong>: Place a smooth “bump” (kernel) at each data point and sum them up</li>
  <li><strong>Gaussian Mixture Models (GMM)</strong>: Assume the data comes from multiple Gaussian distributions and learn their parameters</li>
</ol>

<p>We’ll also implement the <strong>Expectation-Maximization (EM) algorithm</strong>, the standard method for fitting GMMs when you don’t know which points belong to which component.</p>

<p>The applications: analyzing brain structure differences across political orientations (surprisingly interesting data), and classifying handwritten digits using GMM as a generative classifier.</p>

<p><strong>Just want the code?</strong> Skip to the <a href="#appendix-complete-implementations">Appendix</a> for copy-paste ready implementations.</p>

<hr />

<h2 id="part-1-histograms-vs-kde">Part 1: Histograms vs KDE</h2>

<h3 id="the-histogram-problem">The Histogram Problem</h3>

<p>Histograms are the most intuitive density estimate. Count how many points fall in each bin, normalize, done. But they have issues:</p>

<ol>
  <li><strong>Bin edges are arbitrary</strong>. Shift your bins slightly and the shape changes.</li>
  <li><strong>Not smooth</strong>. Histograms are step functions. Real densities are usually smooth.</li>
  <li><strong>Curse of dimensionality</strong>. In 2D you need bins squared, in 3D bins cubed. It gets sparse fast.</li>
</ol>

<h3 id="how-kde-works">How KDE Works</h3>

<p><strong>Plain English:</strong> Instead of counting points in bins, we place a smooth “bump” centered at each data point. The density estimate at any location is the sum of all these bumps.</p>

<p><strong>The formula:</strong></p>

\[\hat{f}(x) = \frac{1}{nh} \sum_{i=1}^{n} K\left(\frac{x - x_i}{h}\right)\]

<p>Where:</p>
<ul>
  <li>$n$ is the number of data points</li>
  <li>$h$ is the bandwidth (controls how wide each bump is)</li>
  <li>$K$ is the kernel function (usually Gaussian)</li>
  <li>$x_i$ are your data points</li>
</ul>

<p>The Gaussian kernel is:</p>

\[K(u) = \frac{1}{\sqrt{2\pi}} e^{-\frac{u^2}{2}}\]

<details>
<summary><strong>See it with a tiny example</strong></summary>
<p>Say we have 3 data points: x = [2, 3, 5] and bandwidth h = 1.</p>
<p>To estimate density at x = 3:</p>
<ul>
<li>Distance from point 1: (3-2)/1 = 1 → K(1) ≈ 0.24</li>
<li>Distance from point 2: (3-3)/1 = 0 → K(0) ≈ 0.40</li>
<li>Distance from point 3: (3-5)/1 = -2 → K(-2) ≈ 0.05</li>
</ul>
<p>Sum: (0.24 + 0.40 + 0.05) / (3 × 1) ≈ 0.23</p>
<p>The density is highest near the data points and smoothly decays away from them.</p>
</details>

<h3 id="implementation">Implementation</h3>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">from</span> <span class="nn">scipy.stats</span> <span class="kn">import</span> <span class="n">gaussian_kde</span>

<span class="k">def</span> <span class="nf">kde_1d</span><span class="p">(</span><span class="n">data</span><span class="p">,</span> <span class="n">bandwidth_factor</span><span class="o">=</span><span class="mf">1.0</span><span class="p">):</span>
    <span class="s">"""
    Compute 1D kernel density estimate.

    Parameters:
    - data: 1D array of observations
    - bandwidth_factor: multiplier for Scott's rule bandwidth

    Returns:
    - kde: scipy gaussian_kde object
    """</span>
    <span class="c1"># scipy's gaussian_kde uses Scott's rule by default
</span>    <span class="c1"># h = n^(-1/5) * std(data)
</span>    <span class="n">kde</span> <span class="o">=</span> <span class="n">gaussian_kde</span><span class="p">(</span><span class="n">data</span><span class="p">)</span>

    <span class="c1"># Adjust bandwidth if needed
</span>    <span class="c1"># bw_method scales the default bandwidth
</span>    <span class="n">kde</span> <span class="o">=</span> <span class="n">gaussian_kde</span><span class="p">(</span><span class="n">data</span><span class="p">,</span> <span class="n">bw_method</span><span class="o">=</span><span class="n">bandwidth_factor</span> <span class="o">*</span> <span class="n">kde</span><span class="p">.</span><span class="n">factor</span><span class="p">)</span>

    <span class="k">return</span> <span class="n">kde</span>

<span class="k">def</span> <span class="nf">kde_2d</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">y</span><span class="p">,</span> <span class="n">bandwidth_factor</span><span class="o">=</span><span class="mf">1.0</span><span class="p">):</span>
    <span class="s">"""
    Compute 2D kernel density estimate.

    Parameters:
    - x, y: 1D arrays of coordinates
    - bandwidth_factor: multiplier for default bandwidth

    Returns:
    - kde: scipy gaussian_kde object for 2D data
    """</span>
    <span class="c1"># Stack into 2D array where each column is a point
</span>    <span class="n">data</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">vstack</span><span class="p">([</span><span class="n">x</span><span class="p">,</span> <span class="n">y</span><span class="p">])</span>

    <span class="n">kde</span> <span class="o">=</span> <span class="n">gaussian_kde</span><span class="p">(</span><span class="n">data</span><span class="p">)</span>
    <span class="n">kde</span> <span class="o">=</span> <span class="n">gaussian_kde</span><span class="p">(</span><span class="n">data</span><span class="p">,</span> <span class="n">bw_method</span><span class="o">=</span><span class="n">bandwidth_factor</span> <span class="o">*</span> <span class="n">kde</span><span class="p">.</span><span class="n">factor</span><span class="p">)</span>

    <span class="k">return</span> <span class="n">kde</span>
</code></pre></div></div>

<p><strong>What happens if you change bandwidth?</strong> Too small, and you get a spiky estimate that overfits to individual points. Too large, and you oversmooth, missing real structure like multiple modes. Scott’s rule ($h = n^{-1/5} \cdot \sigma$) is a reasonable default, but you often need to tune it.</p>

<h3 id="choosing-bandwidth">Choosing Bandwidth</h3>

<p>There’s no perfect answer. Common approaches:</p>

<table>
  <thead>
    <tr>
      <th>Method</th>
      <th>Formula</th>
      <th>When to Use</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Scott’s Rule</td>
      <td>$h = n^{-1/5} \cdot \sigma$</td>
      <td>Default, assumes roughly Gaussian data</td>
    </tr>
    <tr>
      <td>Silverman’s Rule</td>
      <td>$h = 0.9 \cdot \min(\sigma, IQR/1.34) \cdot n^{-1/5}$</td>
      <td>More robust to outliers</td>
    </tr>
    <tr>
      <td>Cross-validation</td>
      <td>Minimize integrated squared error</td>
      <td>When you need optimal bandwidth</td>
    </tr>
  </tbody>
</table>

<p>In practice, I start with Scott’s rule and adjust by eye. If the KDE looks too smooth (missing obvious peaks), decrease the bandwidth. If it’s too spiky, increase it.</p>

<p><img src="/assets/images/posts/density-estimation/bandwidth-comparison.png" alt="Bandwidth comparison" />
<em>Left: Small bandwidth (h=0.3) shows spiky overfit. Middle: Scott’s rule bandwidth. Right: Large bandwidth (h=1.0) oversmooths and misses the second mode.</em></p>

<h3 id="histograms-vs-kde-trade-offs">Histograms vs KDE: Trade-offs</h3>

<table>
  <thead>
    <tr>
      <th>Aspect</th>
      <th>Histogram</th>
      <th>KDE</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Interpretability</td>
      <td>Easy (counts per bin)</td>
      <td>Harder (smooth density)</td>
    </tr>
    <tr>
      <td>Computation</td>
      <td>Fast</td>
      <td>Slower (scales with n)</td>
    </tr>
    <tr>
      <td>Smoothness</td>
      <td>Discontinuous</td>
      <td>Continuous</td>
    </tr>
    <tr>
      <td>Sampling</td>
      <td>Can’t easily generate new points</td>
      <td>Can sample from the density</td>
    </tr>
    <tr>
      <td>High dimensions</td>
      <td>Breaks down</td>
      <td>Also struggles, but degrades more gracefully</td>
    </tr>
  </tbody>
</table>

<p><strong>When to use histograms:</strong> Quick exploration, discrete data, when you need exact counts.</p>

<p><strong>When to use KDE:</strong> Estimating continuous densities, generating synthetic data, when smoothness matters.</p>

<hr />

<h2 id="part-2-gaussian-mixture-models">Part 2: Gaussian Mixture Models</h2>

<h3 id="the-problem-with-single-gaussians">The Problem with Single Gaussians</h3>

<p>Sometimes your data has multiple clusters or modes. A single Gaussian can’t capture this. If you fit one Gaussian to bimodal data, you get a mean in the middle where no data actually lives.</p>

<p><strong>Plain English:</strong> A GMM says “your data comes from K different Gaussian distributions, mixed together.” Each data point was generated by one of these Gaussians, but we don’t know which one.</p>

<h3 id="the-model">The Model</h3>

<p>A GMM with $K$ components has:</p>

\[p(x) = \sum_{k=1}^{K} \pi_k \cdot \mathcal{N}(x \mid \mu_k, \Sigma_k)\]

<p>Where:</p>
<ul>
  <li>$\pi_k$ is the <strong>mixing weight</strong> for component $k$. This is the probability that a randomly chosen point came from component $k$. All weights must sum to 1: $\sum_k \pi_k = 1$</li>
  <li>$\mu_k$ is the <strong>mean</strong> (center) of component $k$</li>
  <li>$\Sigma_k$ is the <strong>covariance matrix</strong> of component $k$, which controls the shape and orientation of the Gaussian</li>
  <li>$\mathcal{N}(x \mid \mu, \Sigma)$ is the <strong>multivariate Gaussian density function</strong>, which gives the probability density of observing $x$ given that it came from a Gaussian with mean $\mu$ and covariance $\Sigma$</li>
</ul>

<details>
<summary><strong>See it with a tiny example</strong></summary>
<p><strong>Setup:</strong> We have a GMM with K=2 components in 1D. Think of this as modeling data that comes from two different sources (like heights of men and women mixed together).</p>

<table>
<tr><th>Component</th><th>Weight π</th><th>Mean μ</th><th>Variance σ²</th><th>Interpretation</th></tr>
<tr><td>1</td><td>0.6</td><td>0</td><td>1</td><td>60% of data, centered at 0</td></tr>
<tr><td>2</td><td>0.4</td><td>5</td><td>2</td><td>40% of data, centered at 5</td></tr>
</table>

<p><strong>Question:</strong> What's the probability density at x = 2?</p>

<p><strong>Step 1: Compute each component's contribution.</strong></p>
<p>For each component, we compute: (mixing weight) × (Gaussian density at x)</p>

<p>Component 1 contribution:</p>
<ul>
<li>Gaussian density at x=2 with μ=0, σ²=1: N(2 | 0, 1) = (1/√(2π)) × e^(-(2-0)²/2) = 0.054</li>
<li>Weighted: π₁ × density = 0.6 × 0.054 = <strong>0.032</strong></li>
</ul>

<p>Component 2 contribution:</p>
<ul>
<li>Gaussian density at x=2 with μ=5, σ²=2: N(2 | 5, 2) = (1/√(4π)) × e^(-(2-5)²/4) = 0.030</li>
<li>Weighted: π₂ × density = 0.4 × 0.030 = <strong>0.012</strong></li>
</ul>

<p><strong>Step 2: Sum all contributions.</strong></p>
<p>Total density: p(x=2) = 0.032 + 0.012 = <strong>0.044</strong></p>

<p><strong>Interpretation:</strong> Even though x=2 is closer to component 1's mean (distance of 2) than component 2's mean (distance of 3), both components contribute to the density. Component 1 contributes more because it's both closer AND more common (weight 0.6 vs 0.4).</p>
</details>

<h3 id="why-mle-doesnt-work-directly">Why MLE Doesn’t Work Directly</h3>

<p>For a single Gaussian, maximum likelihood estimation is straightforward. You take derivatives, set to zero, and get the sample mean and covariance.</p>

<p>For GMMs, the likelihood is:</p>

\[L(\theta) = \prod_{i=1}^{n} \sum_{k=1}^{K} \pi_k \cdot \mathcal{N}(x_i \mid \mu_k, \Sigma_k)\]

<p>Taking the log:</p>

\[\log L(\theta) = \sum_{i=1}^{n} \log \left[ \sum_{k=1}^{K} \pi_k \cdot \mathcal{N}(x_i \mid \mu_k, \Sigma_k) \right]\]

<p>The problem: that <strong>log of a sum</strong> doesn’t simplify nicely. We can’t separate terms and solve for each parameter independently. The sum is inside the log.</p>

<p>The solution: <strong>Expectation-Maximization (EM)</strong>.</p>

<hr />

<h2 id="part-3-the-em-algorithm">Part 3: The EM Algorithm</h2>

<h3 id="the-core-idea">The Core Idea</h3>

<p>EM alternates between two steps:</p>

<ol>
  <li>
    <p><strong>E-step (Expectation):</strong> Given current parameters, compute the probability that each point belongs to each component. These are called “responsibilities.”</p>
  </li>
  <li>
    <p><strong>M-step (Maximization):</strong> Given responsibilities, update the parameters (means, covariances, weights) to maximize the expected log-likelihood.</p>
  </li>
</ol>

<p>Repeat until convergence.</p>

<h3 id="the-responsibility-formula">The Responsibility Formula</h3>

<p>Using Bayes’ rule, the responsibility $\tau_k^i$ (probability that point $i$ belongs to component $k$) is:</p>

\[\tau_k^i = \frac{\pi_k \cdot \mathcal{N}(x_i \mid \mu_k, \Sigma_k)}{\sum_{j=1}^{K} \pi_j \cdot \mathcal{N}(x_i \mid \mu_j, \Sigma_j)}\]

<p>Let’s break this formula down piece by piece:</p>

<p><strong>The numerator</strong> $\pi_k \cdot \mathcal{N}(x_i \mid \mu_k, \Sigma_k)$ asks: “What’s the probability that this point came from component $k$?”</p>

<ul>
  <li>$\pi_k$ is how common component $k$ is overall (its mixing weight)</li>
  <li>$\mathcal{N}(x_i \mid \mu_k, \Sigma_k)$ is how well point $x_i$ fits component $k$’s Gaussian distribution</li>
  <li>Multiplying them gives: “probability of picking component $k$” × “probability of seeing this point given component $k$”</li>
</ul>

<p><strong>The denominator</strong> $\sum_{j=1}^{K} \pi_j \cdot \mathcal{N}(x_i \mid \mu_j, \Sigma_j)$ is the total probability of observing $x_i$ under the entire mixture model. We sum over all $K$ components.</p>

<p><strong>The ratio</strong> normalizes everything so that the responsibilities for point $i$ sum to 1 across all components: $\sum_{k=1}^{K} \tau_k^i = 1$.</p>

<p>This is just Bayes’ rule. We’re computing: $P(\text{component } k \mid \text{point } x_i)$.</p>

<details>
<summary><strong>See it with a tiny example</strong></summary>
<p><strong>Setup:</strong> We have a 2-component GMM with these parameters:</p>
<table>
<tr><th>Component</th><th>Weight π</th><th>Mean μ</th><th>Variance σ²</th></tr>
<tr><td>1</td><td>0.6</td><td>0</td><td>1</td></tr>
<tr><td>2</td><td>0.4</td><td>5</td><td>2</td></tr>
</table>
<p><strong>Where do these numbers come from?</strong> We set them up for this example. Component 1 is centered at 0 and accounts for 60% of the data (π₁ = 0.6). Component 2 is centered at 5 and accounts for 40% (π₂ = 0.4).</p>

<p><strong>Question:</strong> For a new point x = 2, what's the probability it came from each component?</p>

<p><strong>Step 1: Compute the Gaussian density for each component.</strong></p>
<p>The 1D Gaussian formula is: N(x | μ, σ²) = (1/√(2πσ²)) × exp(-(x-μ)²/(2σ²))</p>

<p>For component 1 (μ₁ = 0, σ₁² = 1):</p>
<ul>
<li>Distance from mean: (x - μ₁)² = (2 - 0)² = 4</li>
<li>Exponent: -4 / (2 × 1) = -2</li>
<li>Density: (1/√(2π)) × e⁻² = 0.399 × 0.135 = 0.054</li>
</ul>

<p>For component 2 (μ₂ = 5, σ₂² = 2):</p>
<ul>
<li>Distance from mean: (x - μ₂)² = (2 - 5)² = 9</li>
<li>Exponent: -9 / (2 × 2) = -2.25</li>
<li>Density: (1/√(4π)) × e⁻²·²⁵ = 0.282 × 0.105 = 0.030</li>
</ul>

<p><strong>Step 2: Multiply each density by its mixing weight.</strong></p>
<ul>
<li>Component 1: π₁ × N(2|0,1) = 0.6 × 0.054 = 0.032</li>
<li>Component 2: π₂ × N(2|5,2) = 0.4 × 0.030 = 0.012</li>
</ul>

<p><strong>Step 3: Compute the denominator (sum over all components).</strong></p>
<p>Total = 0.032 + 0.012 = 0.044</p>

<p><strong>Step 4: Divide to get responsibilities.</strong></p>
<table>
<tr><th>Component</th><th>Numerator (π × N)</th><th>Responsibility τ</th></tr>
<tr><td>1</td><td>0.032</td><td>0.032 / 0.044 = <strong>0.73</strong></td></tr>
<tr><td>2</td><td>0.012</td><td>0.012 / 0.044 = <strong>0.27</strong></td></tr>
</table>

<p><strong>Interpretation:</strong> Point x = 2 has 73% responsibility to component 1 and 27% to component 2. This makes sense: x = 2 is closer to component 1's mean (0) than to component 2's mean (5), and component 1 is more common overall (60% vs 40%).</p>

<p>Notice the responsibilities sum to 1: 0.73 + 0.27 = 1.0 ✓</p>
</details>

<h3 id="the-m-step-updates">The M-Step Updates</h3>

<p>Given responsibilities from the E-step, we now update all parameters. The key insight: these are just weighted versions of the formulas you already know for mean and variance, where each point is weighted by how much it “belongs” to that component.</p>

<p><strong>Step 1: Effective count for component $k$</strong></p>

\[N_k = \sum_{i=1}^{n} \tau_k^i\]

<p>This sums all responsibilities for component $k$ across all $n$ data points. If we have 100 points and component 1 has average responsibility 0.6 per point, then $N_1 \approx 60$. This tells us “how many points effectively belong to this component.”</p>

<p><strong>Step 2: Updated mixing weights</strong></p>

\[\pi_k = \frac{N_k}{n}\]

<p>The new weight for component $k$ is simply what fraction of the data (in terms of responsibility) belongs to it. If $N_k = 60$ out of $n = 100$ points, then $\pi_k = 0.6$.</p>

<p><strong>Step 3: Updated means</strong></p>

\[\mu_k = \frac{1}{N_k} \sum_{i=1}^{n} \tau_k^i \cdot x_i\]

<p>This is a weighted average of all data points, where the weight for point $i$ is its responsibility $\tau_k^i$. Points that strongly belong to component $k$ (high $\tau_k^i$) pull the mean toward them. Points that barely belong (low $\tau_k^i$) have little influence.</p>

<p><strong>Step 4: Updated covariances</strong></p>

\[\Sigma_k = \frac{1}{N_k} \sum_{i=1}^{n} \tau_k^i (x_i - \mu_k)(x_i - \mu_k)^T\]

<p>Same idea: weighted average of squared deviations from the mean. The $(x_i - \mu_k)(x_i - \mu_k)^T$ term computes the outer product (giving a matrix), and we weight each by responsibility.</p>

<details>
<summary><strong>See it with a tiny example</strong></summary>
<p><strong>Setup:</strong> We have 4 data points in 1D and K=2 components. After running the E-step, here are the responsibilities:</p>

<table>
<tr><th>Point xᵢ</th><th>Value</th><th>τ₁ (component 1)</th><th>τ₂ (component 2)</th></tr>
<tr><td>1</td><td>1.0</td><td>0.9</td><td>0.1</td></tr>
<tr><td>2</td><td>2.0</td><td>0.8</td><td>0.2</td></tr>
<tr><td>3</td><td>8.0</td><td>0.2</td><td>0.8</td></tr>
<tr><td>4</td><td>9.0</td><td>0.1</td><td>0.9</td></tr>
</table>

<p><strong>Step 1: Compute effective counts.</strong></p>
<ul>
<li>N₁ = 0.9 + 0.8 + 0.2 + 0.1 = 2.0</li>
<li>N₂ = 0.1 + 0.2 + 0.8 + 0.9 = 2.0</li>
</ul>

<p><strong>Step 2: Update weights.</strong></p>
<ul>
<li>π₁ = 2.0 / 4 = 0.5</li>
<li>π₂ = 2.0 / 4 = 0.5</li>
</ul>

<p><strong>Step 3: Update means.</strong></p>
<ul>
<li>μ₁ = (1/2.0) × (0.9×1 + 0.8×2 + 0.2×8 + 0.1×9) = 4.9/2.0 = 2.45</li>
<li>μ₂ = (1/2.0) × (0.1×1 + 0.2×2 + 0.8×8 + 0.9×9) = 15.0/2.0 = 7.50</li>
</ul>

<p><strong>Interpretation:</strong> Component 1's mean (2.45) is pulled toward points 1 and 2 (which have high responsibility to it). Component 2's mean (7.50) is pulled toward points 3 and 4.</p>
</details>

<h3 id="implementation-1">Implementation</h3>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">from</span> <span class="nn">scipy.stats</span> <span class="kn">import</span> <span class="n">multivariate_normal</span>

<span class="k">def</span> <span class="nf">em_gmm</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">K</span><span class="p">,</span> <span class="n">max_iters</span><span class="o">=</span><span class="mi">100</span><span class="p">,</span> <span class="n">tol</span><span class="o">=</span><span class="mf">1e-6</span><span class="p">,</span> <span class="n">seed</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
    <span class="s">"""
    Fit a Gaussian Mixture Model using EM algorithm.

    Parameters:
    - X: data matrix (n_samples, n_features)
    - K: number of components
    - max_iters: maximum iterations
    - tol: convergence tolerance for log-likelihood
    - seed: random seed for initialization

    Returns:
    - pi: mixing weights (K,)
    - mu: means (K, n_features)
    - Sigma: covariances (K, n_features, n_features)
    - responsibilities: final responsibilities (n_samples, K)
    - log_likelihoods: history of log-likelihood values
    """</span>
    <span class="k">if</span> <span class="n">seed</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
        <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">seed</span><span class="p">(</span><span class="n">seed</span><span class="p">)</span>

    <span class="n">n_samples</span><span class="p">,</span> <span class="n">n_features</span> <span class="o">=</span> <span class="n">X</span><span class="p">.</span><span class="n">shape</span>

    <span class="c1"># Initialize parameters
</span>    <span class="c1"># Means: random Gaussian
</span>    <span class="n">mu</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">randn</span><span class="p">(</span><span class="n">K</span><span class="p">,</span> <span class="n">n_features</span><span class="p">)</span>

    <span class="c1"># Covariances: random positive definite matrices
</span>    <span class="c1"># Sigma = S @ S.T + I ensures positive definiteness
</span>    <span class="n">Sigma</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">K</span><span class="p">):</span>
        <span class="n">S</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">randn</span><span class="p">(</span><span class="n">n_features</span><span class="p">,</span> <span class="n">n_features</span><span class="p">)</span>
        <span class="n">Sigma</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">S</span> <span class="o">@</span> <span class="n">S</span><span class="p">.</span><span class="n">T</span> <span class="o">+</span> <span class="n">np</span><span class="p">.</span><span class="n">eye</span><span class="p">(</span><span class="n">n_features</span><span class="p">))</span>

    <span class="c1"># Weights: uniform
</span>    <span class="n">pi</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">ones</span><span class="p">(</span><span class="n">K</span><span class="p">)</span> <span class="o">/</span> <span class="n">K</span>

    <span class="n">log_likelihoods</span> <span class="o">=</span> <span class="p">[]</span>

    <span class="k">for</span> <span class="n">iteration</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">max_iters</span><span class="p">):</span>
        <span class="c1"># E-Step: Compute responsibilities
</span>        <span class="c1"># gamma[i, k] = P(point i belongs to component k)
</span>        <span class="n">gamma</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">zeros</span><span class="p">((</span><span class="n">n_samples</span><span class="p">,</span> <span class="n">K</span><span class="p">))</span>

        <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">K</span><span class="p">):</span>
            <span class="c1"># Numerator: pi_k * N(x | mu_k, Sigma_k)
</span>            <span class="n">gamma</span><span class="p">[:,</span> <span class="n">k</span><span class="p">]</span> <span class="o">=</span> <span class="n">pi</span><span class="p">[</span><span class="n">k</span><span class="p">]</span> <span class="o">*</span> <span class="n">multivariate_normal</span><span class="p">.</span><span class="n">pdf</span><span class="p">(</span>
                <span class="n">X</span><span class="p">,</span> <span class="n">mean</span><span class="o">=</span><span class="n">mu</span><span class="p">[</span><span class="n">k</span><span class="p">],</span> <span class="n">cov</span><span class="o">=</span><span class="n">Sigma</span><span class="p">[</span><span class="n">k</span><span class="p">]</span>
            <span class="p">)</span>

        <span class="c1"># Normalize: divide by sum across components
</span>        <span class="n">gamma</span> <span class="o">/=</span> <span class="n">gamma</span><span class="p">.</span><span class="nb">sum</span><span class="p">(</span><span class="n">axis</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdims</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>

        <span class="c1"># M-Step: Update parameters
</span>        <span class="c1"># Effective count per component
</span>        <span class="n">Nk</span> <span class="o">=</span> <span class="n">gamma</span><span class="p">.</span><span class="nb">sum</span><span class="p">(</span><span class="n">axis</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span>

        <span class="c1"># Update weights
</span>        <span class="n">pi</span> <span class="o">=</span> <span class="n">Nk</span> <span class="o">/</span> <span class="n">n_samples</span>

        <span class="c1"># Update means and covariances
</span>        <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">K</span><span class="p">):</span>
            <span class="c1"># Weighted mean
</span>            <span class="n">mu</span><span class="p">[</span><span class="n">k</span><span class="p">]</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">dot</span><span class="p">(</span><span class="n">gamma</span><span class="p">[:,</span> <span class="n">k</span><span class="p">],</span> <span class="n">X</span><span class="p">)</span> <span class="o">/</span> <span class="n">Nk</span><span class="p">[</span><span class="n">k</span><span class="p">]</span>

            <span class="c1"># Weighted covariance
</span>            <span class="n">centered</span> <span class="o">=</span> <span class="n">X</span> <span class="o">-</span> <span class="n">mu</span><span class="p">[</span><span class="n">k</span><span class="p">]</span>
            <span class="n">Sigma</span><span class="p">[</span><span class="n">k</span><span class="p">]</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">dot</span><span class="p">((</span><span class="n">gamma</span><span class="p">[:,</span> <span class="n">k</span><span class="p">,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">*</span> <span class="n">centered</span><span class="p">).</span><span class="n">T</span><span class="p">,</span> <span class="n">centered</span><span class="p">)</span> <span class="o">/</span> <span class="n">Nk</span><span class="p">[</span><span class="n">k</span><span class="p">]</span>

        <span class="c1"># Compute log-likelihood
</span>        <span class="n">ll</span> <span class="o">=</span> <span class="mi">0</span>
        <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">n_samples</span><span class="p">):</span>
            <span class="n">point_likelihood</span> <span class="o">=</span> <span class="nb">sum</span><span class="p">(</span>
                <span class="n">pi</span><span class="p">[</span><span class="n">k</span><span class="p">]</span> <span class="o">*</span> <span class="n">multivariate_normal</span><span class="p">.</span><span class="n">pdf</span><span class="p">(</span><span class="n">X</span><span class="p">[</span><span class="n">i</span><span class="p">],</span> <span class="n">mean</span><span class="o">=</span><span class="n">mu</span><span class="p">[</span><span class="n">k</span><span class="p">],</span> <span class="n">cov</span><span class="o">=</span><span class="n">Sigma</span><span class="p">[</span><span class="n">k</span><span class="p">])</span>
                <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">K</span><span class="p">)</span>
            <span class="p">)</span>
            <span class="n">ll</span> <span class="o">+=</span> <span class="n">np</span><span class="p">.</span><span class="n">log</span><span class="p">(</span><span class="n">point_likelihood</span><span class="p">)</span>

        <span class="n">log_likelihoods</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">ll</span><span class="p">)</span>

        <span class="c1"># Check convergence
</span>        <span class="k">if</span> <span class="n">iteration</span> <span class="o">&gt;</span> <span class="mi">0</span> <span class="ow">and</span> <span class="nb">abs</span><span class="p">(</span><span class="n">log_likelihoods</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span> <span class="o">-</span> <span class="n">log_likelihoods</span><span class="p">[</span><span class="o">-</span><span class="mi">2</span><span class="p">])</span> <span class="o">&lt;</span> <span class="n">tol</span><span class="p">:</span>
            <span class="k">break</span>

    <span class="k">return</span> <span class="n">pi</span><span class="p">,</span> <span class="n">mu</span><span class="p">,</span> <span class="n">Sigma</span><span class="p">,</span> <span class="n">gamma</span><span class="p">,</span> <span class="n">log_likelihoods</span>
</code></pre></div></div>

<p><strong>What happens if you change K?</strong> Too few components and you underfit, missing real structure. Too many and you overfit, potentially assigning separate components to noise. Use BIC or AIC for model selection (lower is better):</p>

<p>\(BIC = -2 \log L + p \log n\)
\(AIC = -2 \log L + 2p\)</p>

<p>Where $p$ is the number of parameters. BIC penalizes complexity more heavily.</p>

<h3 id="handling-edge-cases">Handling Edge Cases</h3>

<p><strong>Singular covariance matrices:</strong> If a component collapses to a single point, the covariance becomes singular. Add a small regularization term: $\Sigma_k + \epsilon I$ where $\epsilon \approx 10^{-6}$.</p>

<p><strong>Empty components:</strong> If a component gets zero responsibility, reinitialize it randomly or remove it.</p>

<p><strong>Local minima:</strong> EM finds local optima. Run multiple times with different initializations and keep the best (highest log-likelihood).</p>

<hr />

<h2 id="application-brain-structure-and-political-views">Application: Brain Structure and Political Views</h2>

<h3 id="the-dataset">The Dataset</h3>

<p>We have data on 90 subjects with three variables:</p>
<ul>
  <li><strong>amygdala</strong>: volume of the amygdala (brain region associated with emotion)</li>
  <li><strong>acc</strong>: volume of the anterior cingulate cortex (associated with decision-making)</li>
  <li><strong>orientation</strong>: political orientation on a scale from 2 (conservative) to 5 (liberal)</li>
</ul>

<p>The scientific question: Is there a relationship between brain structure and political orientation?</p>

<h3 id="1d-analysis">1D Analysis</h3>

<p>First, let’s look at each variable separately using histograms and KDE:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">pandas</span> <span class="k">as</span> <span class="n">pd</span>
<span class="kn">import</span> <span class="nn">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>
<span class="kn">import</span> <span class="nn">seaborn</span> <span class="k">as</span> <span class="n">sns</span>

<span class="c1"># Load data
</span><span class="n">data</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">read_csv</span><span class="p">(</span><span class="s">'n90pol.csv'</span><span class="p">)</span>

<span class="c1"># Compute number of bins using Sturges' rule
</span><span class="n">n</span> <span class="o">=</span> <span class="nb">len</span><span class="p">(</span><span class="n">data</span><span class="p">)</span>
<span class="n">n_bins</span> <span class="o">=</span> <span class="nb">int</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="n">floor</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="n">log2</span><span class="p">(</span><span class="n">n</span><span class="p">)</span> <span class="o">+</span> <span class="mi">1</span><span class="p">))</span>

<span class="c1"># Plot histograms
</span><span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="n">subplots</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">12</span><span class="p">,</span> <span class="mi">5</span><span class="p">))</span>

<span class="n">sns</span><span class="p">.</span><span class="n">histplot</span><span class="p">(</span><span class="n">data</span><span class="p">[</span><span class="s">'amygdala'</span><span class="p">],</span> <span class="n">bins</span><span class="o">=</span><span class="n">n_bins</span><span class="p">,</span> <span class="n">ax</span><span class="o">=</span><span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">])</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="n">set_title</span><span class="p">(</span><span class="s">'Histogram of Amygdala Volume'</span><span class="p">)</span>

<span class="n">sns</span><span class="p">.</span><span class="n">histplot</span><span class="p">(</span><span class="n">data</span><span class="p">[</span><span class="s">'acc'</span><span class="p">],</span> <span class="n">bins</span><span class="o">=</span><span class="n">n_bins</span><span class="p">,</span> <span class="n">ax</span><span class="o">=</span><span class="n">axes</span><span class="p">[</span><span class="mi">1</span><span class="p">])</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">1</span><span class="p">].</span><span class="n">set_title</span><span class="p">(</span><span class="s">'Histogram of ACC Volume'</span><span class="p">)</span>

<span class="n">plt</span><span class="p">.</span><span class="n">show</span><span class="p">()</span>

<span class="c1"># Plot KDE
</span><span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="n">subplots</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">12</span><span class="p">,</span> <span class="mi">5</span><span class="p">))</span>

<span class="n">sns</span><span class="p">.</span><span class="n">kdeplot</span><span class="p">(</span><span class="n">data</span><span class="p">[</span><span class="s">'amygdala'</span><span class="p">],</span> <span class="n">bw_adjust</span><span class="o">=</span><span class="mf">0.5</span><span class="p">,</span> <span class="n">ax</span><span class="o">=</span><span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">])</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="n">set_title</span><span class="p">(</span><span class="s">'KDE of Amygdala Volume'</span><span class="p">)</span>

<span class="n">sns</span><span class="p">.</span><span class="n">kdeplot</span><span class="p">(</span><span class="n">data</span><span class="p">[</span><span class="s">'acc'</span><span class="p">],</span> <span class="n">bw_adjust</span><span class="o">=</span><span class="mf">0.5</span><span class="p">,</span> <span class="n">ax</span><span class="o">=</span><span class="n">axes</span><span class="p">[</span><span class="mi">1</span><span class="p">])</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">1</span><span class="p">].</span><span class="n">set_title</span><span class="p">(</span><span class="s">'KDE of ACC Volume'</span><span class="p">)</span>

<span class="n">plt</span><span class="p">.</span><span class="n">show</span><span class="p">()</span>
</code></pre></div></div>

<p>The KDE reveals potential multimodality in the amygdala distribution that the histogram hints at but doesn’t show clearly.</p>

<p><img src="/assets/images/posts/density-estimation/amygdala-acc-1d.png" alt="1D Histogram and KDE" />
<em>Top row: Histograms using Sturges’ rule for bin count. Bottom row: KDE with bandwidth factor 0.5. The KDE reveals a potential secondary mode in the amygdala distribution.</em></p>

<h3 id="2d-analysis">2D Analysis</h3>

<p>Looking at both variables together:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="nn">scipy.stats</span> <span class="kn">import</span> <span class="n">gaussian_kde</span>

<span class="n">X</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span><span class="s">'amygdala'</span><span class="p">].</span><span class="n">values</span>
<span class="n">Y</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span><span class="s">'acc'</span><span class="p">].</span><span class="n">values</span>

<span class="c1"># Compute 2D KDE
</span><span class="n">kde</span> <span class="o">=</span> <span class="n">gaussian_kde</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="n">vstack</span><span class="p">([</span><span class="n">X</span><span class="p">,</span> <span class="n">Y</span><span class="p">]),</span> <span class="n">bw_method</span><span class="o">=</span><span class="mf">0.3</span><span class="p">)</span>

<span class="c1"># Create grid for evaluation
</span><span class="n">x_grid</span><span class="p">,</span> <span class="n">y_grid</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">mgrid</span><span class="p">[</span><span class="n">X</span><span class="p">.</span><span class="nb">min</span><span class="p">():</span><span class="n">X</span><span class="p">.</span><span class="nb">max</span><span class="p">():</span><span class="mf">100j</span><span class="p">,</span> <span class="n">Y</span><span class="p">.</span><span class="nb">min</span><span class="p">():</span><span class="n">Y</span><span class="p">.</span><span class="nb">max</span><span class="p">():</span><span class="mf">100j</span><span class="p">]</span>
<span class="n">positions</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">vstack</span><span class="p">([</span><span class="n">x_grid</span><span class="p">.</span><span class="n">ravel</span><span class="p">(),</span> <span class="n">y_grid</span><span class="p">.</span><span class="n">ravel</span><span class="p">()])</span>
<span class="n">z</span> <span class="o">=</span> <span class="n">kde</span><span class="p">(</span><span class="n">positions</span><span class="p">).</span><span class="n">reshape</span><span class="p">(</span><span class="n">x_grid</span><span class="p">.</span><span class="n">shape</span><span class="p">)</span>

<span class="c1"># Plot
</span><span class="n">plt</span><span class="p">.</span><span class="n">figure</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">8</span><span class="p">,</span> <span class="mi">6</span><span class="p">))</span>
<span class="n">plt</span><span class="p">.</span><span class="n">contourf</span><span class="p">(</span><span class="n">x_grid</span><span class="p">,</span> <span class="n">y_grid</span><span class="p">,</span> <span class="n">z</span><span class="p">,</span> <span class="n">levels</span><span class="o">=</span><span class="mi">20</span><span class="p">,</span> <span class="n">cmap</span><span class="o">=</span><span class="s">'plasma'</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">colorbar</span><span class="p">(</span><span class="n">label</span><span class="o">=</span><span class="s">'Density'</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">xlabel</span><span class="p">(</span><span class="s">'Amygdala Volume'</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">ylabel</span><span class="p">(</span><span class="s">'ACC Volume'</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">title</span><span class="p">(</span><span class="s">'2D KDE of Brain Structure'</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">show</span><span class="p">()</span>
</code></pre></div></div>

<p><img src="/assets/images/posts/density-estimation/brain-2d-kde.png" alt="2D KDE Contour" />
<em>2D KDE of amygdala vs ACC volume. The contours suggest a primary mode with possible secondary structure. Red ellipses mark potential modes; green ellipses mark outliers.</em></p>

<p><img src="/assets/images/posts/density-estimation/brain-3d-kde.png" alt="3D KDE Surface" />
<em>3D surface plot of the same density. The peaks and valleys are easier to see in this view.</em></p>

<h3 id="testing-for-independence">Testing for Independence</h3>

<p>Are amygdala and acc volumes independent?</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="nn">scipy.stats</span> <span class="kn">import</span> <span class="n">pearsonr</span>

<span class="n">corr</span><span class="p">,</span> <span class="n">p_value</span> <span class="o">=</span> <span class="n">pearsonr</span><span class="p">(</span><span class="n">data</span><span class="p">[</span><span class="s">'amygdala'</span><span class="p">],</span> <span class="n">data</span><span class="p">[</span><span class="s">'acc'</span><span class="p">])</span>
<span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">'Pearson correlation: </span><span class="si">{</span><span class="n">corr</span><span class="si">:</span><span class="p">.</span><span class="mi">3</span><span class="n">f</span><span class="si">}</span><span class="s">'</span><span class="p">)</span>
<span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">'p-value: </span><span class="si">{</span><span class="n">p_value</span><span class="si">:</span><span class="p">.</span><span class="mi">3</span><span class="n">f</span><span class="si">}</span><span class="s">'</span><span class="p">)</span>
</code></pre></div></div>

<p>Results:</p>
<ul>
  <li>Correlation: -0.13</li>
  <li>p-value: 0.23</li>
</ul>

<p>The correlation is weak and not statistically significant. We can’t reject the null hypothesis that the variables are independent.</p>

<h3 id="conditional-distributions-by-political-orientation">Conditional Distributions by Political Orientation</h3>

<p>The more interesting question: do the distributions differ by political orientation?</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># Plot conditional KDEs for each orientation
</span><span class="n">orientations</span> <span class="o">=</span> <span class="p">[</span><span class="mi">2</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">4</span><span class="p">,</span> <span class="mi">5</span><span class="p">]</span>

<span class="n">plt</span><span class="p">.</span><span class="n">figure</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">12</span><span class="p">,</span> <span class="mi">6</span><span class="p">))</span>
<span class="k">for</span> <span class="n">c</span> <span class="ow">in</span> <span class="n">orientations</span><span class="p">:</span>
    <span class="n">subset</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span><span class="n">data</span><span class="p">[</span><span class="s">'orientation'</span><span class="p">]</span> <span class="o">==</span> <span class="n">c</span><span class="p">][</span><span class="s">'amygdala'</span><span class="p">]</span>
    <span class="n">sns</span><span class="p">.</span><span class="n">kdeplot</span><span class="p">(</span><span class="n">subset</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="sa">f</span><span class="s">'Orientation </span><span class="si">{</span><span class="n">c</span><span class="si">}</span><span class="s">'</span><span class="p">,</span> <span class="n">bw_adjust</span><span class="o">=</span><span class="mf">0.6</span><span class="p">)</span>

<span class="n">plt</span><span class="p">.</span><span class="n">xlabel</span><span class="p">(</span><span class="s">'Amygdala Volume'</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">ylabel</span><span class="p">(</span><span class="s">'Density'</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">title</span><span class="p">(</span><span class="s">'Amygdala Volume by Political Orientation'</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">legend</span><span class="p">()</span>
<span class="n">plt</span><span class="p">.</span><span class="n">show</span><span class="p">()</span>
</code></pre></div></div>

<p><img src="/assets/images/posts/density-estimation/conditional-kde-orientation.png" alt="Conditional KDE by Orientation" />
<em>KDE of amygdala volume conditioned on political orientation. Orientation 2 (conservative) shows a distinct rightward shift compared to 4 and 5 (liberal).</em></p>

<table>
  <thead>
    <tr>
      <th>Orientation</th>
      <th>Amygdala Mean</th>
      <th>ACC Mean</th>
      <th>Observations</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>2 (Conservative)</td>
      <td>0.019</td>
      <td>-0.015</td>
      <td>Larger amygdala, smaller ACC</td>
    </tr>
    <tr>
      <td>3 (Lean Conservative)</td>
      <td>0.001</td>
      <td>0.002</td>
      <td>Near average</td>
    </tr>
    <tr>
      <td>4 (Lean Liberal)</td>
      <td>-0.005</td>
      <td>0.001</td>
      <td>Smaller amygdala</td>
    </tr>
    <tr>
      <td>5 (Liberal)</td>
      <td>-0.006</td>
      <td>0.008</td>
      <td>Smaller amygdala, larger ACC</td>
    </tr>
  </tbody>
</table>

<p>The conditional 2D KDE plots show distinct patterns:</p>
<ul>
  <li><strong>Orientation 3</strong> (neutral) has the widest spread in both dimensions</li>
  <li><strong>Orientation 2</strong> and <strong>4</strong> (leaning groups) show similar outlier patterns</li>
  <li><strong>Orientation 5</strong> (most liberal) has the narrowest distribution</li>
</ul>

<p><img src="/assets/images/posts/density-estimation/joint-kde-by-orientation.png" alt="Joint KDE by Orientation" />
<em>2D KDE of (amygdala, acc) for each political orientation. Orientation 3 (neutral) shows the widest spread, while more partisan orientations have tighter clusters.</em></p>

<h3 id="model-selection-how-many-components">Model Selection: How Many Components?</h3>

<p>Using sklearn’s GaussianMixture to test whether the joint distribution is unimodal or multimodal:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="nn">sklearn.mixture</span> <span class="kn">import</span> <span class="n">GaussianMixture</span>

<span class="n">X_joint</span> <span class="o">=</span> <span class="n">data</span><span class="p">[[</span><span class="s">'amygdala'</span><span class="p">,</span> <span class="s">'acc'</span><span class="p">]].</span><span class="n">values</span>

<span class="c1"># Test different numbers of components
</span><span class="n">n_components_range</span> <span class="o">=</span> <span class="nb">range</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">7</span><span class="p">)</span>
<span class="n">bics</span> <span class="o">=</span> <span class="p">[]</span>
<span class="n">aics</span> <span class="o">=</span> <span class="p">[]</span>

<span class="k">for</span> <span class="n">n</span> <span class="ow">in</span> <span class="n">n_components_range</span><span class="p">:</span>
    <span class="n">gmm</span> <span class="o">=</span> <span class="n">GaussianMixture</span><span class="p">(</span><span class="n">n_components</span><span class="o">=</span><span class="n">n</span><span class="p">,</span> <span class="n">random_state</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span>
    <span class="n">gmm</span><span class="p">.</span><span class="n">fit</span><span class="p">(</span><span class="n">X_joint</span><span class="p">)</span>
    <span class="n">bics</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">gmm</span><span class="p">.</span><span class="n">bic</span><span class="p">(</span><span class="n">X_joint</span><span class="p">))</span>
    <span class="n">aics</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">gmm</span><span class="p">.</span><span class="n">aic</span><span class="p">(</span><span class="n">X_joint</span><span class="p">))</span>

<span class="c1"># Find optimal
</span><span class="n">best_bic</span> <span class="o">=</span> <span class="n">n_components_range</span><span class="p">[</span><span class="n">np</span><span class="p">.</span><span class="n">argmin</span><span class="p">(</span><span class="n">bics</span><span class="p">)]</span>
<span class="n">best_aic</span> <span class="o">=</span> <span class="n">n_components_range</span><span class="p">[</span><span class="n">np</span><span class="p">.</span><span class="n">argmin</span><span class="p">(</span><span class="n">aics</span><span class="p">)]</span>
<span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">'Optimal components (BIC): </span><span class="si">{</span><span class="n">best_bic</span><span class="si">}</span><span class="s">'</span><span class="p">)</span>
<span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">'Optimal components (AIC): </span><span class="si">{</span><span class="n">best_aic</span><span class="si">}</span><span class="s">'</span><span class="p">)</span>
</code></pre></div></div>

<p>Results:</p>
<ul>
  <li>BIC suggests 1 component</li>
  <li>AIC suggests 3 components</li>
</ul>

<p><img src="/assets/images/posts/density-estimation/bic-aic-components.png" alt="BIC and AIC Model Selection" />
<em>BIC and AIC for different numbers of GMM components. BIC (which penalizes complexity more) favors 1 component, while AIC suggests 3.</em></p>

<p>BIC penalizes complexity more heavily and is generally preferred for model selection. Despite what the KDE visually suggests, the statistical evidence doesn’t strongly support multiple components. This is a good reminder: visual patterns in small samples can be noise.</p>

<hr />

<h2 id="application-digit-classification-with-gmm">Application: Digit Classification with GMM</h2>

<h3 id="the-problem">The Problem</h3>

<p>We have 1,990 images of handwritten digits from MNIST: specifically, the digits 2 and 6. Can we classify them using GMM as a generative model, without ever telling the algorithm what the true labels are?</p>

<p>This is an example of <strong>unsupervised learning</strong>: we’ll fit a model to the data and see if it naturally discovers the two digit classes.</p>

<h3 id="why-we-need-pca-first">Why We Need PCA First</h3>

<p>Each image is 28×28 = 784 pixels. That’s 784 dimensions. Why is this a problem for GMM?</p>

<ol>
  <li>
    <p><strong>Too many parameters</strong>: A full covariance matrix in 784D has $\frac{784 \times 785}{2} = 307,720$ parameters per component. With 2 components and only 1,990 data points, we’d be drastically overfitting.</p>
  </li>
  <li>
    <p><strong>Curse of dimensionality</strong>: In high dimensions, Gaussian densities become extremely peaked. Almost all points end up with near-zero density under any Gaussian.</p>
  </li>
  <li>
    <p><strong>Numerical instability</strong>: Covariance matrices become nearly singular (non-invertible) when dimensions exceed sample size.</p>
  </li>
</ol>

<p><strong>The solution</strong>: Use PCA to reduce 784 dimensions to just 4. These 4 principal components capture the most important patterns of variation in the digit images.</p>

<details>
<summary><strong>What do the 4 principal components capture?</strong></summary>
<p>PCA finds the directions of maximum variance in the data. For digit images:</p>
<ul>
<li><strong>PC1</strong>: Often captures overall brightness or stroke thickness</li>
<li><strong>PC2</strong>: May capture tilt/rotation of the digit</li>
<li><strong>PC3-4</strong>: Capture finer shape variations</li>
</ul>
<p>The key insight: digits 2 and 6 differ systematically along these components. A 2 has a horizontal bottom and a curved top. A 6 has a loop at the bottom. These structural differences show up as different positions in PCA space.</p>
</details>

<h3 id="loading-and-preprocessing">Loading and Preprocessing</h3>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="nn">scipy.io</span> <span class="kn">import</span> <span class="n">loadmat</span>
<span class="kn">from</span> <span class="nn">sklearn.decomposition</span> <span class="kn">import</span> <span class="n">PCA</span>

<span class="c1"># Load data
</span><span class="n">data_mat</span> <span class="o">=</span> <span class="n">loadmat</span><span class="p">(</span><span class="s">'data.mat'</span><span class="p">)</span>
<span class="n">labels_mat</span> <span class="o">=</span> <span class="n">loadmat</span><span class="p">(</span><span class="s">'label.mat'</span><span class="p">)</span>

<span class="c1"># data.mat contains pixel values: shape (784, 1990)
# Each column is one 28x28 image, flattened
</span><span class="n">X</span> <span class="o">=</span> <span class="n">data_mat</span><span class="p">[</span><span class="s">'data'</span><span class="p">].</span><span class="n">T</span>  <span class="c1"># Transpose to (1990, 784): one row per image
</span><span class="n">y</span> <span class="o">=</span> <span class="n">labels_mat</span><span class="p">[</span><span class="s">'trueLabel'</span><span class="p">].</span><span class="n">flatten</span><span class="p">()</span>  <span class="c1"># True labels (we won't use these for training)
</span>
<span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">'Data shape: </span><span class="si">{</span><span class="n">X</span><span class="p">.</span><span class="n">shape</span><span class="si">}</span><span class="s">'</span><span class="p">)</span>  <span class="c1"># (1990, 784)
</span><span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">'Unique labels: </span><span class="si">{</span><span class="n">np</span><span class="p">.</span><span class="n">unique</span><span class="p">(</span><span class="n">y</span><span class="p">)</span><span class="si">}</span><span class="s">'</span><span class="p">)</span>  <span class="c1"># [2, 6]
</span><span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">'Number of 2s: </span><span class="si">{</span><span class="n">np</span><span class="p">.</span><span class="nb">sum</span><span class="p">(</span><span class="n">y</span> <span class="o">==</span> <span class="mi">2</span><span class="p">)</span><span class="si">}</span><span class="s">'</span><span class="p">)</span>  <span class="c1"># ~1000
</span><span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">'Number of 6s: </span><span class="si">{</span><span class="n">np</span><span class="p">.</span><span class="nb">sum</span><span class="p">(</span><span class="n">y</span> <span class="o">==</span> <span class="mi">6</span><span class="p">)</span><span class="si">}</span><span class="s">'</span><span class="p">)</span>  <span class="c1"># ~990
</span>
<span class="c1"># Apply PCA: reduce from 784D to 4D
# This keeps the 4 directions that explain the most variance
</span><span class="n">pca</span> <span class="o">=</span> <span class="n">PCA</span><span class="p">(</span><span class="n">n_components</span><span class="o">=</span><span class="mi">4</span><span class="p">)</span>
<span class="n">X_pca</span> <span class="o">=</span> <span class="n">pca</span><span class="p">.</span><span class="n">fit_transform</span><span class="p">(</span><span class="n">X</span><span class="p">)</span>

<span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">'PCA shape: </span><span class="si">{</span><span class="n">X_pca</span><span class="p">.</span><span class="n">shape</span><span class="si">}</span><span class="s">'</span><span class="p">)</span>  <span class="c1"># (1990, 4)
</span><span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">'Variance explained: </span><span class="si">{</span><span class="n">pca</span><span class="p">.</span><span class="n">explained_variance_ratio_</span><span class="p">.</span><span class="nb">sum</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="o">%</span><span class="si">}</span><span class="s">'</span><span class="p">)</span>  <span class="c1"># ~40-50%
</span></code></pre></div></div>

<p>After PCA, each image is represented by just 4 numbers instead of 784. We lose some information, but we keep enough to distinguish 2s from 6s.</p>

<h3 id="fitting-the-gmm">Fitting the GMM</h3>

<p>Now we fit a 2-component GMM to the 4D PCA data. We set K=2 because we know there are two digit classes (though in practice, you might try different K values and use BIC to select).</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># Run EM algorithm with K=2 components
# X_pca has shape (1990, 4): 1990 images, each represented by 4 PCA components
</span><span class="n">pi</span><span class="p">,</span> <span class="n">mu</span><span class="p">,</span> <span class="n">Sigma</span><span class="p">,</span> <span class="n">gamma</span><span class="p">,</span> <span class="n">log_likelihoods</span> <span class="o">=</span> <span class="n">em_gmm</span><span class="p">(</span><span class="n">X_pca</span><span class="p">,</span> <span class="n">K</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span> <span class="n">seed</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>

<span class="c1"># Plot convergence to verify the algorithm worked
</span><span class="n">plt</span><span class="p">.</span><span class="n">figure</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">8</span><span class="p">,</span> <span class="mi">5</span><span class="p">))</span>
<span class="n">plt</span><span class="p">.</span><span class="n">plot</span><span class="p">(</span><span class="n">log_likelihoods</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">xlabel</span><span class="p">(</span><span class="s">'Iteration'</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">ylabel</span><span class="p">(</span><span class="s">'Log-Likelihood'</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">title</span><span class="p">(</span><span class="s">'EM Algorithm Convergence'</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">show</span><span class="p">()</span>

<span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">'Final mixing weights: </span><span class="si">{</span><span class="n">pi</span><span class="si">}</span><span class="s">'</span><span class="p">)</span>
<span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">'Converged in </span><span class="si">{</span><span class="nb">len</span><span class="p">(</span><span class="n">log_likelihoods</span><span class="p">)</span><span class="si">}</span><span class="s"> iterations'</span><span class="p">)</span>
</code></pre></div></div>

<p><strong>What to expect:</strong></p>
<ul>
  <li>The log-likelihood should increase monotonically (EM guarantees this)</li>
  <li>It should plateau when the algorithm has converged</li>
  <li>The mixing weights should be roughly 50/50 since we have similar numbers of 2s and 6s</li>
</ul>

<p><strong>Results:</strong></p>
<ul>
  <li>$\pi_1 = 0.51$ (51% of data assigned to component 1)</li>
  <li>$\pi_2 = 0.49$ (49% of data assigned to component 2)</li>
  <li>Converged in ~18 iterations</li>
</ul>

<p><img src="/assets/images/posts/density-estimation/em-convergence.png" alt="EM Convergence" />
<em>Log-likelihood increases monotonically and plateaus around iteration 15. The rapid convergence suggests the two digit classes are well-separated in PCA space.</em></p>

<details>
<summary><strong>What do the learned parameters mean?</strong></summary>
<p><strong>Mixing weights π:</strong> These tell us what fraction of data belongs to each component. Getting ~50/50 makes sense because we have roughly equal numbers of 2s and 6s in the dataset.</p>

<p><strong>Means μ (shape: 2×4):</strong> Each row is a 4D vector representing the "center" of one component in PCA space. These are abstract coordinates that we can map back to image space to visualize.</p>

<p><strong>Covariances Σ (two 4×4 matrices):</strong> These capture how the data varies within each component. Different diagonal values mean different variances along different PCA directions. Off-diagonal values capture correlations between PCA components within each digit class.</p>
</details>

<h3 id="visualizing-the-learned-means">Visualizing the Learned Means</h3>

<p>Here’s the exciting part: can we see what the GMM learned? The mean $\mu_k$ of each component is a 4D vector (in PCA space). But we can map it back to the original 784D pixel space using <code class="language-plaintext highlighter-rouge">pca.inverse_transform()</code>, then reshape it to 28×28 to see it as an image.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># mu has shape (2, 4): two means, each with 4 PCA components
# inverse_transform maps from 4D PCA space back to 784D pixel space
</span><span class="n">mu_original</span> <span class="o">=</span> <span class="n">pca</span><span class="p">.</span><span class="n">inverse_transform</span><span class="p">(</span><span class="n">mu</span><span class="p">)</span>  <span class="c1"># Shape: (2, 784)
</span>
<span class="c1"># Reshape each 784D vector into a 28x28 image and display
</span><span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="n">subplots</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">8</span><span class="p">,</span> <span class="mi">4</span><span class="p">))</span>
<span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="mi">2</span><span class="p">):</span>
    <span class="c1"># Reshape from (784,) to (28, 28) for visualization
</span>    <span class="n">mean_image</span> <span class="o">=</span> <span class="n">mu_original</span><span class="p">[</span><span class="n">i</span><span class="p">].</span><span class="n">reshape</span><span class="p">(</span><span class="mi">28</span><span class="p">,</span> <span class="mi">28</span><span class="p">)</span>
    <span class="n">axes</span><span class="p">[</span><span class="n">i</span><span class="p">].</span><span class="n">imshow</span><span class="p">(</span><span class="n">mean_image</span><span class="p">,</span> <span class="n">cmap</span><span class="o">=</span><span class="s">'gray'</span><span class="p">)</span>
    <span class="n">axes</span><span class="p">[</span><span class="n">i</span><span class="p">].</span><span class="n">set_title</span><span class="p">(</span><span class="sa">f</span><span class="s">'Mean Image of Component </span><span class="si">{</span><span class="n">i</span><span class="o">+</span><span class="mi">1</span><span class="si">}</span><span class="s">'</span><span class="p">)</span>
    <span class="n">axes</span><span class="p">[</span><span class="n">i</span><span class="p">].</span><span class="n">axis</span><span class="p">(</span><span class="s">'off'</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">show</span><span class="p">()</span>
</code></pre></div></div>

<p><img src="/assets/images/posts/density-estimation/gmm-mean-images.png" alt="Learned Mean Images" />
<em>Mean images of the two GMM components, mapped back to 28×28 pixel space. One clearly resembles a “2”, the other resembles a “6”. The GMM discovered the digit structure without being told the labels.</em></p>

<p><strong>This is remarkable:</strong> We never told the GMM that the data contains 2s and 6s. We just said “fit 2 components.” Yet the learned means clearly resemble the actual digits. The algorithm discovered the underlying structure purely from the data.</p>

<details>
<summary><strong>Why are the mean images slightly blurry?</strong></summary>
<p>Two reasons:</p>
<ol>
<li><strong>PCA reconstruction loss:</strong> We compressed 784 dimensions to 4, then reconstructed. Some information is lost. The missing 780 dimensions contained fine details that can't be recovered.</li>
<li><strong>Averaging effect:</strong> The mean is an "average" of all digits assigned to that component. Handwritten 2s vary in slant, size, and style. Averaging them produces a blurry composite.</li>
</ol>
<p>Despite the blur, the essential digit structure is clearly visible.</p>
</details>

<h3 id="covariance-structure">Covariance Structure</h3>

<p>The GMM doesn’t just learn means. It also learns how data varies around each mean. This is captured in the 4×4 covariance matrices, one per component.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">seaborn</span> <span class="k">as</span> <span class="n">sns</span>

<span class="c1"># Sigma is a list of two 4x4 covariance matrices
</span><span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="n">subplots</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">10</span><span class="p">,</span> <span class="mi">4</span><span class="p">))</span>
<span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="mi">2</span><span class="p">):</span>
    <span class="n">sns</span><span class="p">.</span><span class="n">heatmap</span><span class="p">(</span><span class="n">Sigma</span><span class="p">[</span><span class="n">i</span><span class="p">],</span> <span class="n">annot</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">fmt</span><span class="o">=</span><span class="s">'.2f'</span><span class="p">,</span> <span class="n">ax</span><span class="o">=</span><span class="n">axes</span><span class="p">[</span><span class="n">i</span><span class="p">],</span> <span class="n">cmap</span><span class="o">=</span><span class="s">'RdBu_r'</span><span class="p">,</span>
                <span class="n">xticklabels</span><span class="o">=</span><span class="p">[</span><span class="s">'PC1'</span><span class="p">,</span> <span class="s">'PC2'</span><span class="p">,</span> <span class="s">'PC3'</span><span class="p">,</span> <span class="s">'PC4'</span><span class="p">],</span>
                <span class="n">yticklabels</span><span class="o">=</span><span class="p">[</span><span class="s">'PC1'</span><span class="p">,</span> <span class="s">'PC2'</span><span class="p">,</span> <span class="s">'PC3'</span><span class="p">,</span> <span class="s">'PC4'</span><span class="p">])</span>
    <span class="n">axes</span><span class="p">[</span><span class="n">i</span><span class="p">].</span><span class="n">set_title</span><span class="p">(</span><span class="sa">f</span><span class="s">'Covariance Matrix of Component </span><span class="si">{</span><span class="n">i</span><span class="o">+</span><span class="mi">1</span><span class="si">}</span><span class="s">'</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">tight_layout</span><span class="p">()</span>
<span class="n">plt</span><span class="p">.</span><span class="n">show</span><span class="p">()</span>
</code></pre></div></div>

<p><img src="/assets/images/posts/density-estimation/covariance-heatmaps.png" alt="Covariance Heatmaps" />
<em>4×4 covariance matrices for each component in PCA space. The diagonal shows variance along each principal component. Off-diagonal shows correlations.</em></p>

<details>
<summary><strong>How to read these matrices</strong></summary>
<p><strong>Diagonal entries</strong> (e.g., position [0,0]) show the variance along each principal component. Larger values mean more spread in that direction.</p>

<p><strong>Off-diagonal entries</strong> (e.g., position [0,1]) show correlations between components. If positive, when PC1 increases, PC2 tends to increase too. If negative, they move in opposite directions.</p>

<p><strong>Why the matrices differ:</strong> Digits 2 and 6 vary in different ways. For example:</p>
<ul>
<li>The curvature of a "2" might vary differently than the loop of a "6"</li>
<li>The slant of a "2" might correlate with its height differently than for a "6"</li>
</ul>
<p>By learning separate covariance matrices, the GMM captures these differences, leading to elliptical (not spherical) clusters that better fit the data.</p>
</details>

<h3 id="classification-results">Classification Results</h3>

<p>Now we evaluate: how well did the GMM separate 2s from 6s? We assign each point to the component with higher responsibility, then compare to the true labels.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="nn">sklearn.metrics</span> <span class="kn">import</span> <span class="n">classification_report</span><span class="p">,</span> <span class="n">confusion_matrix</span>

<span class="c1"># gamma has shape (1990, 2): responsibility of each point to each component
# For each point, pick the component with higher responsibility
</span><span class="n">predicted_clusters</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">argmax</span><span class="p">(</span><span class="n">gamma</span><span class="p">,</span> <span class="n">axis</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>  <span class="c1"># Shape: (1990,), values 0 or 1
</span>
<span class="c1"># Problem: The GMM doesn't know which component is "2" vs "6"
# We need to figure out the mapping by looking at majority labels
</span><span class="n">cluster_0_labels</span> <span class="o">=</span> <span class="n">y</span><span class="p">[</span><span class="n">predicted_clusters</span> <span class="o">==</span> <span class="mi">0</span><span class="p">]</span>  <span class="c1"># True labels for points assigned to cluster 0
</span><span class="n">cluster_1_labels</span> <span class="o">=</span> <span class="n">y</span><span class="p">[</span><span class="n">predicted_clusters</span> <span class="o">==</span> <span class="mi">1</span><span class="p">]</span>  <span class="c1"># True labels for points assigned to cluster 1
</span>
<span class="c1"># Determine mapping based on which digit is majority in each cluster
</span><span class="k">if</span> <span class="n">np</span><span class="p">.</span><span class="nb">sum</span><span class="p">(</span><span class="n">cluster_0_labels</span> <span class="o">==</span> <span class="mi">2</span><span class="p">)</span> <span class="o">&gt;</span> <span class="n">np</span><span class="p">.</span><span class="nb">sum</span><span class="p">(</span><span class="n">cluster_0_labels</span> <span class="o">==</span> <span class="mi">6</span><span class="p">):</span>
    <span class="c1"># Cluster 0 is mostly 2s, so map cluster 0 → digit 2
</span>    <span class="n">cluster_to_digit</span> <span class="o">=</span> <span class="p">{</span><span class="mi">0</span><span class="p">:</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">1</span><span class="p">:</span> <span class="mi">6</span><span class="p">}</span>
<span class="k">else</span><span class="p">:</span>
    <span class="c1"># Cluster 0 is mostly 6s, so map cluster 0 → digit 6
</span>    <span class="n">cluster_to_digit</span> <span class="o">=</span> <span class="p">{</span><span class="mi">0</span><span class="p">:</span> <span class="mi">6</span><span class="p">,</span> <span class="mi">1</span><span class="p">:</span> <span class="mi">2</span><span class="p">}</span>

<span class="c1"># Convert cluster assignments to digit predictions
</span><span class="n">predicted_digits</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">array</span><span class="p">([</span><span class="n">cluster_to_digit</span><span class="p">[</span><span class="n">c</span><span class="p">]</span> <span class="k">for</span> <span class="n">c</span> <span class="ow">in</span> <span class="n">predicted_clusters</span><span class="p">])</span>

<span class="c1"># Evaluate against true labels
</span><span class="k">print</span><span class="p">(</span><span class="s">'GMM Classification Results:'</span><span class="p">)</span>
<span class="k">print</span><span class="p">(</span><span class="n">confusion_matrix</span><span class="p">(</span><span class="n">y</span><span class="p">,</span> <span class="n">predicted_digits</span><span class="p">))</span>
<span class="k">print</span><span class="p">(</span><span class="n">classification_report</span><span class="p">(</span><span class="n">y</span><span class="p">,</span> <span class="n">predicted_digits</span><span class="p">,</span> <span class="n">target_names</span><span class="o">=</span><span class="p">[</span><span class="s">'Digit 2'</span><span class="p">,</span> <span class="s">'Digit 6'</span><span class="p">]))</span>
</code></pre></div></div>

<details>
<summary><strong>Understanding the confusion matrix</strong></summary>
<p>The confusion matrix shows:</p>
<table>
<tr><th></th><th>Predicted 2</th><th>Predicted 6</th></tr>
<tr><td>Actual 2</td><td>~940 (correct)</td><td>~60 (wrong)</td></tr>
<tr><td>Actual 6</td><td>~10 (wrong)</td><td>~980 (correct)</td></tr>
</table>
<p>Most 2s are correctly identified as 2s, and most 6s as 6s. The ~70 errors are digits that look ambiguous or unusual.</p>
</details>

<p><strong>Results comparison with K-Means:</strong></p>

<table>
  <thead>
    <tr>
      <th>Metric</th>
      <th>GMM</th>
      <th>K-Means</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Accuracy</td>
      <td>96%</td>
      <td>93%</td>
    </tr>
    <tr>
      <td>Precision (Digit 2)</td>
      <td>0.99</td>
      <td>0.93</td>
    </tr>
    <tr>
      <td>Recall (Digit 2)</td>
      <td>0.94</td>
      <td>0.94</td>
    </tr>
    <tr>
      <td>Precision (Digit 6)</td>
      <td>0.93</td>
      <td>0.93</td>
    </tr>
    <tr>
      <td>Recall (Digit 6)</td>
      <td>0.99</td>
      <td>0.92</td>
    </tr>
  </tbody>
</table>

<p><strong>Why does GMM outperform K-Means?</strong></p>

<ol>
  <li>
    <p><strong>Elliptical vs spherical clusters</strong>: K-Means assumes all clusters are spherical with equal variance. GMM learns a full covariance matrix, allowing elliptical clusters of different shapes and orientations. If 2s are spread out differently than 6s in PCA space, GMM can capture this.</p>
  </li>
  <li>
    <p><strong>Soft vs hard assignments</strong>: K-Means makes hard assignments (each point belongs to exactly one cluster). GMM gives soft probabilities. Points near the decision boundary get split responsibility, which often leads to better boundary estimation.</p>
  </li>
  <li>
    <p><strong>Probabilistic framework</strong>: GMM explicitly models the data-generating process. This tends to be more robust when the assumptions (Gaussian components) are approximately satisfied.</p>
  </li>
</ol>

<hr />

<h2 id="summary">Summary</h2>

<h3 id="histograms">Histograms</h3>
<ul>
  <li>Simple and interpretable</li>
  <li>Sensitive to bin placement</li>
  <li>Discontinuous, can’t generate new samples</li>
  <li>Breaks down in high dimensions</li>
</ul>

<h3 id="kernel-density-estimation">Kernel Density Estimation</h3>
<ul>
  <li>Smooth, continuous density estimate</li>
  <li>Bandwidth is the key parameter (use Scott’s rule as starting point)</li>
  <li>Can sample from the estimated distribution</li>
  <li>Computationally expensive for large datasets</li>
</ul>

<h3 id="gaussian-mixture-models">Gaussian Mixture Models</h3>
<ul>
  <li>Model data as a mixture of Gaussian components</li>
  <li>Learn parameters with EM algorithm</li>
  <li>Soft assignments: each point has probability of belonging to each component</li>
  <li>More flexible than K-Means (allows elliptical clusters)</li>
</ul>

<h3 id="em-algorithm">EM Algorithm</h3>
<ul>
  <li>E-step: compute responsibilities using current parameters</li>
  <li>M-step: update parameters using responsibilities</li>
  <li>Guaranteed to increase log-likelihood each iteration</li>
  <li>Converges to local optimum (run multiple times)</li>
</ul>

<h3 id="general-principles">General Principles</h3>

<ol>
  <li>
    <p><strong>Bandwidth matters in KDE.</strong> Too small = overfitting, too large = oversmoothing. Start with Scott’s rule and adjust.</p>
  </li>
  <li>
    <p><strong>Use BIC/AIC for model selection.</strong> Don’t just pick the number of components that looks right visually.</p>
  </li>
  <li>
    <p><strong>GMM beats K-Means when clusters are elliptical.</strong> If your clusters are truly spherical, K-Means is simpler and faster.</p>
  </li>
  <li>
    <p><strong>EM finds local optima.</strong> Run multiple times with different initializations.</p>
  </li>
  <li>
    <p><strong>Visual patterns can be noise.</strong> Statistical tests often reveal that apparent structure isn’t significant, especially in small samples.</p>
  </li>
</ol>

<hr />

<h2 id="references">References</h2>

<p><strong>Kernel Density Estimation</strong></p>
<ul>
  <li>Silverman, B. W. (1986). <em>Density Estimation for Statistics and Data Analysis</em>. Chapman and Hall.</li>
  <li>Scott, D. W. (1992). <em>Multivariate Density Estimation: Theory, Practice, and Visualization</em>. Wiley.</li>
</ul>

<p><strong>Gaussian Mixture Models and EM</strong></p>
<ul>
  <li>Dempster, A. P., Laird, N. M., &amp; Rubin, D. B. (1977). <a href="https://www.jstor.org/stable/2984875">“Maximum Likelihood from Incomplete Data via the EM Algorithm.”</a> <em>Journal of the Royal Statistical Society: Series B</em>, 39(1), 1-38.</li>
  <li>Bishop, C. M. (2006). <em>Pattern Recognition and Machine Learning</em>, Chapter 9. Springer.</li>
</ul>

<p><strong>Model Selection</strong></p>
<ul>
  <li>Schwarz, G. (1978). “Estimating the Dimension of a Model.” <em>Annals of Statistics</em>, 6(2), 461-464.</li>
  <li>Akaike, H. (1974). “A New Look at the Statistical Model Identification.” <em>IEEE Transactions on Automatic Control</em>, 19(6), 716-723.</li>
</ul>

<hr />

<h2 id="appendix-complete-implementations">Appendix: Complete Implementations</h2>

<h3 id="kde-implementation">KDE Implementation</h3>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">from</span> <span class="nn">scipy.stats</span> <span class="kn">import</span> <span class="n">gaussian_kde</span>
<span class="kn">import</span> <span class="nn">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>

<span class="k">def</span> <span class="nf">kde_1d</span><span class="p">(</span><span class="n">data</span><span class="p">,</span> <span class="n">bandwidth_factor</span><span class="o">=</span><span class="mf">1.0</span><span class="p">):</span>
    <span class="s">"""1D Kernel Density Estimation."""</span>
    <span class="n">kde</span> <span class="o">=</span> <span class="n">gaussian_kde</span><span class="p">(</span><span class="n">data</span><span class="p">)</span>
    <span class="n">kde</span> <span class="o">=</span> <span class="n">gaussian_kde</span><span class="p">(</span><span class="n">data</span><span class="p">,</span> <span class="n">bw_method</span><span class="o">=</span><span class="n">bandwidth_factor</span> <span class="o">*</span> <span class="n">kde</span><span class="p">.</span><span class="n">factor</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">kde</span>

<span class="k">def</span> <span class="nf">kde_2d</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">y</span><span class="p">,</span> <span class="n">bandwidth_factor</span><span class="o">=</span><span class="mf">1.0</span><span class="p">):</span>
    <span class="s">"""2D Kernel Density Estimation."""</span>
    <span class="n">data</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">vstack</span><span class="p">([</span><span class="n">x</span><span class="p">,</span> <span class="n">y</span><span class="p">])</span>
    <span class="n">kde</span> <span class="o">=</span> <span class="n">gaussian_kde</span><span class="p">(</span><span class="n">data</span><span class="p">)</span>
    <span class="n">kde</span> <span class="o">=</span> <span class="n">gaussian_kde</span><span class="p">(</span><span class="n">data</span><span class="p">,</span> <span class="n">bw_method</span><span class="o">=</span><span class="n">bandwidth_factor</span> <span class="o">*</span> <span class="n">kde</span><span class="p">.</span><span class="n">factor</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">kde</span>

<span class="k">def</span> <span class="nf">plot_kde_2d</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">y</span><span class="p">,</span> <span class="n">bandwidth_factor</span><span class="o">=</span><span class="mf">0.5</span><span class="p">,</span> <span class="n">grid_size</span><span class="o">=</span><span class="mi">100</span><span class="p">):</span>
    <span class="s">"""Plot 2D KDE as contour."""</span>
    <span class="n">kde</span> <span class="o">=</span> <span class="n">kde_2d</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">y</span><span class="p">,</span> <span class="n">bandwidth_factor</span><span class="p">)</span>

    <span class="n">x_grid</span><span class="p">,</span> <span class="n">y_grid</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">mgrid</span><span class="p">[</span><span class="n">x</span><span class="p">.</span><span class="nb">min</span><span class="p">():</span><span class="n">x</span><span class="p">.</span><span class="nb">max</span><span class="p">():</span><span class="nb">complex</span><span class="p">(</span><span class="n">grid_size</span><span class="p">),</span>
                               <span class="n">y</span><span class="p">.</span><span class="nb">min</span><span class="p">():</span><span class="n">y</span><span class="p">.</span><span class="nb">max</span><span class="p">():</span><span class="nb">complex</span><span class="p">(</span><span class="n">grid_size</span><span class="p">)]</span>
    <span class="n">positions</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">vstack</span><span class="p">([</span><span class="n">x_grid</span><span class="p">.</span><span class="n">ravel</span><span class="p">(),</span> <span class="n">y_grid</span><span class="p">.</span><span class="n">ravel</span><span class="p">()])</span>
    <span class="n">z</span> <span class="o">=</span> <span class="n">kde</span><span class="p">(</span><span class="n">positions</span><span class="p">).</span><span class="n">reshape</span><span class="p">(</span><span class="n">x_grid</span><span class="p">.</span><span class="n">shape</span><span class="p">)</span>

    <span class="n">plt</span><span class="p">.</span><span class="n">contourf</span><span class="p">(</span><span class="n">x_grid</span><span class="p">,</span> <span class="n">y_grid</span><span class="p">,</span> <span class="n">z</span><span class="p">,</span> <span class="n">levels</span><span class="o">=</span><span class="mi">20</span><span class="p">,</span> <span class="n">cmap</span><span class="o">=</span><span class="s">'plasma'</span><span class="p">)</span>
    <span class="n">plt</span><span class="p">.</span><span class="n">colorbar</span><span class="p">(</span><span class="n">label</span><span class="o">=</span><span class="s">'Density'</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">kde</span>
</code></pre></div></div>

<h3 id="gmm-with-em-implementation">GMM with EM Implementation</h3>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">from</span> <span class="nn">scipy.stats</span> <span class="kn">import</span> <span class="n">multivariate_normal</span>

<span class="k">def</span> <span class="nf">em_gmm</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">K</span><span class="p">,</span> <span class="n">max_iters</span><span class="o">=</span><span class="mi">100</span><span class="p">,</span> <span class="n">tol</span><span class="o">=</span><span class="mf">1e-6</span><span class="p">,</span> <span class="n">seed</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
    <span class="s">"""
    Fit GMM using Expectation-Maximization.

    Parameters:
    - X: data (n_samples, n_features)
    - K: number of components
    - max_iters: maximum iterations
    - tol: convergence tolerance
    - seed: random seed

    Returns:
    - pi: weights (K,)
    - mu: means (K, n_features)
    - Sigma: covariances list of (n_features, n_features)
    - gamma: responsibilities (n_samples, K)
    - log_likelihoods: convergence history
    """</span>
    <span class="k">if</span> <span class="n">seed</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
        <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">seed</span><span class="p">(</span><span class="n">seed</span><span class="p">)</span>

    <span class="n">n_samples</span><span class="p">,</span> <span class="n">n_features</span> <span class="o">=</span> <span class="n">X</span><span class="p">.</span><span class="n">shape</span>

    <span class="c1"># Initialize
</span>    <span class="n">mu</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">randn</span><span class="p">(</span><span class="n">K</span><span class="p">,</span> <span class="n">n_features</span><span class="p">)</span>
    <span class="n">Sigma</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">K</span><span class="p">):</span>
        <span class="n">S</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">randn</span><span class="p">(</span><span class="n">n_features</span><span class="p">,</span> <span class="n">n_features</span><span class="p">)</span>
        <span class="n">Sigma</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">S</span> <span class="o">@</span> <span class="n">S</span><span class="p">.</span><span class="n">T</span> <span class="o">+</span> <span class="n">np</span><span class="p">.</span><span class="n">eye</span><span class="p">(</span><span class="n">n_features</span><span class="p">))</span>
    <span class="n">pi</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">ones</span><span class="p">(</span><span class="n">K</span><span class="p">)</span> <span class="o">/</span> <span class="n">K</span>

    <span class="n">log_likelihoods</span> <span class="o">=</span> <span class="p">[]</span>

    <span class="k">for</span> <span class="n">iteration</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">max_iters</span><span class="p">):</span>
        <span class="c1"># E-Step
</span>        <span class="n">gamma</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">zeros</span><span class="p">((</span><span class="n">n_samples</span><span class="p">,</span> <span class="n">K</span><span class="p">))</span>
        <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">K</span><span class="p">):</span>
            <span class="n">gamma</span><span class="p">[:,</span> <span class="n">k</span><span class="p">]</span> <span class="o">=</span> <span class="n">pi</span><span class="p">[</span><span class="n">k</span><span class="p">]</span> <span class="o">*</span> <span class="n">multivariate_normal</span><span class="p">.</span><span class="n">pdf</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">mean</span><span class="o">=</span><span class="n">mu</span><span class="p">[</span><span class="n">k</span><span class="p">],</span> <span class="n">cov</span><span class="o">=</span><span class="n">Sigma</span><span class="p">[</span><span class="n">k</span><span class="p">])</span>
        <span class="n">gamma</span> <span class="o">/=</span> <span class="n">gamma</span><span class="p">.</span><span class="nb">sum</span><span class="p">(</span><span class="n">axis</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdims</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>

        <span class="c1"># M-Step
</span>        <span class="n">Nk</span> <span class="o">=</span> <span class="n">gamma</span><span class="p">.</span><span class="nb">sum</span><span class="p">(</span><span class="n">axis</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span>
        <span class="n">pi</span> <span class="o">=</span> <span class="n">Nk</span> <span class="o">/</span> <span class="n">n_samples</span>

        <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">K</span><span class="p">):</span>
            <span class="n">mu</span><span class="p">[</span><span class="n">k</span><span class="p">]</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">dot</span><span class="p">(</span><span class="n">gamma</span><span class="p">[:,</span> <span class="n">k</span><span class="p">],</span> <span class="n">X</span><span class="p">)</span> <span class="o">/</span> <span class="n">Nk</span><span class="p">[</span><span class="n">k</span><span class="p">]</span>
            <span class="n">centered</span> <span class="o">=</span> <span class="n">X</span> <span class="o">-</span> <span class="n">mu</span><span class="p">[</span><span class="n">k</span><span class="p">]</span>
            <span class="n">Sigma</span><span class="p">[</span><span class="n">k</span><span class="p">]</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">dot</span><span class="p">((</span><span class="n">gamma</span><span class="p">[:,</span> <span class="n">k</span><span class="p">,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">*</span> <span class="n">centered</span><span class="p">).</span><span class="n">T</span><span class="p">,</span> <span class="n">centered</span><span class="p">)</span> <span class="o">/</span> <span class="n">Nk</span><span class="p">[</span><span class="n">k</span><span class="p">]</span>

        <span class="c1"># Log-likelihood
</span>        <span class="n">ll</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nb">sum</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="n">log</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nb">sum</span><span class="p">([</span>
            <span class="n">pi</span><span class="p">[</span><span class="n">k</span><span class="p">]</span> <span class="o">*</span> <span class="n">multivariate_normal</span><span class="p">.</span><span class="n">pdf</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">mean</span><span class="o">=</span><span class="n">mu</span><span class="p">[</span><span class="n">k</span><span class="p">],</span> <span class="n">cov</span><span class="o">=</span><span class="n">Sigma</span><span class="p">[</span><span class="n">k</span><span class="p">])</span>
            <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">K</span><span class="p">)</span>
        <span class="p">],</span> <span class="n">axis</span><span class="o">=</span><span class="mi">0</span><span class="p">)))</span>
        <span class="n">log_likelihoods</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">ll</span><span class="p">)</span>

        <span class="c1"># Convergence check
</span>        <span class="k">if</span> <span class="n">iteration</span> <span class="o">&gt;</span> <span class="mi">0</span> <span class="ow">and</span> <span class="nb">abs</span><span class="p">(</span><span class="n">log_likelihoods</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span> <span class="o">-</span> <span class="n">log_likelihoods</span><span class="p">[</span><span class="o">-</span><span class="mi">2</span><span class="p">])</span> <span class="o">&lt;</span> <span class="n">tol</span><span class="p">:</span>
            <span class="k">break</span>

    <span class="k">return</span> <span class="n">pi</span><span class="p">,</span> <span class="n">mu</span><span class="p">,</span> <span class="n">Sigma</span><span class="p">,</span> <span class="n">gamma</span><span class="p">,</span> <span class="n">log_likelihoods</span>

<span class="k">def</span> <span class="nf">predict_gmm</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">pi</span><span class="p">,</span> <span class="n">mu</span><span class="p">,</span> <span class="n">Sigma</span><span class="p">):</span>
    <span class="s">"""Predict cluster assignments from fitted GMM."""</span>
    <span class="n">K</span> <span class="o">=</span> <span class="nb">len</span><span class="p">(</span><span class="n">pi</span><span class="p">)</span>
    <span class="n">n_samples</span> <span class="o">=</span> <span class="n">X</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>

    <span class="n">gamma</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">zeros</span><span class="p">((</span><span class="n">n_samples</span><span class="p">,</span> <span class="n">K</span><span class="p">))</span>
    <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">K</span><span class="p">):</span>
        <span class="n">gamma</span><span class="p">[:,</span> <span class="n">k</span><span class="p">]</span> <span class="o">=</span> <span class="n">pi</span><span class="p">[</span><span class="n">k</span><span class="p">]</span> <span class="o">*</span> <span class="n">multivariate_normal</span><span class="p">.</span><span class="n">pdf</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">mean</span><span class="o">=</span><span class="n">mu</span><span class="p">[</span><span class="n">k</span><span class="p">],</span> <span class="n">cov</span><span class="o">=</span><span class="n">Sigma</span><span class="p">[</span><span class="n">k</span><span class="p">])</span>
    <span class="n">gamma</span> <span class="o">/=</span> <span class="n">gamma</span><span class="p">.</span><span class="nb">sum</span><span class="p">(</span><span class="n">axis</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdims</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>

    <span class="k">return</span> <span class="n">np</span><span class="p">.</span><span class="n">argmax</span><span class="p">(</span><span class="n">gamma</span><span class="p">,</span> <span class="n">axis</span><span class="o">=</span><span class="mi">1</span><span class="p">),</span> <span class="n">gamma</span>
</code></pre></div></div>

<h3 id="model-selection">Model Selection</h3>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="nn">sklearn.mixture</span> <span class="kn">import</span> <span class="n">GaussianMixture</span>

<span class="k">def</span> <span class="nf">select_n_components</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">max_components</span><span class="o">=</span><span class="mi">10</span><span class="p">):</span>
    <span class="s">"""Select optimal number of GMM components using BIC."""</span>
    <span class="n">bics</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="n">aics</span> <span class="o">=</span> <span class="p">[]</span>

    <span class="k">for</span> <span class="n">n</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">max_components</span> <span class="o">+</span> <span class="mi">1</span><span class="p">):</span>
        <span class="n">gmm</span> <span class="o">=</span> <span class="n">GaussianMixture</span><span class="p">(</span><span class="n">n_components</span><span class="o">=</span><span class="n">n</span><span class="p">,</span> <span class="n">random_state</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span>
        <span class="n">gmm</span><span class="p">.</span><span class="n">fit</span><span class="p">(</span><span class="n">X</span><span class="p">)</span>
        <span class="n">bics</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">gmm</span><span class="p">.</span><span class="n">bic</span><span class="p">(</span><span class="n">X</span><span class="p">))</span>
        <span class="n">aics</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">gmm</span><span class="p">.</span><span class="n">aic</span><span class="p">(</span><span class="n">X</span><span class="p">))</span>

    <span class="n">best_bic</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">argmin</span><span class="p">(</span><span class="n">bics</span><span class="p">)</span> <span class="o">+</span> <span class="mi">1</span>
    <span class="n">best_aic</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">argmin</span><span class="p">(</span><span class="n">aics</span><span class="p">)</span> <span class="o">+</span> <span class="mi">1</span>

    <span class="k">return</span> <span class="n">best_bic</span><span class="p">,</span> <span class="n">best_aic</span><span class="p">,</span> <span class="n">bics</span><span class="p">,</span> <span class="n">aics</span>
</code></pre></div></div>

<hr />

<p><em>PS: This work was completed at Georgia Tech. The original submission files can be provided upon request to validate that this work is entirely my own.</em></p>]]></content><author><name>Danny Tabach</name></author><category term="from-scratch" /><category term="machine-learning" /><category term="density-estimation" /><category term="kde" /><category term="gmm" /><category term="em-algorithm" /><category term="python" /><category term="numpy" /><summary type="html"><![CDATA[How do you estimate the shape of data when you don’t know what distribution it came from?]]></summary></entry><entry><title type="html">Dimensionality Reduction From Scratch: PCA, ISOMAP, and Eigenfaces</title><link href="https://danieltabach.github.io/from-scratch/dimensionality-reduction-from-scratch/" rel="alternate" type="text/html" title="Dimensionality Reduction From Scratch: PCA, ISOMAP, and Eigenfaces" /><published>2025-01-17T00:00:00-05:00</published><updated>2025-01-17T00:00:00-05:00</updated><id>https://danieltabach.github.io/from-scratch/dimensionality-reduction-from-scratch</id><content type="html" xml:base="https://danieltabach.github.io/from-scratch/dimensionality-reduction-from-scratch/"><![CDATA[<p><em>You have thousands of features but only care about the patterns that matter. Here’s how to find them.</em></p>

<hr />

<h2 id="introduction">Introduction</h2>

<p>High-dimensional data is everywhere. Images with millions of pixels, datasets with hundreds of columns, gene expression profiles with tens of thousands of genes. The curse of dimensionality makes this data hard to visualize, slow to process, and prone to overfitting.</p>

<p>Dimensionality reduction solves this by finding the essential structure in your data. In this post, we’ll build three algorithms from scratch:</p>

<ol>
  <li><strong>PCA (Principal Component Analysis)</strong>: Find the directions of maximum variance</li>
  <li><strong>ISOMAP</strong>: Preserve geodesic distances for nonlinear manifolds</li>
  <li><strong>Eigenfaces</strong>: Apply PCA to face recognition</li>
</ol>

<p>We’ll use real datasets: food consumption patterns across European countries, a manifold of face images, and the Yale Face dataset for recognition.</p>

<p>Obviously in practice you’d use sklearn and do this in minutes, but understanding the underlying math gives you intuition for when each method works and when it fails.</p>

<p><strong>Just want the code?</strong> Skip to the <a href="#appendix-complete-implementations">Appendix</a> for copy-paste ready implementations.</p>

<hr />

<h2 id="part-1-pca-from-scratch">Part 1: PCA from Scratch</h2>

<h3 id="the-problem">The Problem</h3>

<p>PCA asks: if we have to compress our data to fewer dimensions, which directions should we keep?</p>

<p>The answer is elegant: keep the directions where your data varies the most. High variance means information. Low variance means noise (or at least, nothing useful for distinguishing data points).</p>

<h3 id="the-math">The Math</h3>

<p>Given $m$ data points $x^1, x^2, \ldots, x^m$, we want to find a direction $w$ that maximizes variance when we project onto it:</p>

\[w^* = \arg\max_{w: ||w|| = 1} \frac{1}{m} \sum_{i=1}^{m} (w^T x^i - w^T \mu)^2\]

<p>where $\mu$ is the mean. This simplifies to:</p>

\[w^* = \arg\max_{w: ||w|| = 1} w^T C w\]

<p>where $C$ is the covariance matrix. Using Lagrange multipliers (constrained optimization), we get:</p>

\[Cw = \lambda w\]

<p>The optimal $w$ is an <strong>eigenvector</strong> of the covariance matrix, and $\lambda$ (the eigenvalue) equals the variance in that direction.</p>

<p><strong>The key insight</strong>: To get the first principal component, find the eigenvector with the largest eigenvalue. For the second PC, take the eigenvector with the second-largest eigenvalue. And so on.</p>

<details>
<summary><strong>See it with a tiny example</strong></summary>
<p>Say we have 4 data points with 3 features each (4×3 matrix):</p>
<table>
<tr><th>Point</th><th>Height</th><th>Weight</th><th>Age</th></tr>
<tr><td>A</td><td>5</td><td>150</td><td>25</td></tr>
<tr><td>B</td><td>6</td><td>180</td><td>30</td></tr>
<tr><td>C</td><td>5.5</td><td>160</td><td>28</td></tr>
<tr><td>D</td><td>6.5</td><td>200</td><td>35</td></tr>
</table>
<p><strong>Step 1: Center the data</strong> (subtract column means)</p>
<table>
<tr><th>Point</th><th>Height</th><th>Weight</th><th>Age</th></tr>
<tr><td>A</td><td>-0.75</td><td>-22.5</td><td>-4.5</td></tr>
<tr><td>B</td><td>0.25</td><td>7.5</td><td>0.5</td></tr>
<tr><td>C</td><td>-0.25</td><td>-12.5</td><td>-1.5</td></tr>
<tr><td>D</td><td>0.75</td><td>27.5</td><td>5.5</td></tr>
</table>
<p><strong>Step 2: Covariance matrix</strong> (3×3, one entry per feature pair)</p>
<table>
<tr><th></th><th>Height</th><th>Weight</th><th>Age</th></tr>
<tr><td><strong>Height</strong></td><td>0.42</td><td>17.5</td><td>3.5</td></tr>
<tr><td><strong>Weight</strong></td><td>17.5</td><td>758.3</td><td>145.8</td></tr>
<tr><td><strong>Age</strong></td><td>3.5</td><td>145.8</td><td>29.2</td></tr>
</table>
<p>The diagonal shows variance of each feature. Off-diagonal shows how features co-vary.</p>
<p><strong>Step 3: Eigenvectors point in directions of maximum spread</strong></p>
<p>The eigenvector with the largest eigenvalue points roughly in the Weight direction (since Weight has the most variance). Projecting onto this eigenvector gives PC1.</p>
</details>

<h3 id="implementation">Implementation</h3>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">import</span> <span class="nn">pandas</span> <span class="k">as</span> <span class="n">pd</span>
<span class="kn">import</span> <span class="nn">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>

<span class="k">def</span> <span class="nf">perform_pca</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">n_components</span><span class="o">=</span><span class="mi">2</span><span class="p">):</span>
    <span class="s">"""
    Perform PCA from scratch.

    X: data matrix where each row is a sample, each column is a feature
    n_components: number of principal components to return
    """</span>
    <span class="c1"># Step 1: Center the data
</span>    <span class="c1"># PCA is sensitive to scale, so we subtract the mean
</span>    <span class="c1"># This ensures the first PC passes through the data centroid
</span>    <span class="n">X_centered</span> <span class="o">=</span> <span class="n">X</span> <span class="o">-</span> <span class="n">np</span><span class="p">.</span><span class="n">mean</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">axis</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span>

    <span class="c1"># Step 2: Compute the covariance matrix
</span>    <span class="c1"># rowvar=False means columns are variables (features)
</span>    <span class="c1"># This gives us an (n_features x n_features) matrix
</span>    <span class="n">cov_matrix</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">cov</span><span class="p">(</span><span class="n">X_centered</span><span class="p">,</span> <span class="n">rowvar</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>

    <span class="c1"># Step 3: Compute eigenvalues and eigenvectors
</span>    <span class="c1"># np.linalg.eig returns eigenvalues and eigenvectors
</span>    <span class="c1"># Each column of eigenvectors corresponds to an eigenvalue
</span>    <span class="n">eigenvalues</span><span class="p">,</span> <span class="n">eigenvectors</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">linalg</span><span class="p">.</span><span class="n">eig</span><span class="p">(</span><span class="n">cov_matrix</span><span class="p">)</span>

    <span class="c1"># Step 4: Sort by eigenvalue (descending)
</span>    <span class="c1"># Largest eigenvalue = most variance = first PC
</span>    <span class="n">sorted_indices</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">argsort</span><span class="p">(</span><span class="n">eigenvalues</span><span class="p">)[::</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span>
    <span class="n">eigenvalues</span> <span class="o">=</span> <span class="n">eigenvalues</span><span class="p">[</span><span class="n">sorted_indices</span><span class="p">]</span>
    <span class="n">eigenvectors</span> <span class="o">=</span> <span class="n">eigenvectors</span><span class="p">[:,</span> <span class="n">sorted_indices</span><span class="p">]</span>

    <span class="c1"># Step 5: Project data onto top principal components
</span>    <span class="c1"># This transforms our data from n_features dimensions to n_components
</span>    <span class="n">principal_components</span> <span class="o">=</span> <span class="n">eigenvectors</span><span class="p">[:,</span> <span class="p">:</span><span class="n">n_components</span><span class="p">]</span>
    <span class="n">X_pca</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">dot</span><span class="p">(</span><span class="n">X_centered</span><span class="p">,</span> <span class="n">principal_components</span><span class="p">)</span>

    <span class="k">return</span> <span class="n">X_pca</span><span class="p">,</span> <span class="n">eigenvalues</span><span class="p">,</span> <span class="n">eigenvectors</span>
</code></pre></div></div>

<p><strong>What happens if you change this?</strong> If you skip centering the data, your principal components will be biased toward the mean location rather than capturing variance. Always center first.</p>

<h3 id="application-european-food-consumption">Application: European Food Consumption</h3>

<p>We have data on food consumption across 16 European countries and 20 food items. Each cell is a consumption value (higher = more popular).</p>

<p><a href="/assets/data/food-consumption-sample.csv">Download the sample data</a></p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># Load the data
</span><span class="n">data</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">read_csv</span><span class="p">(</span><span class="s">"food-consumption.csv"</span><span class="p">)</span>
<span class="n">countries</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span><span class="s">'Country'</span><span class="p">]</span>
<span class="n">food_items</span> <span class="o">=</span> <span class="n">data</span><span class="p">.</span><span class="n">columns</span><span class="p">[</span><span class="mi">1</span><span class="p">:]</span>
<span class="n">X</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span><span class="n">food_items</span><span class="p">].</span><span class="n">values</span>

<span class="c1"># Run PCA
</span><span class="n">X_pca</span><span class="p">,</span> <span class="n">eigenvalues</span><span class="p">,</span> <span class="n">eigenvectors</span> <span class="o">=</span> <span class="n">perform_pca</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">n_components</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>

<span class="c1"># Plot countries in PC space
</span><span class="n">plt</span><span class="p">.</span><span class="n">figure</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">10</span><span class="p">,</span> <span class="mi">8</span><span class="p">))</span>
<span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">country</span> <span class="ow">in</span> <span class="nb">enumerate</span><span class="p">(</span><span class="n">countries</span><span class="p">):</span>
    <span class="n">plt</span><span class="p">.</span><span class="n">scatter</span><span class="p">(</span><span class="n">X_pca</span><span class="p">[</span><span class="n">i</span><span class="p">,</span> <span class="mi">0</span><span class="p">],</span> <span class="n">X_pca</span><span class="p">[</span><span class="n">i</span><span class="p">,</span> <span class="mi">1</span><span class="p">])</span>
    <span class="n">plt</span><span class="p">.</span><span class="n">annotate</span><span class="p">(</span><span class="n">country</span><span class="p">,</span> <span class="p">(</span><span class="n">X_pca</span><span class="p">[</span><span class="n">i</span><span class="p">,</span> <span class="mi">0</span><span class="p">],</span> <span class="n">X_pca</span><span class="p">[</span><span class="n">i</span><span class="p">,</span> <span class="mi">1</span><span class="p">]),</span>
                 <span class="n">textcoords</span><span class="o">=</span><span class="s">"offset points"</span><span class="p">,</span> <span class="n">xytext</span><span class="o">=</span><span class="p">(</span><span class="mi">5</span><span class="p">,</span> <span class="mi">5</span><span class="p">))</span>
<span class="n">plt</span><span class="p">.</span><span class="n">xlabel</span><span class="p">(</span><span class="s">'Principal Component 1'</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">ylabel</span><span class="p">(</span><span class="s">'Principal Component 2'</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">title</span><span class="p">(</span><span class="s">'PCA of Food Consumption in European Countries'</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">grid</span><span class="p">(</span><span class="bp">True</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">show</span><span class="p">()</span>
</code></pre></div></div>

<h3 id="results">Results</h3>

<p><img src="/assets/images/posts/dimensionality-reduction/pca-countries.png" alt="PCA of European Countries by Food Consumption" /></p>

<p><em>Each point is a country, positioned by its first two principal components. The first component captures 42% of variance, the second captures 18%.</em></p>

<p>The PCA plot reveals interesting geographic patterns:</p>
<ul>
  <li><strong>Nordic countries cluster together</strong>: Sweden, Denmark, Norway, and Finland have similar diets</li>
  <li><strong>Mediterranean neighbors</strong>: France, Switzerland, and Belgium group together</li>
  <li><strong>Outliers</strong>: England and Portugal sit on opposite sides of the chart</li>
</ul>

<p>What’s interesting is that Germany and Ireland have similar diets, but Ireland and England are far apart. Geography alone doesn’t explain everything. Cultural factors matter.</p>

<p>When we flip the analysis (foods as data points, countries as features), we get another interesting view:</p>

<p><img src="/assets/images/posts/dimensionality-reduction/pca-foods.png" alt="PCA of Food Items Across European Countries" /></p>

<p><em>Each point is a food item. Garlic and olive oil appear as outliers (Mediterranean-specific). Tea and instant coffee cluster together (breakfast beverages).</em></p>

<p>Key patterns:</p>
<ul>
  <li><strong>Garlic and olive oil</strong> stand out as outliers (Mediterranean-specific)</li>
  <li><strong>Tea and coffee</strong> cluster together (common breakfast items across Europe)</li>
  <li><strong>Frozen veggies and fish</strong> are consumed similarly across countries</li>
</ul>

<h3 id="a-practical-note-on-pca">A Practical Note on PCA</h3>

<p>This is where I’ll share something from professional experience: PCA is a really cool technique, but it’s hard to explain to non-technical stakeholders.</p>

<p>Imagine showing this plot to a senior leader who wants to make a decision. They’ll ask: “What does PC1 represent in real numbers?” And you can’t give a simple answer because principal components are linear combinations of all features.</p>

<p>In practice, I’ve seen Data Science teams push back on PCA for client-facing work, no matter how good it is at finding patterns. Leadership wants to understand what the axes mean.</p>

<p><strong>When does PCA make sense?</strong></p>
<ul>
  <li>Exploratory data analysis when you have hundreds of features</li>
  <li>Finding outliers (they stand out clearly in PC space)</li>
  <li>Preprocessing before other ML algorithms (reduces noise and computation)</li>
  <li>When your audience is technical and comfortable with abstract representations</li>
</ul>

<h3 id="how-many-components-do-you-need">How Many Components Do You Need?</h3>

<p>A scree plot shows how much variance each principal component explains:</p>

<p><img src="/assets/images/posts/dimensionality-reduction/pca-variance-explained.png" alt="Variance Explained by Principal Components" /></p>

<p><em>Left: Each bar shows variance explained by one PC. Right: Cumulative variance—the first 6 components capture ~90% of the total variance.</em></p>

<p>For the food consumption data, the first two components capture about 60% of variance. That’s enough for visualization, but if you were using PCA for preprocessing, you might keep 5-6 components to retain 90%.</p>

<hr />

<h3 id="how-outliers-affect-pca">How Outliers Affect PCA</h3>

<p>Since PCA maximizes variance, outliers can dominate the principal components. They inflate the variance, and suddenly your PCs are trying to explain the outliers rather than the main data structure.</p>

<p><img src="/assets/images/posts/dimensionality-reduction/pca-outliers.png" alt="PCA with and without outliers" /></p>

<p><em>Left: With three outliers, PC1 (red) is pulled toward them. Right: Without outliers, PC1 captures the true data direction.</em></p>

<p>The takeaway: always check for outliers before running PCA, or consider robust PCA methods.</p>

<hr />

<h2 id="part-2-isomap-for-manifold-learning">Part 2: ISOMAP for Manifold Learning</h2>

<h3 id="the-problem-1">The Problem</h3>

<p>PCA assumes your data lies on a flat surface (a linear subspace). But what if your data lies on a curved surface (a manifold)?</p>

<p>Classic example: the “Swiss roll” dataset. If you unroll it, points that were close along the surface should stay close. But Euclidean distance says points on opposite sides of the roll are close, even though walking along the surface takes much longer.</p>

<p>ISOMAP solves this by preserving <strong>geodesic distances</strong> (distances along the surface) rather than straight-line distances.</p>

<h3 id="the-three-key-ideas">The Three Key Ideas</h3>

<p><strong>Plain English</strong>: ISOMAP finds the “walking distance” between points along the curved surface of your data, then flattens everything out while keeping those walking distances intact.</p>

<p><strong>Step 1: Build a neighborhood graph</strong></p>

<p>Connect each point to its neighbors (either k-nearest or all points within distance $\epsilon$). Store the actual Euclidean distances as edge weights.</p>

<p><strong>Step 2: Compute geodesic distances</strong></p>

<p>Use shortest-path algorithms (like Dijkstra’s) to find the distance between every pair of points. The key insight: for nearby points, Euclidean distance approximates geodesic distance. For far points, we chain together short hops.</p>

<p><strong>Step 3: Apply MDS</strong></p>

<p>Multidimensional Scaling takes a distance matrix and finds low-dimensional coordinates that preserve those distances. This is where the actual dimensionality reduction happens.</p>

<details>
<summary><strong>See it with a tiny example</strong></summary>
<p>Imagine 6 points along a U-shaped curve:</p>
<pre>A — B — C
        |
        D
        |
F — — — E</pre>
<p><strong>The key insight:</strong> ISOMAP assumes that if two points are close enough, Euclidean distance ≈ geodesic distance. Locally, a curved surface looks flat (like how Earth looks flat when you're standing on it).</p>
<p><strong>Euclidean distances</strong> (straight-line through space):</p>
<table>
<tr><th></th><th>A</th><th>B</th><th>C</th><th>D</th><th>E</th><th>F</th></tr>
<tr><td><strong>A</strong></td><td>0</td><td>1</td><td>2</td><td>3</td><td>3</td><td>2</td></tr>
<tr><td><strong>F</strong></td><td>2</td><td>2.2</td><td>2.8</td><td>2</td><td>1</td><td>0</td></tr>
</table>
<p>A to F = 2 (cutting across the U). But walking along the curve: A→B→C→D→E→F = 5.</p>
<p><strong>How epsilon works:</strong> Setting epsilon=1.5 means "only trust Euclidean distance for points within 1.5 units." This builds a graph with edges only between nearby points:</p>
<pre>A—B—C—D—E—F  (no shortcut A—F because 2 &gt; 1.5)</pre>
<p><strong>Geodesic distance matrix</strong> (shortest path through graph):</p>
<table>
<tr><th></th><th>A</th><th>B</th><th>C</th><th>D</th><th>E</th><th>F</th></tr>
<tr><td><strong>A</strong></td><td>0</td><td>1</td><td>2</td><td>3</td><td>4</td><td>5</td></tr>
<tr><td><strong>F</strong></td><td>5</td><td>4</td><td>3</td><td>2</td><td>1</td><td>0</td></tr>
</table>
<p>Now A to F = 5, respecting the U-shape. The graph eliminates shortcuts by only allowing steps between trusted neighbors.</p>
</details>

<h3 id="implementation-1">Implementation</h3>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="nn">scipy.spatial.distance</span> <span class="kn">import</span> <span class="n">cdist</span>
<span class="kn">from</span> <span class="nn">scipy.sparse.csgraph</span> <span class="kn">import</span> <span class="n">shortest_path</span>

<span class="k">def</span> <span class="nf">isomap</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">epsilon</span><span class="o">=</span><span class="mi">20</span><span class="p">,</span> <span class="n">n_components</span><span class="o">=</span><span class="mi">2</span><span class="p">):</span>
    <span class="s">"""
    ISOMAP dimensionality reduction.

    X: data matrix (n_samples, n_features)
    epsilon: neighborhood radius for building the graph
    n_components: target dimensionality
    """</span>
    <span class="n">n_samples</span> <span class="o">=</span> <span class="n">X</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>

    <span class="c1"># Step 1: Compute pairwise Euclidean distances
</span>    <span class="n">dist_matrix</span> <span class="o">=</span> <span class="n">cdist</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">X</span><span class="p">,</span> <span class="n">metric</span><span class="o">=</span><span class="s">'euclidean'</span><span class="p">)</span>

    <span class="c1"># Step 2: Build epsilon-neighborhood graph
</span>    <span class="c1"># Keep distances only where they're within epsilon
</span>    <span class="n">adjacency</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">zeros_like</span><span class="p">(</span><span class="n">dist_matrix</span><span class="p">)</span>
    <span class="n">adjacency</span><span class="p">[</span><span class="n">dist_matrix</span> <span class="o">&lt;</span> <span class="n">epsilon</span><span class="p">]</span> <span class="o">=</span> <span class="n">dist_matrix</span><span class="p">[</span><span class="n">dist_matrix</span> <span class="o">&lt;</span> <span class="n">epsilon</span><span class="p">]</span>
    <span class="n">np</span><span class="p">.</span><span class="n">fill_diagonal</span><span class="p">(</span><span class="n">adjacency</span><span class="p">,</span> <span class="mi">0</span><span class="p">)</span>  <span class="c1"># No self-loops
</span>
    <span class="c1"># Step 3: Compute shortest paths (geodesic distances)
</span>    <span class="c1"># This uses Dijkstra's algorithm under the hood
</span>    <span class="n">geodesic_dist</span> <span class="o">=</span> <span class="n">shortest_path</span><span class="p">(</span><span class="n">adjacency</span><span class="p">,</span> <span class="n">directed</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>

    <span class="c1"># Step 4: Apply classical MDS
</span>    <span class="c1"># Double-center the squared distance matrix
</span>    <span class="n">D_sq</span> <span class="o">=</span> <span class="n">geodesic_dist</span> <span class="o">**</span> <span class="mi">2</span>
    <span class="n">m</span> <span class="o">=</span> <span class="n">D_sq</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
    <span class="n">H</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">eye</span><span class="p">(</span><span class="n">m</span><span class="p">)</span> <span class="o">-</span> <span class="n">np</span><span class="p">.</span><span class="n">ones</span><span class="p">((</span><span class="n">m</span><span class="p">,</span> <span class="n">m</span><span class="p">))</span> <span class="o">/</span> <span class="n">m</span>  <span class="c1"># Centering matrix
</span>    <span class="n">G</span> <span class="o">=</span> <span class="o">-</span><span class="mf">0.5</span> <span class="o">*</span> <span class="n">np</span><span class="p">.</span><span class="n">dot</span><span class="p">(</span><span class="n">H</span><span class="p">,</span> <span class="n">np</span><span class="p">.</span><span class="n">dot</span><span class="p">(</span><span class="n">D_sq</span><span class="p">,</span> <span class="n">H</span><span class="p">))</span>  <span class="c1"># Gram matrix
</span>
    <span class="c1"># Step 5: Eigendecomposition of G
</span>    <span class="c1"># Use eigh for symmetric matrices (more stable than eig)
</span>    <span class="n">eigenvalues</span><span class="p">,</span> <span class="n">eigenvectors</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">linalg</span><span class="p">.</span><span class="n">eigh</span><span class="p">(</span><span class="n">G</span><span class="p">)</span>

    <span class="c1"># Sort descending
</span>    <span class="n">sorted_indices</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">argsort</span><span class="p">(</span><span class="n">eigenvalues</span><span class="p">)[::</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span>
    <span class="n">eigenvalues</span> <span class="o">=</span> <span class="n">eigenvalues</span><span class="p">[</span><span class="n">sorted_indices</span><span class="p">]</span>
    <span class="n">eigenvectors</span> <span class="o">=</span> <span class="n">eigenvectors</span><span class="p">[:,</span> <span class="n">sorted_indices</span><span class="p">]</span>

    <span class="c1"># Step 6: Compute embedding coordinates
</span>    <span class="c1"># Z = V * sqrt(Lambda) for top k components
</span>    <span class="n">Z</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">dot</span><span class="p">(</span><span class="n">eigenvectors</span><span class="p">[:,</span> <span class="p">:</span><span class="n">n_components</span><span class="p">],</span>
               <span class="n">np</span><span class="p">.</span><span class="n">diag</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="n">sqrt</span><span class="p">(</span><span class="n">eigenvalues</span><span class="p">[:</span><span class="n">n_components</span><span class="p">])))</span>

    <span class="k">return</span> <span class="n">Z</span>
</code></pre></div></div>

<p><strong>What happens if you change epsilon?</strong> Too small, and the graph becomes disconnected (infinite geodesic distances between components). Too large, and you’re basically doing PCA since everything is connected directly. You want epsilon small enough to respect the manifold curvature but large enough to keep the graph connected.</p>

<p>The original ISOMAP paper by Tenenbaum, de Silva, &amp; Langford (2000) demonstrated this algorithm on exactly this kind of face image data, showing how it discovers the underlying pose and expression parameters from raw pixels. See the <a href="#references">References</a> section for the full citation.</p>

<h3 id="application-face-image-manifold">Application: Face Image Manifold</h3>

<p>We have 698 face images, each 64x64 pixels (4096 dimensions). The faces show the same person from different angles and with different expressions. Even though the raw data is 4096-dimensional, the actual degrees of freedom are much lower (head angle, expression, lighting).</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="nn">scipy.io</span> <span class="kn">import</span> <span class="n">loadmat</span>

<span class="c1"># Load face images
</span><span class="n">mat_data</span> <span class="o">=</span> <span class="n">loadmat</span><span class="p">(</span><span class="s">'isomap.mat'</span><span class="p">)</span>
<span class="n">images</span> <span class="o">=</span> <span class="n">mat_data</span><span class="p">[</span><span class="s">'images'</span><span class="p">].</span><span class="n">T</span>  <span class="c1"># Shape: (698, 4096)
</span>
<span class="c1"># Run ISOMAP
</span><span class="n">Z</span> <span class="o">=</span> <span class="n">isomap</span><span class="p">(</span><span class="n">images</span><span class="p">,</span> <span class="n">epsilon</span><span class="o">=</span><span class="mi">20</span><span class="p">,</span> <span class="n">n_components</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>

<span class="c1"># Plot the embedding
</span><span class="n">plt</span><span class="p">.</span><span class="n">figure</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">10</span><span class="p">,</span> <span class="mi">8</span><span class="p">))</span>
<span class="n">plt</span><span class="p">.</span><span class="n">scatter</span><span class="p">(</span><span class="n">Z</span><span class="p">[:,</span> <span class="mi">0</span><span class="p">],</span> <span class="n">Z</span><span class="p">[:,</span> <span class="mi">1</span><span class="p">],</span> <span class="n">s</span><span class="o">=</span><span class="mi">10</span><span class="p">,</span> <span class="n">c</span><span class="o">=</span><span class="s">'blue'</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">title</span><span class="p">(</span><span class="s">"ISOMAP 2D Embedding of Face Images"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">xlabel</span><span class="p">(</span><span class="s">"Component 1"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">ylabel</span><span class="p">(</span><span class="s">"Component 2"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">show</span><span class="p">()</span>
</code></pre></div></div>

<p><img src="/assets/images/posts/dimensionality-reduction/isomap-faces.png" alt="ISOMAP Embedding of Face Images" /></p>

<p><em>698 face images reduced to 2D using ISOMAP. Each point is a face image.</em></p>

<p>When we overlay actual face thumbnails on the embedding, the manifold structure becomes visible:</p>

<p><img src="/assets/images/posts/dimensionality-reduction/isomap-faces-thumbnails.png" alt="ISOMAP with Face Thumbnails" /></p>

<p><em>Face thumbnails overlaid on the ISOMAP embedding. Faces looking in similar directions cluster together.</em></p>

<p>Looking at the embedding, you can see that:</p>
<ul>
  <li>Faces looking left cluster on one side, faces looking right on the other</li>
  <li>Faces with similar expressions are nearby</li>
  <li>The embedding captures the underlying structure of head pose and expression</li>
</ul>

<p>This is the key result from the original ISOMAP paper. The algorithm discovers that the face images, despite living in 4096-dimensional pixel space, actually lie on a low-dimensional manifold parameterized by pose and expression.</p>

<h3 id="isomap-vs-pca">ISOMAP vs PCA</h3>

<p>Running PCA on the same face images gives a similar overall shape, but ISOMAP does a better job spreading out faces that look different. PCA sometimes groups dissimilar faces because they happen to have similar pixel values, while ISOMAP respects the manifold structure.</p>

<p>That said, both methods struggle with the same edge cases. Two faces looking downward might be placed far apart because the algorithm can’t capture that semantic similarity from pixel data alone.</p>

<p>The limitation here isn’t the algorithm. It’s that pixel-level distance is an imperfect proxy for “face similarity.”</p>

<hr />

<h2 id="part-3-eigenfaces-for-face-recognition">Part 3: Eigenfaces for Face Recognition</h2>

<h3 id="the-problem-2">The Problem</h3>

<p>Given a database of face images for different people, can we identify who’s in a new image?</p>

<p>The eigenfaces approach treats this as dimensionality reduction followed by nearest-neighbor matching. We project all faces onto a low-dimensional “face space” and compare distances.</p>

<h3 id="how-it-works">How It Works</h3>

<ol>
  <li><strong>Collect training images</strong> for each person</li>
  <li><strong>Compute eigenfaces</strong> (principal components of the face images)</li>
  <li><strong>Project all faces</strong> onto the eigenface basis</li>
  <li><strong>For a new face</strong>: project it and find the nearest known face</li>
</ol>

<p>The eigenfaces themselves are eigenvectors of the covariance matrix of face images. When visualized as images, they look like ghostly faces that capture different aspects of variation (lighting, expression, facial features).</p>

<p>Here’s what the Yale Face dataset looks like. Each subject has multiple images with different expressions and lighting:</p>

<p><img src="/assets/images/posts/dimensionality-reduction/subject1-gallery.png" alt="Subject 1 Training Images Gallery" /></p>

<p><em>Subject 1 training images: Each row shows the same person with different expressions (glasses, happy, leftlight, noglasses, normal, rightlight, sad, sleepy, surprised, wink).</em></p>

<p>The eigenfaces algorithm needs this variation to learn what makes a face recognizable across different conditions.</p>

<h3 id="implementation-2">Implementation</h3>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="nn">PIL</span> <span class="kn">import</span> <span class="n">Image</span>
<span class="kn">import</span> <span class="nn">os</span>

<span class="k">def</span> <span class="nf">load_face_images</span><span class="p">(</span><span class="n">directory</span><span class="p">,</span> <span class="n">subject_prefix</span><span class="p">,</span> <span class="n">downsample</span><span class="o">=</span><span class="mi">4</span><span class="p">):</span>
    <span class="s">"""
    Load and preprocess face images for one subject.
    Converts to grayscale and downsamples.
    """</span>
    <span class="n">images</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">filename</span> <span class="ow">in</span> <span class="n">os</span><span class="p">.</span><span class="n">listdir</span><span class="p">(</span><span class="n">directory</span><span class="p">):</span>
        <span class="k">if</span> <span class="n">filename</span><span class="p">.</span><span class="n">startswith</span><span class="p">(</span><span class="n">subject_prefix</span><span class="p">)</span> <span class="ow">and</span> <span class="n">filename</span><span class="p">.</span><span class="n">endswith</span><span class="p">(</span><span class="s">'.gif'</span><span class="p">):</span>
            <span class="k">if</span> <span class="s">'test'</span> <span class="ow">in</span> <span class="n">filename</span><span class="p">:</span>
                <span class="k">continue</span>  <span class="c1"># Skip test images for training
</span>
            <span class="n">img_path</span> <span class="o">=</span> <span class="n">os</span><span class="p">.</span><span class="n">path</span><span class="p">.</span><span class="n">join</span><span class="p">(</span><span class="n">directory</span><span class="p">,</span> <span class="n">filename</span><span class="p">)</span>
            <span class="k">with</span> <span class="n">Image</span><span class="p">.</span><span class="nb">open</span><span class="p">(</span><span class="n">img_path</span><span class="p">)</span> <span class="k">as</span> <span class="n">img</span><span class="p">:</span>
                <span class="c1"># Convert to grayscale (1 channel instead of 3)
</span>                <span class="n">img</span> <span class="o">=</span> <span class="n">img</span><span class="p">.</span><span class="n">convert</span><span class="p">(</span><span class="s">'L'</span><span class="p">)</span>
                <span class="c1"># Downsample by factor of 4
</span>                <span class="n">width</span><span class="p">,</span> <span class="n">height</span> <span class="o">=</span> <span class="n">img</span><span class="p">.</span><span class="n">size</span>
                <span class="n">img</span> <span class="o">=</span> <span class="n">img</span><span class="p">.</span><span class="n">resize</span><span class="p">((</span><span class="n">width</span> <span class="o">//</span> <span class="n">downsample</span><span class="p">,</span> <span class="n">height</span> <span class="o">//</span> <span class="n">downsample</span><span class="p">))</span>
                <span class="c1"># Flatten to vector
</span>                <span class="n">images</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="n">array</span><span class="p">(</span><span class="n">img</span><span class="p">).</span><span class="n">flatten</span><span class="p">())</span>

    <span class="k">return</span> <span class="n">np</span><span class="p">.</span><span class="n">array</span><span class="p">(</span><span class="n">images</span><span class="p">)</span>

<span class="k">def</span> <span class="nf">compute_eigenfaces</span><span class="p">(</span><span class="n">images</span><span class="p">,</span> <span class="n">n_components</span><span class="o">=</span><span class="mi">6</span><span class="p">):</span>
    <span class="s">"""
    Compute eigenfaces (principal components) for a set of face images.
    """</span>
    <span class="c1"># Center the data
</span>    <span class="n">mean_face</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">mean</span><span class="p">(</span><span class="n">images</span><span class="p">,</span> <span class="n">axis</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span>
    <span class="n">centered</span> <span class="o">=</span> <span class="n">images</span> <span class="o">-</span> <span class="n">mean_face</span>

    <span class="c1"># PCA
</span>    <span class="n">cov_matrix</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">cov</span><span class="p">(</span><span class="n">centered</span><span class="p">,</span> <span class="n">rowvar</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
    <span class="n">eigenvalues</span><span class="p">,</span> <span class="n">eigenvectors</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">linalg</span><span class="p">.</span><span class="n">eig</span><span class="p">(</span><span class="n">cov_matrix</span><span class="p">)</span>

    <span class="c1"># Sort and select top components
</span>    <span class="n">sorted_indices</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">argsort</span><span class="p">(</span><span class="n">eigenvalues</span><span class="p">)[::</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span>
    <span class="n">eigenfaces</span> <span class="o">=</span> <span class="n">eigenvectors</span><span class="p">[:,</span> <span class="n">sorted_indices</span><span class="p">][:,</span> <span class="p">:</span><span class="n">n_components</span><span class="p">].</span><span class="n">T</span>

    <span class="k">return</span> <span class="n">eigenfaces</span><span class="p">,</span> <span class="n">mean_face</span>

<span class="k">def</span> <span class="nf">recognize_face</span><span class="p">(</span><span class="n">test_image</span><span class="p">,</span> <span class="n">eigenfaces</span><span class="p">,</span> <span class="n">mean_face</span><span class="p">):</span>
    <span class="s">"""
    Compute projection residual for face recognition.
    Lower residual = better match.
    """</span>
    <span class="c1"># Center the test image
</span>    <span class="n">centered_test</span> <span class="o">=</span> <span class="n">test_image</span> <span class="o">-</span> <span class="n">mean_face</span>

    <span class="c1"># Project onto eigenfaces and reconstruct
</span>    <span class="n">projection</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">dot</span><span class="p">(</span><span class="n">eigenfaces</span><span class="p">.</span><span class="n">T</span><span class="p">,</span> <span class="n">np</span><span class="p">.</span><span class="n">dot</span><span class="p">(</span><span class="n">eigenfaces</span><span class="p">,</span> <span class="n">centered_test</span><span class="p">))</span>

    <span class="c1"># Compute residual (reconstruction error)
</span>    <span class="n">residual</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">linalg</span><span class="p">.</span><span class="n">norm</span><span class="p">(</span><span class="n">centered_test</span> <span class="o">-</span> <span class="n">projection</span><span class="p">)</span> <span class="o">**</span> <span class="mi">2</span>

    <span class="k">return</span> <span class="n">residual</span>
</code></pre></div></div>

<p><strong>What happens if you change n_components?</strong> More eigenfaces capture more detail but also more noise. For face recognition, 6-10 eigenfaces often work well. Too few and you lose distinguishing features; too many and you start fitting to noise.</p>

<h3 id="results-on-yale-face-dataset">Results on Yale Face Dataset</h3>

<p>Testing with two subjects from the Yale Face dataset:</p>

<table>
  <thead>
    <tr>
      <th>Test Image</th>
      <th>Subject 1 Eigenfaces</th>
      <th>Subject 2 Eigenfaces</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Subject 1 Test</td>
      <td><strong>0.27</strong> (low, good match)</td>
      <td>1.00 (high, poor match)</td>
    </tr>
    <tr>
      <td>Subject 2 Test</td>
      <td>0.56 (moderate)</td>
      <td>0.71 (moderate)</td>
    </tr>
  </tbody>
</table>

<p>Subject 1’s test image matches well with Subject 1’s eigenfaces (low residual) and poorly with Subject 2’s (high residual). Good.</p>

<p>Subject 2’s test image has higher residuals overall, suggesting the eigenfaces don’t capture its variation as well. This could be improved with more training images.</p>

<h3 id="visualizing-eigenfaces">Visualizing Eigenfaces</h3>

<p>When you reshape eigenfaces back into images, you see ghostly face-like patterns:</p>

<p><img src="/assets/images/posts/dimensionality-reduction/eigenfaces-subject1.png" alt="Top 6 Eigenfaces for Subject 1" /></p>

<p><em>Top 6 eigenfaces for Subject 1. Eigenface 1 captures lighting direction. Later eigenfaces capture finer expression details.</em></p>

<p><img src="/assets/images/posts/dimensionality-reduction/eigenfaces-subject2.png" alt="Top 6 Eigenfaces for Subject 2" /></p>

<p><em>Top 6 eigenfaces for Subject 2. Similar pattern—first eigenface is the “base” lighting, later ones capture expression and glasses variations.</em></p>

<p>The mean faces show what’s “average” about each subject:</p>

<p><img src="/assets/images/posts/dimensionality-reduction/mean-faces.png" alt="Mean Faces Comparison" /></p>

<p><em>Average faces computed from training images. These are subtracted before computing eigenfaces.</em></p>

<p>What each eigenface captures:</p>
<ul>
  <li><strong>Eigenface 1</strong>: Overall face structure, usually looks like the “average” face with lighting variation</li>
  <li><strong>Eigenface 2-3</strong>: Expression and lighting differences</li>
  <li><strong>Eigenface 4-6</strong>: Finer details, often capturing glasses, hair, or subtle expressions</li>
</ul>

<p>The first eigenface captures what’s common across all images. Later eigenfaces capture what makes individual images different. This is exactly what PCA does: find the directions of maximum variance, ordered by importance.</p>

<h3 id="improving-the-algorithm">Improving the Algorithm</h3>

<p>The main limitation is training data. With only 10 images per subject, there’s not enough variation to build robust eigenfaces.</p>

<p>In production systems, you’d:</p>
<ul>
  <li><strong>Augment data</strong>: Rotate, scale, adjust lighting on existing images to create more training data</li>
  <li><strong>Use more eigenfaces</strong>: But validate on held-out data to avoid overfitting</li>
  <li><strong>Normalize for lighting</strong>: Histogram equalization or other preprocessing</li>
  <li><strong>Use deep learning</strong>: Modern face recognition (FaceNet, etc.) learns features rather than using fixed eigenfaces</li>
</ul>

<hr />

<h2 id="summary">Summary</h2>

<h3 id="pca">PCA</h3>
<ul>
  <li>Finds directions of maximum variance</li>
  <li>Eigenvalue = variance in that direction</li>
  <li>Works great for linear relationships, struggles with curved manifolds</li>
  <li>Hard to interpret for non-technical audiences</li>
</ul>

<h3 id="isomap">ISOMAP</h3>
<ul>
  <li>Preserves geodesic (walking) distances along manifolds</li>
  <li>Three steps: neighbor graph → shortest paths → MDS</li>
  <li>Better than PCA for nonlinear structure, but sensitive to epsilon parameter</li>
  <li>Computationally expensive for large datasets</li>
</ul>

<h3 id="eigenfaces">Eigenfaces</h3>
<ul>
  <li>Apply PCA to face images for recognition</li>
  <li>First few eigenfaces capture identity-related variation</li>
  <li>Simple but effective baseline; modern methods use deep learning</li>
</ul>

<h3 id="general-principles">General Principles</h3>

<ol>
  <li><strong>Always center your data</strong> before PCA or related methods</li>
  <li><strong>Check for outliers</strong> since they dominate variance-based methods</li>
  <li><strong>Validate your parameters</strong> (k for k-NN, epsilon for ISOMAP) on held-out data</li>
  <li><strong>Understand the assumptions</strong>: PCA assumes linearity, ISOMAP assumes a smooth manifold</li>
  <li><strong>Consider your audience</strong>: PCA results are hard to explain to non-technical stakeholders</li>
</ol>

<hr />

<h2 id="references">References</h2>

<p>The algorithms in this post are based on foundational papers in machine learning:</p>

<p><strong>PCA (Principal Component Analysis)</strong></p>
<ul>
  <li>Pearson, K. (1901). “On lines and planes of closest fit to systems of points in space.” <em>Philosophical Magazine</em>, 2(11), 559-572.</li>
  <li>Hotelling, H. (1933). “Analysis of a complex of statistical variables into principal components.” <em>Journal of Educational Psychology</em>, 24(6), 417-441.</li>
</ul>

<p><strong>ISOMAP</strong></p>
<ul>
  <li>Tenenbaum, J. B., de Silva, V., &amp; Langford, J. C. (2000). <a href="https://www.science.org/doi/10.1126/science.290.5500.2319">“A Global Geometric Framework for Nonlinear Dimensionality Reduction.”</a> <em>Science</em>, 290(5500), 2319-2323.</li>
</ul>

<p><strong>Eigenfaces</strong></p>
<ul>
  <li>Turk, M., &amp; Pentland, A. (1991). <a href="https://www.face-rec.org/algorithms/PCA/jcn.pdf">“Eigenfaces for Recognition.”</a> <em>Journal of Cognitive Neuroscience</em>, 3(1), 71-86.</li>
  <li>Sirovich, L., &amp; Kirby, M. (1987). “Low-dimensional procedure for the characterization of human faces.” <em>Journal of the Optical Society of America A</em>, 4(3), 519-524.</li>
</ul>

<p><strong>MDS (Multidimensional Scaling)</strong></p>
<ul>
  <li>Torgerson, W. S. (1952). “Multidimensional scaling: I. Theory and method.” <em>Psychometrika</em>, 17(4), 401-419.</li>
</ul>

<hr />

<h2 id="appendix-complete-implementations">Appendix: Complete Implementations</h2>

<h3 id="pca-implementation">PCA Implementation</h3>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">import</span> <span class="nn">pandas</span> <span class="k">as</span> <span class="n">pd</span>
<span class="kn">import</span> <span class="nn">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>

<span class="k">def</span> <span class="nf">perform_pca</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">n_components</span><span class="o">=</span><span class="mi">2</span><span class="p">):</span>
    <span class="c1"># Center the data
</span>    <span class="n">X_centered</span> <span class="o">=</span> <span class="n">X</span> <span class="o">-</span> <span class="n">np</span><span class="p">.</span><span class="n">mean</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">axis</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span>
    <span class="c1"># Compute covariance matrix
</span>    <span class="n">cov_matrix</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">cov</span><span class="p">(</span><span class="n">X_centered</span><span class="p">,</span> <span class="n">rowvar</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
    <span class="c1"># Eigendecomposition
</span>    <span class="n">eigenvalues</span><span class="p">,</span> <span class="n">eigenvectors</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">linalg</span><span class="p">.</span><span class="n">eig</span><span class="p">(</span><span class="n">cov_matrix</span><span class="p">)</span>
    <span class="c1"># Sort by eigenvalue descending
</span>    <span class="n">sorted_indices</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">argsort</span><span class="p">(</span><span class="n">eigenvalues</span><span class="p">)[::</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span>
    <span class="n">eigenvalues</span> <span class="o">=</span> <span class="n">eigenvalues</span><span class="p">[</span><span class="n">sorted_indices</span><span class="p">]</span>
    <span class="n">eigenvectors</span> <span class="o">=</span> <span class="n">eigenvectors</span><span class="p">[:,</span> <span class="n">sorted_indices</span><span class="p">]</span>
    <span class="c1"># Project onto top components
</span>    <span class="n">principal_components</span> <span class="o">=</span> <span class="n">eigenvectors</span><span class="p">[:,</span> <span class="p">:</span><span class="n">n_components</span><span class="p">]</span>
    <span class="n">X_pca</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">dot</span><span class="p">(</span><span class="n">X_centered</span><span class="p">,</span> <span class="n">principal_components</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">X_pca</span><span class="p">,</span> <span class="n">eigenvalues</span><span class="p">,</span> <span class="n">eigenvectors</span>

<span class="k">def</span> <span class="nf">plot_pca_results</span><span class="p">(</span><span class="n">X_pca</span><span class="p">,</span> <span class="n">labels</span><span class="p">,</span> <span class="n">title</span><span class="o">=</span><span class="s">"PCA Results"</span><span class="p">):</span>
    <span class="n">plt</span><span class="p">.</span><span class="n">figure</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">10</span><span class="p">,</span> <span class="mi">8</span><span class="p">))</span>
    <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">label</span> <span class="ow">in</span> <span class="nb">enumerate</span><span class="p">(</span><span class="n">labels</span><span class="p">):</span>
        <span class="n">plt</span><span class="p">.</span><span class="n">scatter</span><span class="p">(</span><span class="n">X_pca</span><span class="p">[</span><span class="n">i</span><span class="p">,</span> <span class="mi">0</span><span class="p">],</span> <span class="n">X_pca</span><span class="p">[</span><span class="n">i</span><span class="p">,</span> <span class="mi">1</span><span class="p">])</span>
        <span class="n">plt</span><span class="p">.</span><span class="n">annotate</span><span class="p">(</span><span class="n">label</span><span class="p">,</span> <span class="p">(</span><span class="n">X_pca</span><span class="p">[</span><span class="n">i</span><span class="p">,</span> <span class="mi">0</span><span class="p">],</span> <span class="n">X_pca</span><span class="p">[</span><span class="n">i</span><span class="p">,</span> <span class="mi">1</span><span class="p">]),</span>
                     <span class="n">textcoords</span><span class="o">=</span><span class="s">"offset points"</span><span class="p">,</span> <span class="n">xytext</span><span class="o">=</span><span class="p">(</span><span class="mi">5</span><span class="p">,</span> <span class="mi">5</span><span class="p">))</span>
    <span class="n">plt</span><span class="p">.</span><span class="n">xlabel</span><span class="p">(</span><span class="s">'Principal Component 1'</span><span class="p">)</span>
    <span class="n">plt</span><span class="p">.</span><span class="n">ylabel</span><span class="p">(</span><span class="s">'Principal Component 2'</span><span class="p">)</span>
    <span class="n">plt</span><span class="p">.</span><span class="n">title</span><span class="p">(</span><span class="n">title</span><span class="p">)</span>
    <span class="n">plt</span><span class="p">.</span><span class="n">grid</span><span class="p">(</span><span class="bp">True</span><span class="p">)</span>
    <span class="n">plt</span><span class="p">.</span><span class="n">show</span><span class="p">()</span>

<span class="k">def</span> <span class="nf">explained_variance_ratio</span><span class="p">(</span><span class="n">eigenvalues</span><span class="p">):</span>
    <span class="k">return</span> <span class="n">eigenvalues</span> <span class="o">/</span> <span class="n">np</span><span class="p">.</span><span class="nb">sum</span><span class="p">(</span><span class="n">eigenvalues</span><span class="p">)</span>
</code></pre></div></div>

<h3 id="isomap-implementation">ISOMAP Implementation</h3>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">from</span> <span class="nn">scipy.spatial.distance</span> <span class="kn">import</span> <span class="n">cdist</span>
<span class="kn">from</span> <span class="nn">scipy.sparse.csgraph</span> <span class="kn">import</span> <span class="n">shortest_path</span>

<span class="k">def</span> <span class="nf">isomap</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">epsilon</span><span class="o">=</span><span class="mi">20</span><span class="p">,</span> <span class="n">n_components</span><span class="o">=</span><span class="mi">2</span><span class="p">):</span>
    <span class="n">n_samples</span> <span class="o">=</span> <span class="n">X</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
    <span class="c1"># Compute pairwise Euclidean distances
</span>    <span class="n">dist_matrix</span> <span class="o">=</span> <span class="n">cdist</span><span class="p">(</span><span class="n">X</span><span class="p">,</span> <span class="n">X</span><span class="p">,</span> <span class="n">metric</span><span class="o">=</span><span class="s">'euclidean'</span><span class="p">)</span>
    <span class="c1"># Build epsilon-neighborhood graph
</span>    <span class="n">adjacency</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">zeros_like</span><span class="p">(</span><span class="n">dist_matrix</span><span class="p">)</span>
    <span class="n">adjacency</span><span class="p">[</span><span class="n">dist_matrix</span> <span class="o">&lt;</span> <span class="n">epsilon</span><span class="p">]</span> <span class="o">=</span> <span class="n">dist_matrix</span><span class="p">[</span><span class="n">dist_matrix</span> <span class="o">&lt;</span> <span class="n">epsilon</span><span class="p">]</span>
    <span class="n">np</span><span class="p">.</span><span class="n">fill_diagonal</span><span class="p">(</span><span class="n">adjacency</span><span class="p">,</span> <span class="mi">0</span><span class="p">)</span>
    <span class="c1"># Compute geodesic distances via shortest paths
</span>    <span class="n">geodesic_dist</span> <span class="o">=</span> <span class="n">shortest_path</span><span class="p">(</span><span class="n">adjacency</span><span class="p">,</span> <span class="n">directed</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
    <span class="c1"># Classical MDS
</span>    <span class="n">D_sq</span> <span class="o">=</span> <span class="n">geodesic_dist</span> <span class="o">**</span> <span class="mi">2</span>
    <span class="n">m</span> <span class="o">=</span> <span class="n">D_sq</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
    <span class="n">H</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">eye</span><span class="p">(</span><span class="n">m</span><span class="p">)</span> <span class="o">-</span> <span class="n">np</span><span class="p">.</span><span class="n">ones</span><span class="p">((</span><span class="n">m</span><span class="p">,</span> <span class="n">m</span><span class="p">))</span> <span class="o">/</span> <span class="n">m</span>
    <span class="n">G</span> <span class="o">=</span> <span class="o">-</span><span class="mf">0.5</span> <span class="o">*</span> <span class="n">np</span><span class="p">.</span><span class="n">dot</span><span class="p">(</span><span class="n">H</span><span class="p">,</span> <span class="n">np</span><span class="p">.</span><span class="n">dot</span><span class="p">(</span><span class="n">D_sq</span><span class="p">,</span> <span class="n">H</span><span class="p">))</span>
    <span class="c1"># Eigendecomposition
</span>    <span class="n">eigenvalues</span><span class="p">,</span> <span class="n">eigenvectors</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">linalg</span><span class="p">.</span><span class="n">eigh</span><span class="p">(</span><span class="n">G</span><span class="p">)</span>
    <span class="n">sorted_indices</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">argsort</span><span class="p">(</span><span class="n">eigenvalues</span><span class="p">)[::</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span>
    <span class="n">eigenvalues</span> <span class="o">=</span> <span class="n">eigenvalues</span><span class="p">[</span><span class="n">sorted_indices</span><span class="p">]</span>
    <span class="n">eigenvectors</span> <span class="o">=</span> <span class="n">eigenvectors</span><span class="p">[:,</span> <span class="n">sorted_indices</span><span class="p">]</span>
    <span class="n">eigenvalues</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">clip</span><span class="p">(</span><span class="n">eigenvalues</span><span class="p">,</span> <span class="n">a_min</span><span class="o">=</span><span class="mf">1e-10</span><span class="p">,</span> <span class="n">a_max</span><span class="o">=</span><span class="bp">None</span><span class="p">)</span>
    <span class="c1"># Compute coordinates
</span>    <span class="n">Z</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">dot</span><span class="p">(</span><span class="n">eigenvectors</span><span class="p">[:,</span> <span class="p">:</span><span class="n">n_components</span><span class="p">],</span>
               <span class="n">np</span><span class="p">.</span><span class="n">diag</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="n">sqrt</span><span class="p">(</span><span class="n">eigenvalues</span><span class="p">[:</span><span class="n">n_components</span><span class="p">])))</span>
    <span class="k">return</span> <span class="n">Z</span>
</code></pre></div></div>

<h3 id="eigenfaces-implementation">Eigenfaces Implementation</h3>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">from</span> <span class="nn">PIL</span> <span class="kn">import</span> <span class="n">Image</span>
<span class="kn">import</span> <span class="nn">os</span>
<span class="kn">import</span> <span class="nn">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>

<span class="k">def</span> <span class="nf">load_face_images</span><span class="p">(</span><span class="n">directory</span><span class="p">,</span> <span class="n">subject_prefix</span><span class="p">,</span> <span class="n">downsample</span><span class="o">=</span><span class="mi">4</span><span class="p">,</span> <span class="n">exclude_test</span><span class="o">=</span><span class="bp">True</span><span class="p">):</span>
    <span class="n">images</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="n">height</span><span class="p">,</span> <span class="n">width</span> <span class="o">=</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span>
    <span class="k">for</span> <span class="n">filename</span> <span class="ow">in</span> <span class="nb">sorted</span><span class="p">(</span><span class="n">os</span><span class="p">.</span><span class="n">listdir</span><span class="p">(</span><span class="n">directory</span><span class="p">)):</span>
        <span class="k">if</span> <span class="ow">not</span> <span class="n">filename</span><span class="p">.</span><span class="n">startswith</span><span class="p">(</span><span class="n">subject_prefix</span><span class="p">):</span>
            <span class="k">continue</span>
        <span class="k">if</span> <span class="ow">not</span> <span class="n">filename</span><span class="p">.</span><span class="n">endswith</span><span class="p">(</span><span class="s">'.gif'</span><span class="p">):</span>
            <span class="k">continue</span>
        <span class="k">if</span> <span class="n">exclude_test</span> <span class="ow">and</span> <span class="s">'test'</span> <span class="ow">in</span> <span class="n">filename</span><span class="p">:</span>
            <span class="k">continue</span>
        <span class="n">img_path</span> <span class="o">=</span> <span class="n">os</span><span class="p">.</span><span class="n">path</span><span class="p">.</span><span class="n">join</span><span class="p">(</span><span class="n">directory</span><span class="p">,</span> <span class="n">filename</span><span class="p">)</span>
        <span class="k">with</span> <span class="n">Image</span><span class="p">.</span><span class="nb">open</span><span class="p">(</span><span class="n">img_path</span><span class="p">)</span> <span class="k">as</span> <span class="n">img</span><span class="p">:</span>
            <span class="n">img</span> <span class="o">=</span> <span class="n">img</span><span class="p">.</span><span class="n">convert</span><span class="p">(</span><span class="s">'L'</span><span class="p">)</span>
            <span class="n">w</span><span class="p">,</span> <span class="n">h</span> <span class="o">=</span> <span class="n">img</span><span class="p">.</span><span class="n">size</span>
            <span class="n">img</span> <span class="o">=</span> <span class="n">img</span><span class="p">.</span><span class="n">resize</span><span class="p">((</span><span class="n">w</span> <span class="o">//</span> <span class="n">downsample</span><span class="p">,</span> <span class="n">h</span> <span class="o">//</span> <span class="n">downsample</span><span class="p">))</span>
            <span class="n">height</span><span class="p">,</span> <span class="n">width</span> <span class="o">=</span> <span class="n">img</span><span class="p">.</span><span class="n">size</span><span class="p">[</span><span class="mi">1</span><span class="p">],</span> <span class="n">img</span><span class="p">.</span><span class="n">size</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
            <span class="n">images</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="n">array</span><span class="p">(</span><span class="n">img</span><span class="p">).</span><span class="n">flatten</span><span class="p">())</span>
    <span class="k">return</span> <span class="n">np</span><span class="p">.</span><span class="n">array</span><span class="p">(</span><span class="n">images</span><span class="p">),</span> <span class="n">height</span><span class="p">,</span> <span class="n">width</span>

<span class="k">def</span> <span class="nf">compute_eigenfaces</span><span class="p">(</span><span class="n">images</span><span class="p">,</span> <span class="n">n_components</span><span class="o">=</span><span class="mi">6</span><span class="p">):</span>
    <span class="n">mean_face</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">mean</span><span class="p">(</span><span class="n">images</span><span class="p">,</span> <span class="n">axis</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span>
    <span class="n">centered</span> <span class="o">=</span> <span class="n">images</span> <span class="o">-</span> <span class="n">mean_face</span>
    <span class="n">cov_matrix</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">cov</span><span class="p">(</span><span class="n">centered</span><span class="p">,</span> <span class="n">rowvar</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
    <span class="n">eigenvalues</span><span class="p">,</span> <span class="n">eigenvectors</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">linalg</span><span class="p">.</span><span class="n">eig</span><span class="p">(</span><span class="n">cov_matrix</span><span class="p">)</span>
    <span class="n">sorted_indices</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">argsort</span><span class="p">(</span><span class="n">eigenvalues</span><span class="p">)[::</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span>
    <span class="n">eigenfaces</span> <span class="o">=</span> <span class="n">eigenvectors</span><span class="p">[:,</span> <span class="n">sorted_indices</span><span class="p">][:,</span> <span class="p">:</span><span class="n">n_components</span><span class="p">].</span><span class="n">T</span>
    <span class="k">return</span> <span class="n">eigenfaces</span><span class="p">,</span> <span class="n">mean_face</span>

<span class="k">def</span> <span class="nf">recognize_face</span><span class="p">(</span><span class="n">test_image</span><span class="p">,</span> <span class="n">eigenfaces</span><span class="p">,</span> <span class="n">mean_face</span><span class="p">):</span>
    <span class="n">centered</span> <span class="o">=</span> <span class="n">test_image</span> <span class="o">-</span> <span class="n">mean_face</span>
    <span class="n">projection</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">dot</span><span class="p">(</span><span class="n">eigenfaces</span><span class="p">.</span><span class="n">T</span><span class="p">,</span> <span class="n">np</span><span class="p">.</span><span class="n">dot</span><span class="p">(</span><span class="n">eigenfaces</span><span class="p">,</span> <span class="n">centered</span><span class="p">))</span>
    <span class="n">residual</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">linalg</span><span class="p">.</span><span class="n">norm</span><span class="p">(</span><span class="n">centered</span> <span class="o">-</span> <span class="n">projection</span><span class="p">)</span> <span class="o">**</span> <span class="mi">2</span>
    <span class="k">return</span> <span class="n">residual</span>
</code></pre></div></div>

<hr />

<p><em>PS: This work was completed at Georgia Tech. The original submission files can be provided upon request to validate that this work is entirely my own.</em></p>]]></content><author><name>Danny Tabach</name></author><category term="from-scratch" /><category term="machine-learning" /><category term="dimensionality-reduction" /><category term="pca" /><category term="isomap" /><category term="eigenfaces" /><category term="python" /><category term="numpy" /><summary type="html"><![CDATA[You have thousands of features but only care about the patterns that matter. Here’s how to find them.]]></summary></entry><entry><title type="html">US Hospital Beds: Interactive Map</title><link href="https://danieltabach.github.io/data-viz/hospital-bed-map/" rel="alternate" type="text/html" title="US Hospital Beds: Interactive Map" /><published>2020-04-01T00:00:00-04:00</published><updated>2020-04-01T00:00:00-04:00</updated><id>https://danieltabach.github.io/data-viz/hospital-bed-map</id><content type="html" xml:base="https://danieltabach.github.io/data-viz/hospital-bed-map/"><![CDATA[<p>An interactive map exploring hospital bed capacity across the United States.</p>

<div style="width: 100%; max-width: 1100px; margin: 0 auto;">
  <iframe src="https://dannytabach.shinyapps.io/COVIDShiny/" width="1100" height="1000" frameborder="0" style="border: none; display: block; margin: 0 auto;">
  </iframe>
</div>]]></content><author><name>Danny Tabach</name></author><category term="data-viz" /><category term="r" /><category term="shiny" /><category term="leaflet" /><category term="visualization" /><summary type="html"><![CDATA[An interactive map exploring hospital bed capacity across the United States.]]></summary></entry><entry><title type="html">Magnus Carlsen: A Career in Data</title><link href="https://danieltabach.github.io/data-viz/magnus-carlsen-chess-analysis/" rel="alternate" type="text/html" title="Magnus Carlsen: A Career in Data" /><published>2020-03-15T00:00:00-04:00</published><updated>2020-03-15T00:00:00-04:00</updated><id>https://danieltabach.github.io/data-viz/magnus-carlsen-chess-analysis</id><content type="html" xml:base="https://danieltabach.github.io/data-viz/magnus-carlsen-chess-analysis/"><![CDATA[<p>An interactive exploration of Magnus Carlsen’s chess career through data visualization.</p>

<div class="tableauPlaceholder" style="width: 100%; max-width: 1100px; margin: 0 auto;">
  <iframe src="https://public.tableau.com/views/MagnusCarlsenACaseStudy/Dashboard1?:embed=y&amp;:showVizHome=no&amp;:toolbar=no" width="1100" height="2400" frameborder="0" style="border: none; display: block; margin: 0 auto;">
  </iframe>
</div>]]></content><author><name>Danny Tabach</name></author><category term="data-viz" /><category term="tableau" /><category term="visualization" /><category term="chess" /><summary type="html"><![CDATA[An interactive exploration of Magnus Carlsen’s chess career through data visualization.]]></summary></entry><entry><title type="html">Measuring Urbanicity with Hospital Data: A Distance-Based Approach</title><link href="https://danieltabach.github.io/applied/geospatial-clustering-urbanicity/" rel="alternate" type="text/html" title="Measuring Urbanicity with Hospital Data: A Distance-Based Approach" /><published>2020-02-07T00:00:00-05:00</published><updated>2020-02-07T00:00:00-05:00</updated><id>https://danieltabach.github.io/applied/geospatial-clustering-urbanicity</id><content type="html" xml:base="https://danieltabach.github.io/applied/geospatial-clustering-urbanicity/"><![CDATA[<p><em>How do you measure how “urban” an area is without census data? Here’s one approach: look at where the hospitals are.</em></p>

<hr />

<h2 id="introduction">Introduction</h2>

<p>If you ask someone whether New York City is “urban,” they’ll say yes without hesitation. But what about Orlando? Kansas City? Rochester? As a percentage, how urban are these places?</p>

<p>There’s no single right answer. “Urbanicity” is fuzzy. Census definitions exist, but they’re based on administrative boundaries that don’t always match reality. Population density helps, but a suburban apartment complex might have higher density than a small downtown.</p>

<p>This project explores a different proxy: <strong>hospital locations</strong>.</p>

<p>The hypothesis is simple. Hospitals are expensive to build and maintain. They only exist where there’s enough population to support them. So the distance between hospitals tells us something about the population density between them.</p>

<p><strong>What we’ll build:</strong></p>
<ul>
  <li>A distance matrix between all hospitals in the US</li>
  <li>A classification scheme based on hospital proximity</li>
  <li>An improved method using k-nearest neighbors</li>
  <li>Maps comparing the two approaches</li>
</ul>

<hr />

<h2 id="the-hypothesis">The Hypothesis</h2>

<p>If two hospitals are 30 miles apart, we can infer there isn’t enough population between them to justify building another hospital. If they’re 300 meters apart, we’re probably in a dense urban core.</p>

<p>By measuring the distances between hospitals and clustering them, we might be able to create an “urbanicity score” that reflects reality better than arbitrary administrative boundaries.</p>

<p>This won’t be perfect. But it might be useful.</p>

<hr />

<h2 id="the-data">The Data</h2>

<p>Hospital location data is available from the <a href="https://hifld-geoplatform.opendata.arcgis.com/datasets/hospitals">HIFLD Open Data portal</a>. The dataset includes over 7,000 hospitals with latitude/longitude coordinates, bed counts, facility type, and operational status.</p>

<div class="language-r highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">library</span><span class="p">(</span><span class="n">tidyverse</span><span class="p">)</span><span class="w">
</span><span class="n">library</span><span class="p">(</span><span class="n">ggmap</span><span class="p">)</span><span class="w">      </span><span class="c1"># For Google Maps integration</span><span class="w">
</span><span class="n">library</span><span class="p">(</span><span class="n">geosphere</span><span class="p">)</span><span class="w">  </span><span class="c1"># For distance calculations</span><span class="w">
</span><span class="n">library</span><span class="p">(</span><span class="n">sp</span><span class="p">)</span><span class="w">         </span><span class="c1"># For spatial data handling</span><span class="w">

</span><span class="c1"># Load hospital data</span><span class="w">
</span><span class="n">hospitals</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">read.csv</span><span class="p">(</span><span class="s2">"hospitals.csv"</span><span class="p">)</span><span class="w">

</span><span class="c1"># Filter to open hospitals with valid coordinates</span><span class="w">
</span><span class="n">hospitals</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">hospitals</span><span class="w"> </span><span class="o">%&gt;%</span><span class="w">
  </span><span class="n">filter</span><span class="p">(</span><span class="n">STATUS</span><span class="w"> </span><span class="o">==</span><span class="w"> </span><span class="s2">"OPEN"</span><span class="p">)</span><span class="w"> </span><span class="o">%&gt;%</span><span class="w">
  </span><span class="n">filter</span><span class="p">(</span><span class="o">!</span><span class="nf">is.na</span><span class="p">(</span><span class="n">X</span><span class="p">)</span><span class="w"> </span><span class="o">&amp;</span><span class="w"> </span><span class="o">!</span><span class="nf">is.na</span><span class="p">(</span><span class="n">Y</span><span class="p">))</span><span class="w"> </span><span class="o">%&gt;%</span><span class="w">
  </span><span class="n">mutate</span><span class="p">(</span><span class="n">Longitude</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">X</span><span class="p">,</span><span class="w"> </span><span class="n">Latitude</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">Y</span><span class="p">)</span><span class="w">

</span><span class="c1"># Handle beds column (some have -999 as NA placeholder)</span><span class="w">
</span><span class="n">hospitals</span><span class="o">$</span><span class="n">BEDS</span><span class="p">[</span><span class="n">hospitals</span><span class="o">$</span><span class="n">BEDS</span><span class="w"> </span><span class="o">&lt;</span><span class="w"> </span><span class="m">0</span><span class="p">]</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="kc">NA</span><span class="w">

</span><span class="n">nrow</span><span class="p">(</span><span class="n">hospitals</span><span class="p">)</span><span class="w">  </span><span class="c1"># About 7,600 open hospitals</span><span class="w">
</span></code></pre></div></div>

<p><img src="/assets/images/posts/urbanicity/us-hospitals-overview.png" alt="US Hospitals Overview" />
<em>Distribution of hospitals across the continental United States. Point size represents bed count. Notice the clustering along coasts and around major metro areas.</em></p>

<hr />

<h2 id="building-the-distance-matrix">Building the Distance Matrix</h2>

<p>The core of this analysis is a <strong>distance matrix</strong>: the distance from every hospital to every other hospital. With ~7,600 hospitals, that’s about 58 million pairwise distances.</p>

<div class="language-r highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># Extract coordinates</span><span class="w">
</span><span class="n">x</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">hospitals</span><span class="o">$</span><span class="n">Longitude</span><span class="w">
</span><span class="n">y</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">hospitals</span><span class="o">$</span><span class="n">Latitude</span><span class="w">

</span><span class="c1"># Create spatial points dataframe</span><span class="w">
</span><span class="c1"># The projection string tells R we're working with lat/long on a globe</span><span class="w">
</span><span class="n">xy</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">SpatialPointsDataFrame</span><span class="p">(</span><span class="w">
  </span><span class="n">matrix</span><span class="p">(</span><span class="nf">c</span><span class="p">(</span><span class="n">x</span><span class="p">,</span><span class="w"> </span><span class="n">y</span><span class="p">),</span><span class="w"> </span><span class="n">ncol</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">2</span><span class="p">),</span><span class="w">
  </span><span class="n">data.frame</span><span class="p">(</span><span class="n">ID</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="nf">seq_along</span><span class="p">(</span><span class="n">x</span><span class="p">)),</span><span class="w">
  </span><span class="n">proj4string</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">CRS</span><span class="p">(</span><span class="s2">"+proj=longlat +ellps=WGS84 +datum=WGS84"</span><span class="p">)</span><span class="w">
</span><span class="p">)</span><span class="w">

</span><span class="c1"># Calculate all pairwise distances (in meters)</span><span class="w">
</span><span class="c1"># distm handles spherical geometry - it knows the Earth is round</span><span class="w">
</span><span class="n">mdist</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">distm</span><span class="p">(</span><span class="n">xy</span><span class="p">)</span><span class="w">

</span><span class="c1"># Label rows and columns</span><span class="w">
</span><span class="n">colnames</span><span class="p">(</span><span class="n">mdist</span><span class="p">)</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">hospitals</span><span class="o">$</span><span class="n">ADDRESS</span><span class="w">
</span><span class="n">rownames</span><span class="p">(</span><span class="n">mdist</span><span class="p">)</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">hospitals</span><span class="o">$</span><span class="n">ADDRESS</span><span class="w">
</span></code></pre></div></div>

<p><strong>What happens if you change the coordinate system?</strong> Using <code class="language-plaintext highlighter-rouge">distm</code> from the <code class="language-plaintext highlighter-rouge">geosphere</code> package calculates great-circle distances on a sphere. Simple Euclidean distance on lat/long would be wrong because degrees of longitude shrink as you move toward the poles.</p>

<details>
<summary><strong>See it with a tiny example</strong></summary>

<p>Imagine 4 hospitals: A, B, C, D positioned in 2D space:</p>

![Distance Matrix Example](/assets/images/posts/urbanicity/distance-matrix-example.png)

<p>The distance matrix captures all pairwise distances. The diagonal is always 0 (distance from a hospital to itself). The matrix is symmetric because distance(A→B) = distance(B→A).</p>

<p>From this matrix, we can find:</p>
<ul>
<li>Hospital A's closest neighbor is B (2.0 km)</li>
<li>Hospital D is the most isolated (minimum distance 5.0 km to C)</li>
</ul>

</details>

<hr />

<h2 id="first-attempt-single-minimum-distance">First Attempt: Single Minimum Distance</h2>

<p>The simplest approach: for each hospital, find the distance to its nearest neighbor. Classify based on that distance.</p>

<div class="language-r highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># Replace diagonal with Inf (so we don't pick "distance to self")</span><span class="w">
</span><span class="n">mdist2</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">mdist</span><span class="w">
</span><span class="n">diag</span><span class="p">(</span><span class="n">mdist2</span><span class="p">)</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="kc">Inf</span><span class="w">

</span><span class="c1"># Find minimum distance for each hospital</span><span class="w">
</span><span class="n">min_distances</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">apply</span><span class="p">(</span><span class="n">mdist2</span><span class="p">,</span><span class="w"> </span><span class="m">1</span><span class="p">,</span><span class="w"> </span><span class="n">min</span><span class="p">)</span><span class="w">

</span><span class="c1"># Classification thresholds (in meters)</span><span class="w">
</span><span class="c1"># These are hypothesis-driven, not validated</span><span class="w">
</span><span class="n">hospitals</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">hospitals</span><span class="w"> </span><span class="o">%&gt;%</span><span class="w">
  </span><span class="n">mutate</span><span class="p">(</span><span class="w">
    </span><span class="n">MinDistance</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">min_distances</span><span class="p">,</span><span class="w">
    </span><span class="n">Classification</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">case_when</span><span class="p">(</span><span class="w">
      </span><span class="n">MinDistance</span><span class="w"> </span><span class="o">&lt;=</span><span class="w"> </span><span class="m">3000</span><span class="w">   </span><span class="o">~</span><span class="w"> </span><span class="s2">"Very Urban"</span><span class="p">,</span><span class="w">   </span><span class="c1"># &lt; 3 km</span><span class="w">
      </span><span class="n">MinDistance</span><span class="w"> </span><span class="o">&lt;=</span><span class="w"> </span><span class="m">12000</span><span class="w">  </span><span class="o">~</span><span class="w"> </span><span class="s2">"Urban"</span><span class="p">,</span><span class="w">        </span><span class="c1"># 3-12 km</span><span class="w">
      </span><span class="n">MinDistance</span><span class="w"> </span><span class="o">&lt;=</span><span class="w"> </span><span class="m">20000</span><span class="w">  </span><span class="o">~</span><span class="w"> </span><span class="s2">"Suburban"</span><span class="p">,</span><span class="w">     </span><span class="c1"># 12-20 km</span><span class="w">
      </span><span class="n">MinDistance</span><span class="w"> </span><span class="o">&lt;=</span><span class="w"> </span><span class="m">30000</span><span class="w">  </span><span class="o">~</span><span class="w"> </span><span class="s2">"Rural"</span><span class="p">,</span><span class="w">        </span><span class="c1"># 20-30 km</span><span class="w">
      </span><span class="kc">TRUE</span><span class="w">                  </span><span class="o">~</span><span class="w"> </span><span class="s2">"Very Rural"</span><span class="w">    </span><span class="c1"># &gt; 30 km</span><span class="w">
    </span><span class="p">)</span><span class="w">
  </span><span class="p">)</span><span class="w">

</span><span class="n">table</span><span class="p">(</span><span class="n">hospitals</span><span class="o">$</span><span class="n">Classification</span><span class="p">)</span><span class="w">
</span></code></pre></div></div>

<p><strong>The problem:</strong> This approach has a flaw. Two hospitals might be 100 meters apart (a hospital campus), but there’s nothing else around for miles. Using just the minimum distance, we’d label them “Very Urban” when they’re actually isolated.</p>

<p><img src="/assets/images/posts/urbanicity/classification-legend.png" alt="Classification Legend" />
<em>The classification scheme based on average distance to k nearest hospitals.</em></p>

<hr />

<h2 id="the-fix-k-nearest-neighbors">The Fix: K-Nearest Neighbors</h2>

<p>Instead of just the closest hospital, we look at the <strong>k closest</strong> and average their distances. This smooths out the noise from hospital campuses and isolated pairs.</p>

<div class="language-r highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># For each hospital, get the 5 smallest distances</span><span class="w">
</span><span class="n">k</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="m">5</span><span class="w">
</span><span class="n">sorted_distances</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">t</span><span class="p">(</span><span class="n">apply</span><span class="p">(</span><span class="n">mdist2</span><span class="p">,</span><span class="w"> </span><span class="m">1</span><span class="p">,</span><span class="w"> </span><span class="k">function</span><span class="p">(</span><span class="n">row</span><span class="p">)</span><span class="w"> </span><span class="n">sort</span><span class="p">(</span><span class="n">row</span><span class="p">)[</span><span class="m">1</span><span class="o">:</span><span class="n">k</span><span class="p">]))</span><span class="w">

</span><span class="c1"># Average the k nearest distances</span><span class="w">
</span><span class="n">mean_distances</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">rowMeans</span><span class="p">(</span><span class="n">sorted_distances</span><span class="p">)</span><span class="w">

</span><span class="c1"># Reclassify using mean distance</span><span class="w">
</span><span class="n">hospitals</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">hospitals</span><span class="w"> </span><span class="o">%&gt;%</span><span class="w">
  </span><span class="n">mutate</span><span class="p">(</span><span class="w">
    </span><span class="n">MeanDistance</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">mean_distances</span><span class="p">,</span><span class="w">
    </span><span class="n">Classification_K</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">case_when</span><span class="p">(</span><span class="w">
      </span><span class="n">MeanDistance</span><span class="w"> </span><span class="o">&lt;=</span><span class="w"> </span><span class="m">3000</span><span class="w">   </span><span class="o">~</span><span class="w"> </span><span class="s2">"Very Urban"</span><span class="p">,</span><span class="w">
      </span><span class="n">MeanDistance</span><span class="w"> </span><span class="o">&lt;=</span><span class="w"> </span><span class="m">12000</span><span class="w">  </span><span class="o">~</span><span class="w"> </span><span class="s2">"Urban"</span><span class="p">,</span><span class="w">
      </span><span class="n">MeanDistance</span><span class="w"> </span><span class="o">&lt;=</span><span class="w"> </span><span class="m">20000</span><span class="w">  </span><span class="o">~</span><span class="w"> </span><span class="s2">"Suburban"</span><span class="p">,</span><span class="w">
      </span><span class="n">MeanDistance</span><span class="w"> </span><span class="o">&lt;=</span><span class="w"> </span><span class="m">30000</span><span class="w">  </span><span class="o">~</span><span class="w"> </span><span class="s2">"Rural"</span><span class="p">,</span><span class="w">
      </span><span class="kc">TRUE</span><span class="w">                   </span><span class="o">~</span><span class="w"> </span><span class="s2">"Very Rural"</span><span class="w">
    </span><span class="p">)</span><span class="w">
  </span><span class="p">)</span><span class="w">
</span></code></pre></div></div>

<p><strong>What happens if you change k?</strong> With k=1, you get the original noisy results. Higher k values smooth things out but might miss genuinely dense pockets. k=5 seemed like a reasonable balance for this dataset.</p>

<p><img src="/assets/images/posts/urbanicity/k-sensitivity.png" alt="K Sensitivity" />
<em>How the choice of k affects classification distribution. Higher k values shift hospitals toward less urban classifications as we include more distant neighbors in the average.</em></p>

<hr />

<h2 id="comparing-the-methods">Comparing the Methods</h2>

<p>The difference between single-distance and k-nearest classification is dramatic in areas with hospital campuses.</p>

<p><img src="/assets/images/posts/urbanicity/single-vs-knearest.png" alt="Single vs K-Nearest" />
<em>New York region comparison. Left: Single minimum distance (noisy). Right: K-nearest average (smoother, more realistic).</em></p>

<p><strong>Key observations:</strong></p>
<ul>
  <li>Manhattan is uniformly “Very Urban” with k-nearest, as expected</li>
  <li>Brooklyn and Queens show a gradient, transitioning from Urban to Suburban</li>
  <li>Small clusters that appeared “Very Urban” with single-distance are correctly classified as Suburban with k-nearest</li>
</ul>

<hr />

<h2 id="regional-comparisons">Regional Comparisons</h2>

<p>Different regions show the method working as expected:</p>

<p><img src="/assets/images/posts/urbanicity/regional-comparison.png" alt="Regional Comparison" />
<em>Three regions showing urbanicity classifications. Urban cores are purple, rural areas are green.</em></p>

<p><strong>New York Metro:</strong></p>
<ul>
  <li>Manhattan: Very Urban (dense hospital network)</li>
  <li>Brooklyn/Queens: Urban to Suburban gradient</li>
  <li>Long Island suburbs: Suburban to Rural</li>
</ul>

<p><strong>Los Angeles:</strong></p>
<ul>
  <li>Downtown LA: Very Urban</li>
  <li>Sprawling suburbs: Mix of Urban and Suburban</li>
  <li>Desert edges: Rural to Very Rural</li>
</ul>

<p><strong>Montana:</strong></p>
<ul>
  <li>Few hospitals, widely spaced</li>
  <li>Almost entirely Rural to Very Rural</li>
  <li>Small clusters around cities like Billings</li>
</ul>

<hr />

<h2 id="limitations-and-extensions">Limitations and Extensions</h2>

<p>This approach has real limitations:</p>

<p><strong>What it misses:</strong></p>
<ul>
  <li><strong>Hospital type matters:</strong> Specialty hospitals (children’s, psychiatric, VA) cluster differently than general hospitals</li>
  <li><strong>Thresholds are arbitrary:</strong> Why 3km vs 4km as the Urban cutoff? These are judgment calls.</li>
  <li><strong>Static snapshot:</strong> Hospitals open and close. The data is a point in time.</li>
  <li><strong>Ignores hospital size:</strong> A 50-bed rural hospital and a 500-bed urban medical center are treated the same</li>
  <li><strong>Doesn’t account for terrain:</strong> 10km in Manhattan means something different than 10km in the Rockies</li>
</ul>

<p><strong>Possible improvements:</strong></p>
<ul>
  <li><strong>Weight by bed count:</strong> Larger hospitals serve larger populations</li>
  <li><strong>Use drive time instead of straight-line distance:</strong> More realistic for healthcare access</li>
  <li><strong>Incorporate other infrastructure:</strong> Fire stations, schools, grocery stores</li>
  <li><strong>Validate against census urbanicity measures:</strong> See how well this proxy actually works</li>
  <li><strong>Try different k values:</strong> Build a sensitivity analysis</li>
</ul>

<p><strong>What this could be useful for:</strong></p>
<ul>
  <li>Quick urbanicity estimates for areas without recent census data</li>
  <li>Identifying underserved areas (long distances to hospitals)</li>
  <li>Retail site selection (hospital density correlates with commercial activity)</li>
  <li>Academic research on healthcare access disparities</li>
</ul>

<hr />

<h2 id="summary">Summary</h2>

<ol>
  <li>
    <p><strong>Hospital distances can proxy for urbanicity.</strong> Dense hospital clusters indicate dense populations.</p>
  </li>
  <li>
    <p><strong>Single minimum distance is noisy.</strong> Two hospitals on the same campus can look “very urban” even in rural areas.</p>
  </li>
  <li>
    <p><strong>K-nearest averaging smooths the noise.</strong> Looking at the 5 nearest hospitals gives a more realistic picture.</p>
  </li>
  <li>
    <p><strong>The thresholds are hypotheses, not facts.</strong> The 3km/12km/20km/30km boundaries were chosen based on intuition, not rigorous validation.</p>
  </li>
  <li>
    <p><strong>Maps tell the story.</strong> The visual comparison between methods makes the improvement obvious.</p>
  </li>
</ol>

<hr />

<h2 id="data-sources">Data Sources</h2>

<p>The hospital data used in this analysis was originally from the Homeland Infrastructure Foundation-Level Data (HIFLD) open data portal, but that link has since expired. A similar dataset is available from <a href="https://dbc-6703f9ed-77e2.cloud.databricks.com/marketplace/consumer/listings/ca74bbd1-cafb-4b5a-9938-16bfd5a8b613">Rearc on the Databricks Marketplace</a>.</p>

<p>Other sources for hospital location data:</p>
<ul>
  <li><a href="https://data.cms.gov/">CMS Hospital Compare</a></li>
  <li><a href="https://www.ahadata.com/">AHA Annual Survey</a></li>
  <li><a href="https://www.definitivehc.com/">Definitive Healthcare</a></li>
</ul>

<p>For the <code class="language-plaintext highlighter-rouge">ggmap</code> package, you’ll need a Google Maps API key. See the <a href="https://cran.r-project.org/web/packages/ggmap/readme/README.html">ggmap documentation</a> for setup instructions.</p>

<hr />

<h2 id="appendix-complete-r-script">Appendix: Complete R Script</h2>

<details>
<summary><strong>Full Implementation</strong></summary>

<pre><code class="language-r"># ============================================
# Measuring Urbanicity with Hospital Distances
# ============================================

# Load packages
library(tidyverse)
library(ggmap)
library(geosphere)
library(sp)
library(matrixStats)

# ----- Load Data -----
hospitals &lt;- read.csv("hospitals.csv")

# Filter and clean
hospitals &lt;- hospitals %&gt;%
  filter(STATUS == "OPEN") %&gt;%
  filter(!is.na(X) &amp; !is.na(Y)) %&gt;%
  mutate(
    Longitude = X,
    Latitude = Y,
    BEDS = ifelse(BEDS &lt; 0, NA, BEDS)
  )

# ----- Build Distance Matrix -----
x &lt;- hospitals$Longitude
y &lt;- hospitals$Latitude

xy &lt;- SpatialPointsDataFrame(
  matrix(c(x, y), ncol = 2),
  data.frame(ID = seq_along(x)),
  proj4string = CRS("+proj=longlat +ellps=WGS84 +datum=WGS84")
)

mdist &lt;- distm(xy)
diag(mdist) &lt;- Inf

# ----- Single Distance Classification -----
min_distances &lt;- apply(mdist, 1, min)

hospitals$MinDistance &lt;- min_distances
hospitals$Class_Single &lt;- case_when(
  hospitals$MinDistance &lt;= 3000   ~ "Very Urban",
  hospitals$MinDistance &lt;= 12000  ~ "Urban",
  hospitals$MinDistance &lt;= 20000  ~ "Suburban",
  hospitals$MinDistance &lt;= 30000  ~ "Rural",
  TRUE                            ~ "Very Rural"
)

# ----- K-Nearest Classification -----
k &lt;- 5
sorted_distances &lt;- t(apply(mdist, 1, function(row) sort(row)[1:k]))
mean_distances &lt;- rowMeans(sorted_distances)

hospitals$MeanDistance &lt;- mean_distances
hospitals$Class_KNearest &lt;- case_when(
  hospitals$MeanDistance &lt;= 3000   ~ "Very Urban",
  hospitals$MeanDistance &lt;= 12000  ~ "Urban",
  hospitals$MeanDistance &lt;= 20000  ~ "Suburban",
  hospitals$MeanDistance &lt;= 30000  ~ "Rural",
  TRUE                             ~ "Very Rural"
)

# ----- Mapping -----
# Register your Google Maps API key
# register_google(key = "YOUR_API_KEY")

# Create plot data by classification
plot_urbanicity &lt;- function(location, zoom = 9) {
  basemap &lt;- ggmap(get_googlemap(center = location, zoom = zoom, maptype = "roadmap"))

  basemap +
    geom_point(
      data = hospitals,
      aes(x = Longitude, y = Latitude, fill = Class_KNearest, size = BEDS),
      pch = 21, alpha = 0.7
    ) +
    scale_fill_manual(
      values = c(
        "Very Urban" = "#7b3294",
        "Urban" = "#c2a5cf",
        "Suburban" = "#f7f7f7",
        "Rural" = "#a6dba0",
        "Very Rural" = "#008837"
      ),
      breaks = c("Very Urban", "Urban", "Suburban", "Rural", "Very Rural")
    ) +
    scale_size(range = c(1, 6), breaks = c(100, 250, 500, 1000)) +
    labs(fill = "Urbanicity", size = "Beds") +
    guides(fill = guide_legend(override.aes = list(size = 5)))
}

# Example: New York City
plot_urbanicity(c(lon = -73.987, lat = 40.745), zoom = 9)

# Example: Los Angeles
plot_urbanicity(c(lon = -118.25, lat = 34.05), zoom = 9)

# ----- Summary Statistics -----
print("Single Distance Classification:")
print(table(hospitals$Class_Single))

print("\nK-Nearest Classification (k=5):")
print(table(hospitals$Class_KNearest))
</code></pre>

</details>

<hr />

<p><em>PS: This tutorial is a remaster of work I did in early 2020, before I started my first data science role. I’ve cleaned up the code and explanations, but kept the core analysis intact. The original was rough around the edges, but it taught me a lot about translating ideas into working code.</em></p>]]></content><author><name>Danny Tabach</name></author><category term="applied" /><category term="r" /><category term="geospatial" /><category term="clustering" /><category term="ggmap" /><category term="data-visualization" /><summary type="html"><![CDATA[How do you measure how “urban” an area is without census data? Here’s one approach: look at where the hospitals are.]]></summary></entry></feed>